Что такое регулярные выражения: полный справочник по RegExp с шпаргалкой
Регулярные выражения (RegExp, regex) — специальный язык описания шаблонов строк для поиска, валидации, замены и парсинга текста. Большинство языков программирования реализует стандарт PCRE (Perl Compatible Regular Expressions): Python, JavaScript, Java, PHP и другие.
В справочнике ниже — шпаргалка синтаксиса с таблицами токенов и примеры использования регулярных выражений в Python, JS, Java и PHP.
Учитесь бесплатно за счёт государства
Экономия до 100 000 ₽ на любой программе
Что такое регулярное выражение и где оно используется
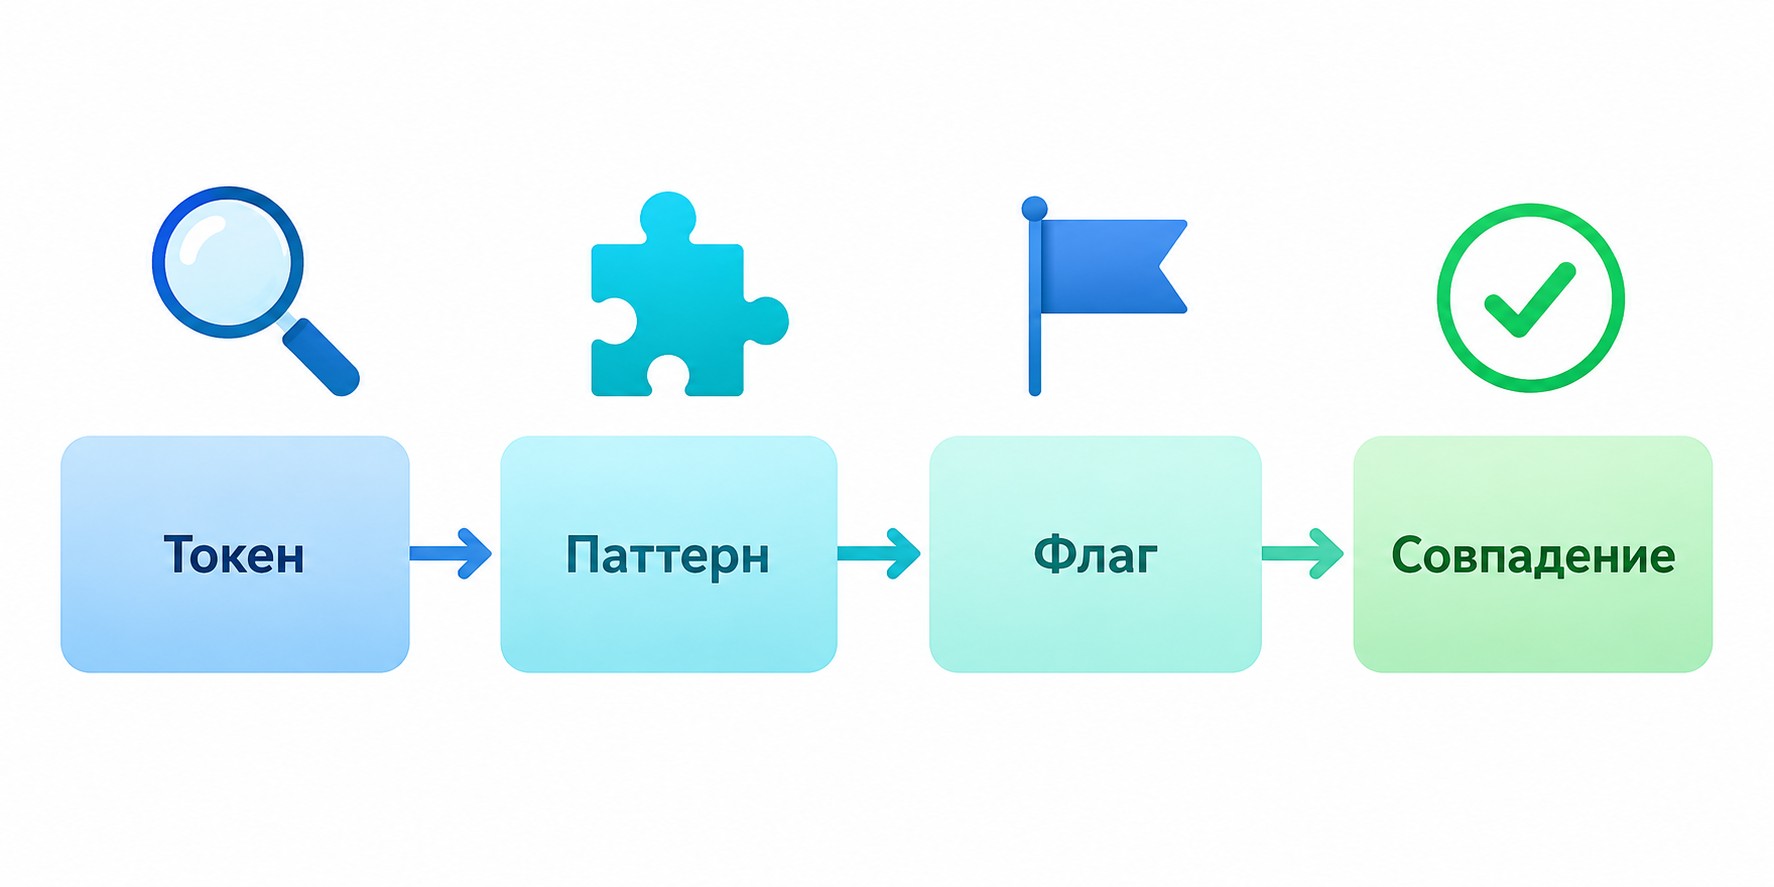
Регулярное выражение — шаблон, описывающий набор строк. Движок сравнивает шаблон с входным текстом и возвращает совпадения. Стандарт PCRE (версия PCRE2) вырос из языка Perl и сегодня поддерживается во всех основных языках программирования.
По умолчанию регулярные выражения регистрозависимы: Hello и hello — разные шаблоны. Флаг i снимает это ограничение.
Четыре основных применения RegExp
Регулярки применяются в четырёх типовых задачах:
- Поиск. Найти код ошибки «ERR_» с числовым суффиксом в многострочном логе.
- Валидация. Проверить, что серийный номер состоит строго из буквы, дефиса и шести цифр.
- Парсинг. Извлечь дату формата ДД.ММ.ГГГГ из произвольного текста.
- Замена. Схлопнуть несколько подряд идущих пробелов в один.
Регулярное выражение решает все четыре задачи единым синтаксисом — это его главное преимущество перед стандартными строковыми функциями.
Когда регулярные выражения не подходят
Три ситуации, где regex не справится:
- Парсинг HTML и XML. Разметка вложенная и нерегулярная — используйте специализированные парсеры.
- Проверка email по RFC 5322. Паттерн становится неуправляемым и всё равно не покрывает все крайние случаи.
- Произвольно глубокая вложенность. Регулярные выражения не умеют «считать» уровни вложенности — для этого нужны контекстно-свободные грамматики.
Синтаксис регулярных выражений: справочник токенов
Синтаксис regex — набор токенов: каждый описывает символ, позицию или поведение. Спецсимволы . ^ $ * + ? { } [ ] \ | ( ) экранируются обратным слешем \, чтобы трактоваться буквально. В строках Python и Java \ удваивается: \\d.
Символьные классы и метасимволы
Символьный класс — токен, который обозначает набор символов одним знаком в паттерне. Заглавная версия класса (\D, \W, \S) — всегда инверсия строчной.
| Токен | Что совпадает |
|---|---|
| \d | Цифра 0–9 |
| \D | Любой символ, кроме цифры |
| \w | Буква, цифра или _ |
| \W | Любой символ, кроме \w |
| \s | Пробел, табуляция, перевод строки |
| \S | Любой символ, кроме пробельного |
| . | Любой символ, кроме \n |
| [abc] | Один из символов a, b или c |
| [a-z] | Любая строчная латинская буква |
| [^abc] | Любой символ, кроме a, b и c |
| [а-яА-ЯёЁ] | Любая кириллическая буква (включая Ё) |
Квантификаторы: таблица синтаксиса
Квантификатор применяется только к непосредственно предшествующему токену или группе. Режим по умолчанию — жадный; подробнее о режимах — в следующем разделе.
| Квантификатор | Повторений | Режим |
|---|---|---|
| * | 0 или более | жадный |
| + | 1 или более | жадный |
| ? | 0 или 1 | жадный |
| {n} | Ровно n | жадный |
| {n,m} | От n до m | жадный |
| {n,} | n или более | жадный |
| *? | 0 или более | ленивый |
| +? | 1 или более | ленивый |
| ?? | 0 или 1 | ленивый |
| *+ | 0 или более | ревнивый |
| ++ | 1 или более | ревнивый |
| ?+ | 0 или 1 | ревнивый |
Якоря, группы и флаги
Якоря задают позицию в строке, а не конкретный символ. Группы объединяют фрагменты паттерна. Флаги меняют режим работы всего выражения.
| Якорь | Смысл |
|---|---|
| ^ | Начало строки |
| $ | Конец строки |
| \b | Граница слова |
| \B | Не граница слова |
| Группа | Синтаксис | Назначение |
|---|---|---|
| Захватывающая | (abc) | Запоминает совпадение; ссылка \1 |
| Незахватывающая | (?:abc) | Группирует без запоминания |
| Именованная | (?<name>abc) | Ссылка по имени: \k<name> |
| Lookahead | (?=abc) | Проверяет контекст впереди, не потребляя символы |
| Lookbehind | (?<=abc) | Проверяет контекст позади, не потребляя символы |
| Флаг | Действие |
|---|---|
| g | Глобальный поиск (все совпадения) |
| i | Без учёта регистра |
| m | Многострочный: ^/$ — граница каждой строки |
| s | Dotall: . совпадает с \n |
| u | Unicode |
| x | Подробный режим (verbose): пробелы и комментарии в паттерне игнорируются |
Жадные, ленивые и ревнивые квантификаторы
Режим квантификатора определяет, сколько символов он «захватывает» прежде, чем движок проверяет остаток паттерна.
| Режим | Поведение | Суффикс | Результат на строке <a><b> |
|---|---|---|---|
| Жадный | Максимально длинное совпадение | — | <a><b> (вся строка) |
| Ленивый | Минимально короткое совпадение | ? | <a> (первый тег) |
| Ревнивый | Максимальное без возврата | + | Нет совпадения* |
Жадный режим работает по умолчанию. Ленивый незаменим при разборе HTML-тегов: <.+?> последовательно находит <a>, затем <b>. Ревнивый (*+, ++) исключает возврат (backtracking) — ускоряет обработку строк, которые заведомо не совпадут с паттерном.
Скобочные группы и обратные ссылки
Круглые скобки выполняют две функции: группируют часть паттерна и (в захватывающем режиме) запоминают совпадение.
Три типа групп:
- (abc) — захватывающая. Совпадение доступно как \1 по номеру или \k<name> у именованных групп.
- (?:abc) — незахватывающая. Группирует без сохранения — ниже расход памяти, чуть выше скорость.
- (?<year>\d{4}) — именованная. Обращение по имени: \k<year> в паттерне или match.group('year') в Python.
Поиск повторяющегося слова. Паттерн (\w+)\s+\1 находит случайный дубль: (\w+) захватывает первое слово, \1 требует его точного повтора через пробел. «the the» или «как как» дадут совпадение, «the cat» — нет. Именованная версия (?<word>\w+)\s+\k<word> читается лучше, поведение то же.
Используйте незахватывающую группу (?:) везде, где запоминание не нужно: это заметно снижает потребление памяти в регулярных выражениях с десятками групп.
Регулярные выражения в Python: модуль re
Модуль re входит в стандартную библиотеку Python — устанавливать ничего не нужно. Пять ключевых функций:
- re.search(pattern, str) — первое совпадение в любой позиции; возвращает объект Match или None.
- re.match(pattern, str) — совпадение только в начале строки.
- re.findall(pattern, str) — список всех совпадений.
- re.sub(pattern, repl, str) — замена совпадений на repl.
- re.split(pattern, str) — разбиение строки по совпадениям.
re.compile() как кэш паттерна. При многократном применении одного паттерна — в цикле или к большому файлу — скомпилируйте его заранее:
Хотите сменить профессию или повысить квалификацию?
Федеральный проект «Активные меры содействия занятости» даёт возможность пройти обучение бесплатно за счёт государства
- Программы от ведущих вузов России — от 2 месяцев
- Удостоверение или диплом установленного образца
- Центр карьеры: 7 500+ вакансий, помощь с трудоустройством
import re
pattern = re.compile(r'\d{4}-\d{2}-\d{2}')
dates = pattern.findall(log_text)
Объект pattern хранит скомпилированный автомат — повторная компиляция не происходит. Практические примеры: re.findall(r'[\w.+-]+@[\w-]+\.[a-z]{2,}', text) извлекает email-адреса; re.sub(r'\s+', ' ', text) схлопывает дублирующиеся пробелы в один.
RegExp в JavaScript, Java и PHP
Все три языка следуют PCRE-совместимому синтаксису с небольшими отличиями в API. Ниже — краткий справочник по каждому.
JavaScript: синтаксис и методы RegExp
В JavaScript регулярное выражение записывается литеральным /pattern/flags или конструктором new RegExp(pattern, flags).
Основные методы:
- /\d+/.test(str) — возвращает true/false.
- /\d+/.exec(str) — первое совпадение (объект или null); с флагом g продвигается по строке при повторных вызовах.
- str.match(/\d+/g) — массив всех совпадений при флаге g.
- str.replace(/\s+/g, ' ') — замена.
Java и PHP
Java. Пакет java.util.regex: Pattern.compile("\\d+") компилирует паттерн; Matcher.find() ищет следующее совпадение. В строках Java обратный слеш удваивается: "\\d" — это токен \d.
PHP. Функции preg_* используют PCRE напрямую. Разделитель обязателен: preg_match('/\d+/', $str, $m) — первое совпадение; preg_replace('/\s+/', ' ', $str) — замена; preg_split('/,\s*/', $str) — разбиение по запятой.
Онлайн-инструменты для тестирования и отладки RegExp
Перед встраиванием паттерна в код проверьте его на реальных тестовых данных. Четыре инструмента для работы с регулярными выражениями онлайн:
| Инструмент | Адрес | Ключевая фича | Лучший сценарий |
|---|---|---|---|
| Regex101 | regex101.com | Пошаговый отладчик, объяснение каждого токена | Разработка и отладка |
| Regexper | regexper.com | SVG railroad diagram паттерна | Понимание чужого кода |
| RegExr | regexr.com | Библиотека паттернов, справочник | Обучение |
| Notepad++ | notepad-plus-plus.org | Поиск/замена с RegExp в файлах | Работа с текстом без кода |
Начинать рекомендуется с Regex101: пошаговый отладчик объясняет каждый шаг сопоставления и показывает, на каком токене сломался паттерн.
Хотите углубиться в работу с данными, кодом и цифровыми инструментами? В рамках федерального проекта «Активные меры содействия занятости» можно пройти обучение по IT-направлениям — аналитика, 1С, нейросети, дизайн — бесплатно, за счёт государства, без отрыва от работы. Смотрите каталог доступных программ.
Часто задаваемые вопросы
Чем регулярные выражения отличаются от обычного поиска по строке?
Обычный поиск находит точное вхождение: «test» — только «test». RegExp описывает шаблон: \btest\w*\b найдёт «test», «testing», «tested». Сила регулярок — в переменных частях: длине совпадения, диапазоне символов, числе повторений, позиции в строке. Именно это делает их незаменимым инструментом при работе с неструктурированным текстом.
В чём разница между жадным и ленивым квантификатором?
Жадный (*, +) захватывает максимально длинную строку, потом «отступает», если нужно. Ленивый (*?, +?) — минимальную. На строке <a><b>: паттерн <.+> вернёт всю строку целиком, а <.+?> — только <a>. Жадный режим — поведение по умолчанию.
Что такое захватывающая группа в регулярном выражении?
Круглые скобки (abc) создают захватывающую группу — совпадение сохраняется в памяти: \1 обращается к первой группе, \k<name> — к именованной (?<name>abc). Если запоминание не нужно, используйте (?:abc) — незахватывающая скобочная группа работает быстрее и экономит память.
Как найти пробел в регулярном выражении?
Пробельные символы — пробел, табуляция, перевод строки — обозначает \s. Один или более — \s+. Только буквальный пробел — [ ]. В Python: re.sub(r'\s+', ' ', text) схлопывает все пробелы в один. Для поиска строки без пробелов — \S+.
Как выглядит обратная ссылка для поиска повторяющегося слова?
Паттерн (\w+)\s+\1 находит слово, за которым через пробелы идёт то же самое — например «the the». (\w+) захватывает первое вхождение, \1 требует точного повтора. Именованная версия: (?<word>\w+)\s+\k<word> — то же самое, но читается понятнее.
Как применять RegExp в SQL?
MySQL: SELECT * FROM t WHERE col REGEXP '^\\d{4}-' — стандартный синтаксис REGEXP. PostgreSQL: col ~ '^\d{4}-' (регистрозависимо) или col ~* '^\d{4}-' (без учёта регистра). ANSI-аналог SIMILAR TO ограничен: не поддерживает \d и \w из PCRE.
Как использовать регулярки в Bash?
grep -E '\d{3}-\d{4}' — Extended RegExp (ERE). grep -P '\d{3}-\d{4}' — PCRE, как в Python. sed 's/\s\+/ /g' — замена в потоке. Важно: базовый grep без флагов работает в BRE-режиме: символы + и ? нужно экранировать как \+, \?.
Как RegExp применяется в задачах ЕГЭ по информатике?
Типичная задача: «Сколько строк соответствует паттерну [А-Яа-я]{3}\d{2}?» Разбираем токен за токеном: [А-Яа-я]{3} — ровно три кириллические буквы, \d{2} — ровно две цифры. Якоря ^ и $ ограничивают совпадение всей строкой. Практика на Regex101 существенно ускоряет подготовку.
Как протестировать регулярное выражение онлайн?
Regex101.com — выбор для начинающих: подсвечивает совпадения, объясняет каждый токен и предоставляет пошаговый отладчик. Regexper.com строит SVG-диаграмму паттерна — полезно для понимания чужого кода. Оба работают без регистрации, прямо в браузере.
Как использовать регулярные выражения в Notepad++?
В Notepad++: меню Search → Find → режим «Regular expression». Паттерн ^\s*$ с пустой строкой замены удаляет все пустые строки. Опция «. matches newline» позволяет захватывать многострочные блоки. Notepad++ использует диалект Boost.Regex — практически идентичен PCRE.
Подайте заявку —
забронируйте место в группе
45 000 мест на 2026 год. Бесплатное обучение по федеральному проекту «Активные меры содействия занятости»
- Онлайн
- От 2 месяцев
- Бесплатно
- Диплом