Что такое ETL: как работает процесс извлечения, преобразования и загрузки данных
ETL (от англ. Extract, Transform, Load — извлечение, преобразование, загрузка) — технологический процесс, который автоматически собирает данные из разрозненных источников, приводит их к единому стандарту и загружает в аналитическое хранилище. В статье разберём, что такое ETL простыми словами, как устроен каждый этап, чем ETL-пайплайн отличается от ELT и какие инструменты используют инженеры данных.
Что такое ETL простыми словами
Представьте: данные о клиентах хранятся в CRM, транзакции — в базе данных банка, поведение на сайте — в аналитической системе, а складские остатки — в ERP (системе управления ресурсами предприятия). У каждой системы свой формат, кодировка и правила хранения. Когда аналитик запрашивает сводный отчёт, ему приходится вручную сводить несовместимые таблицы — это занимает дни и порождает ошибки.
Учитесь бесплатно за счёт государства
Экономия до 100 000 ₽ на любой программе
Что такое ETL в IT — именно ответ на эту проблему. Процесс автоматически извлекает данные из источников (Extract), очищает и нормализует их по бизнес-правилам (Transform), а затем загружает в единое хранилище данных (Load) — откуда инструменты бизнес-аналитики (BI) строят дашборды и управленческие отчёты.
Аналогия без IT-жаргона: ETL — комбайн, который собирает «урожай» данных с разных «полей» (баз данных, API, CRM), обрабатывает его и засыпает в один амбар (хранилище данных) — готовый к использованию.
С ETL-системой работают два специалиста: инженер данных проектирует и поддерживает конвейер, аналитик данных использует уже подготовленные данные для отчётности. Результат — единый источник правды вместо хаоса разрозненных баз. По данным исследования Forrester Research, автоматизация через ETL сокращает ошибки ручной обработки на 91%. При этом, согласно оценке Gartner за 2025 год, 63% ETL-проектов сталкиваются с трудностями при первоначальной настройке — поэтому важно понимать архитектуру до её внедрения.
Три этапа ETL-процесса
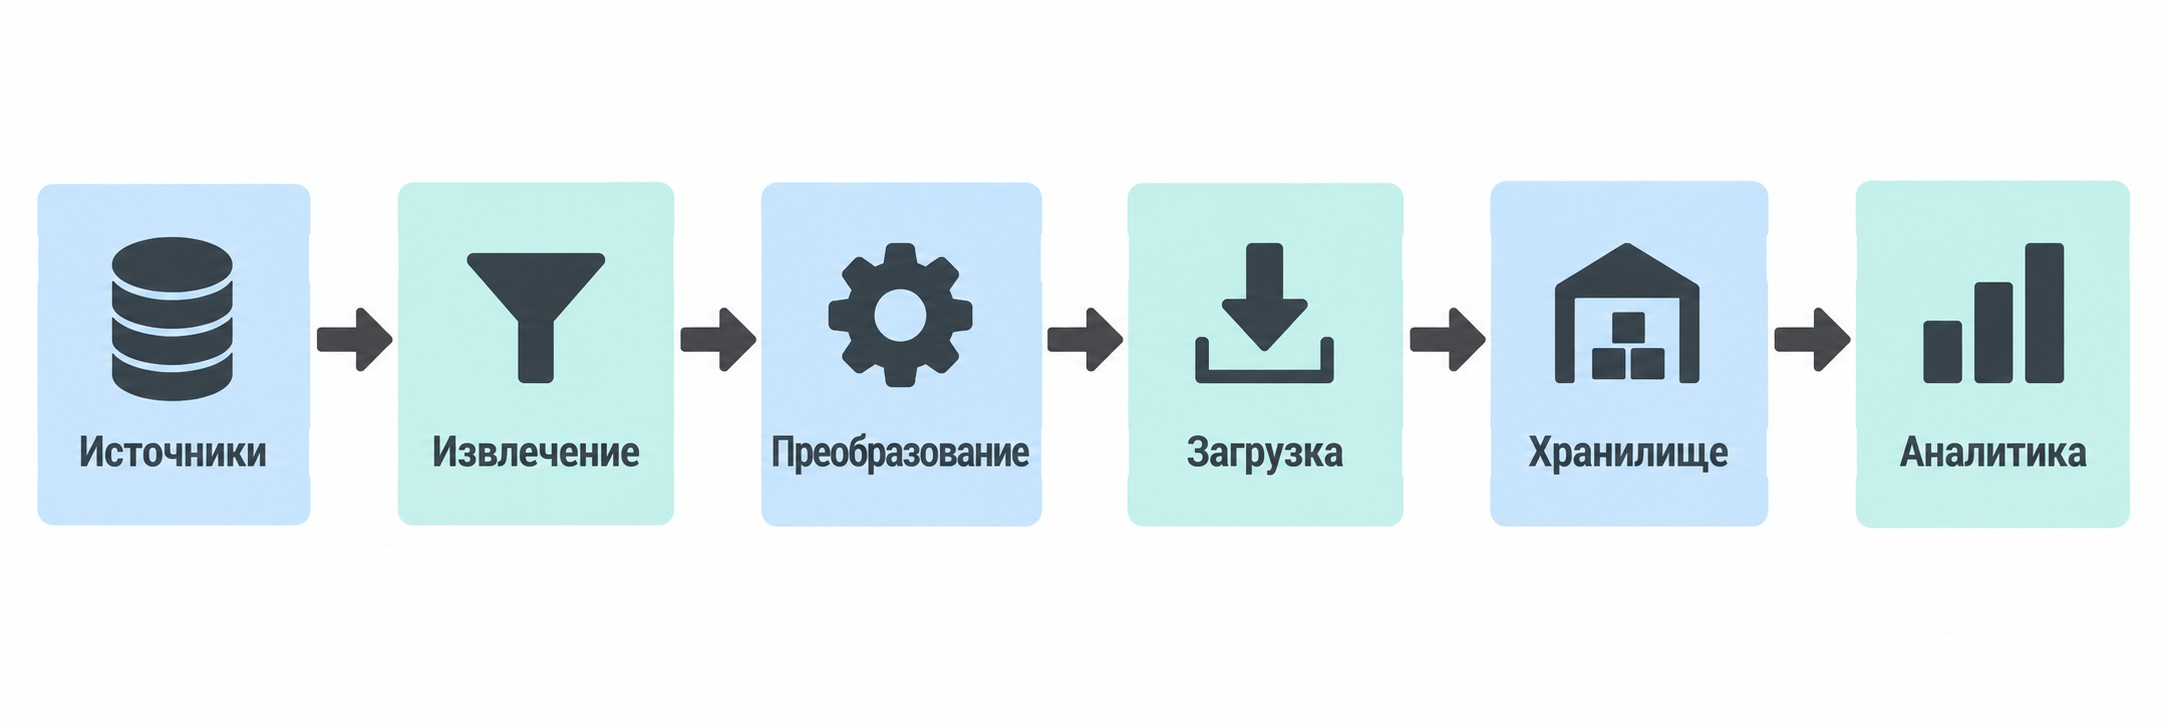
ETL — не три разрозненных операции, а единый конвейер. Данные проходят этапы последовательно, и сбой на любом из них останавливает весь процесс. Пайплайн выглядит так:
[CRM] → [EXTRACT] → [TRANSFORM] → [LOAD] → [DWH] → [BI]
Разберём каждый шаг подробно.
Extract — извлечение данных из источников
На этапе извлечения ETL-система подключается к источникам данных через коннекторы: реляционные базы (SQL), REST API, плоские файлы (CSV, JSON, XML), облачные сервисы и потоковые шины сообщений.
Три метода извлечения данных:
- Полная загрузка — копирование всего набора данных; подходит для первого запуска или небольших таблиц.
- Инкрементальная загрузка — извлекаются только новые или изменённые записи с момента последнего запуска; снижает нагрузку на источник данных.
- По уведомлениям — источник сам сигнализирует об изменении через триггер или событие; оптимально для систем с высокой частотой обновлений.
Выбор метода зависит от двух факторов: как часто обновляется источник и поддерживает ли он отслеживание изменений. После извлечения данные попадают во временное хранилище — для проверки целостности до передачи на следующий этап.
Transform — преобразование данных
Трансформация — самый трудоёмкий этап ETL-процесса. По данным IDC, аналитики тратят до 70% рабочего времени на подготовку и очистку данных. На этом шаге система выполняет пять ключевых операций:
- Очистка данных — удаление пустых значений, исправление форматов дат, телефонов, адресов.
- Дедупликация записей — выявление и удаление дублирующихся строк.
- Нормализация — приведение к единым справочникам, кодировкам, единицам измерения.
- Агрегирование — расчёт сумм, средних значений, итогов по периодам.
- Объединение источников — сопоставление записей из разных систем по ключевым полям.
На этапе трансформации закладывается бизнес-логика: правила расчёта KPI, сегментация клиентов, присвоение статусов. Метаданные о происхождении записей сохраняются для аудита. Результат — данные единообразны, совместимы с хранилищем и готовы к загрузке.
Load — загрузка в хранилище
На финальном этапе трансформированные данные поступают в целевое хранилище данных (DWH, Data Warehouse). Три режима загрузки:
- Полная (initial load) — однократная загрузка всего набора при первом запуске.
- Инкрементальная (дельта) — добавление только новых записей; сохраняет историю изменений.
- Потоковая загрузка — непрерывная передача данных с минимальной задержкой; нужна для дашбордов реального времени.
Пакетная обработка (раз в день или неделю) подходит для большинства аналитических задач; потоковая — когда данные нужны прямо сейчас. После загрузки данные готовы для BI-инструментов: дашбордов, управленческих отчётов и прогнозных моделей.
ETL-пайплайн: как устроен и как настроить
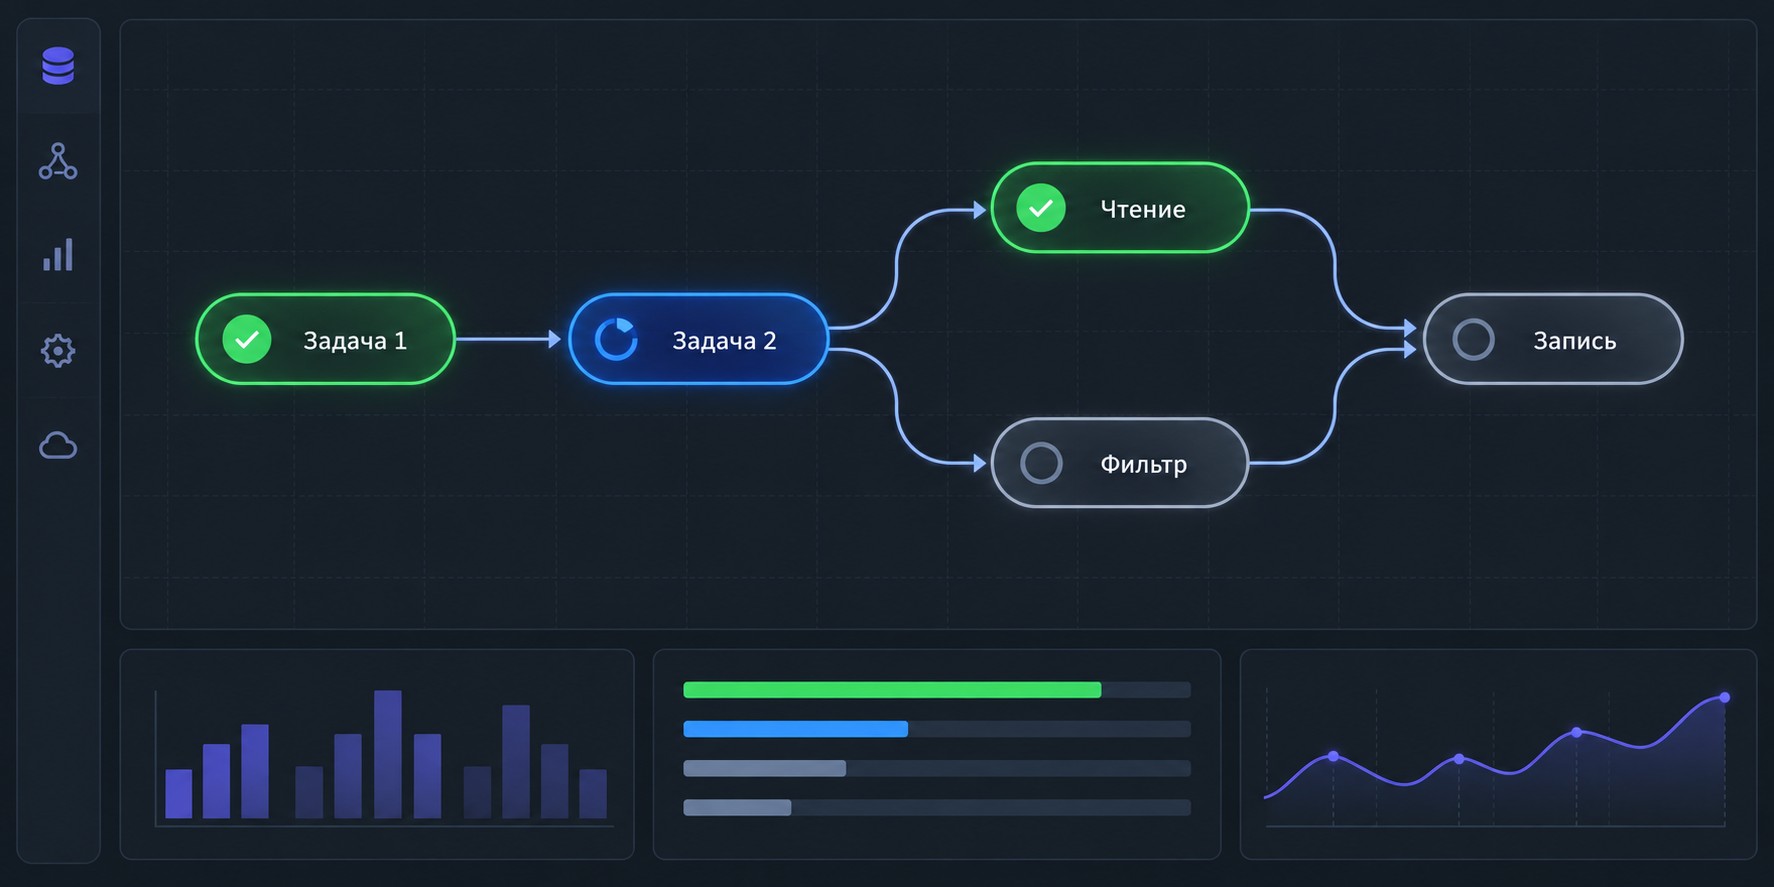
ETL-пайплайн — автоматизированная последовательность ETL-задач, описанная как направленный ациклический граф (DAG, от англ. Directed Acyclic Graph). Задачи выполняются в строгом порядке: следующая запускается только после успешного завершения предыдущей.
Главный оркестратор пайплайнов в индустрии — Apache Airflow: платформа с открытым исходным кодом на Python, которая управляет тысячами пайплайнов одновременно. Airflow запускает задачи по расписанию, внешнему триггеру или сенсору — например, когда файл появился в облачном хранилище.
Пять шагов настройки ETL-пайплайна:
- Определить задачу — какие данные нужны, с какой периодичностью, какой результат ожидается.
- Настроить доступ к источникам — подключить коннекторы, задать параметры аутентификации.
- Описать правила трансформации — зафиксировать бизнес-логику очистки, агрегирования, объединения.
- Настроить загрузку в хранилище — выбрать режим (инкрементальный, полный, потоковый) и целевую таблицу.
- Автоматизировать и мониторить — запланировать запуск в DAG, настроить алерты на ошибки.
Ход выполнения каждой задачи отслеживается через веб-интерфейс Airflow: статус, логи, время выполнения. Масштабируемость — ключевое преимущество пайплайнов: при росте нагрузки добавляют воркеров (исполнителей задач) без перестройки всей архитектуры.
ETL против ELT — в чём разница
Ключевое отличие ETL от ELT (Extract, Load, Transform) — порядок трансформации. В ETL данные преобразуются до загрузки в хранилище; в ELT загружаются сначала «сырыми», а трансформируются уже внутри хранилища. Выбор зависит от инфраструктуры, объёма данных и требований безопасности.
| Параметр | ETL | ELT |
|---|---|---|
| Место трансформации | До загрузки (промежуточный слой) | После загрузки (внутри хранилища) |
| Требования к хранилищу | Стандартные | Высокая вычислительная мощность |
| Гибкость аналитики | Ниже — логика фиксируется заранее | Выше — трансформации можно менять |
| Безопасность данных | Выше — маскировка до загрузки | Ниже — данные попадают «сырыми» |
| Производительность | Зависит от промежуточного сервера | Использует мощность хранилища |
| Платформы | Airflow, Informatica, Talend | Snowflake, Redshift, BigQuery, Databricks |
| Лучший сценарий | Compliance, сложная бизнес-логика | Big Data, облако, ML/AI, e-commerce |
По данным Gartner за 2025 год, 72% крупных компаний используют оба подхода в рамках гибридной архитектуры.
Когда выбирать ETL
ETL — оптимальный выбор там, где данные чувствительны к конфиденциальности или бизнес-логика трансформации сложна. Конкретные сценарии:
- Регуляторные требования — GDPR, 152-ФЗ о персональных данных, Базель III: персональные данные маскируются и обезличиваются ещё до попадания в хранилище.
- Сложная бизнес-логика — многоуровневые правила расчёта кредитного скоринга, страховых резервов, медицинских показателей.
- Ограниченные ресурсы хранилища — трансформация выносится во внешний слой, чтобы не нагружать базу данных аналитическими вычислениями.
Отрасли, которые чаще выбирают ETL в базах данных: финансы и банкинг, здравоохранение, государственный сектор, страхование.
Когда выбирать ELT
ELT оптимален при работе с большими объёмами данных и облачными платформами. Данные загружаются «как есть», трансформации описываются SQL или инструментами трансформации прямо внутри хранилища.
Лучшие сценарии:
- Big Data и озеро данных — объёмы, которые не вместит промежуточный слой.
- Гибкость аналитики — правила трансформации часто меняются без необходимости перестраивать пайплайн.
- Облачные платформы — Snowflake, Amazon Redshift, Google BigQuery, Databricks масштабируются автоматически.
ELT чаще выбирают в e-commerce, маркетинге, продуктовой аналитике и при разработке ML-моделей.
Гибридная архитектура ETL + ELT
На практике жёсткого разделения почти нет. Согласно данным Gartner за 2025 год, 72% крупных предприятий применяют гибридный подход: ETL обрабатывает чувствительные транзакционные данные до загрузки, ELT — обогащает их внутри мощного аналитического хранилища.
Типичная комбинация: Apache Airflow управляет оркестрацией, Snowflake выполняет ELT-трансформации. Такой стек позволяет мигрировать поэтапно — батчевый процесс для критичных данных, ELT для аналитического слоя, без остановки бизнес-процессов.
Инструменты для ETL-процессов
Рынок ETL-инструментов делится на пять категорий: оркестраторы, потоковые движки, визуальные конструкторы, корпоративные платформы и облачные сервисы. На практике инструменты комбинируют: отдельный оркестратор управляет задачами, отдельный движок выполняет трансформации.
| Инструмент | Тип | Лицензия | Сложность | Лучший сценарий |
|---|---|---|---|---|
| Apache Airflow | Оркестратор | Open-source | Высокая | Сложные зависимые пайплайны, Python-стек |
| Apache NiFi | Потоковый ETL | Open-source | Средняя | Потоковые данные реального времени |
| Talend | Визуальный конструктор | Freemium / Enterprise | Низкая | Быстрый старт без разработчика |
| Informatica | Корпоративная платформа | Коммерческая | Высокая | Compliance, управление метаданными |
| AWS Glue | Облачный ETL-сервис | Pay-per-use | Средняя | Data Lake, AWS-инфраструктура, Apache Spark |
Хотите сменить профессию или повысить квалификацию?
Федеральный проект «Активные меры содействия занятости» даёт возможность пройти обучение бесплатно за счёт государства
- Программы от ведущих вузов России — от 2 месяцев
- Удостоверение или диплом установленного образца
- Центр карьеры: 7 500+ вакансий, помощь с трудоустройством
Обзор ETL-инструментов и облачных сервисов
Apache Airflow — стандарт отрасли для оркестрации пайплайнов. Инженер данных описывает задачи на Python как DAG, Airflow запускает их по расписанию или триггеру. Подходит командам с Python-экспертизой и сложными зависимостями между задачами. Масштабируется до тысяч пайплайнов.
Apache NiFi — специализируется на потоковой обработке данных. Визуальный интерфейс позволяет строить потоки без написания кода. Встроенный механизм отслеживания происхождения данных (data lineage) упрощает аудит и отладку конвейера.
Talend — низкий порог входа: визуальный конструктор с готовыми коннекторами к популярным источникам. Подходит компаниям, где нет выделенного инженера данных, и нужен быстрый старт без глубокой разработки.
Informatica — корпоративная платформа с акцентом на управление метаданными и соответствие регуляторным требованиям. Выбирают крупные банки, страховые компании, госструктуры.
AWS Glue — облачный ETL-сервис на базе Apache Spark: не требует управления серверами, масштабируется под нагрузку, тесно интегрируется с экосистемой AWS и озером данных.
Чеклист выбора ETL-инструмента:
- Каков объём данных и частота обновлений?
- Облачная или собственная инфраструктура?
- Есть ли требования compliance (GDPR, 152-ФЗ)?
- Какой стек знает команда: Python, Java или нужен визуальный конструктор?
Где применяется ETL: отраслевые примеры
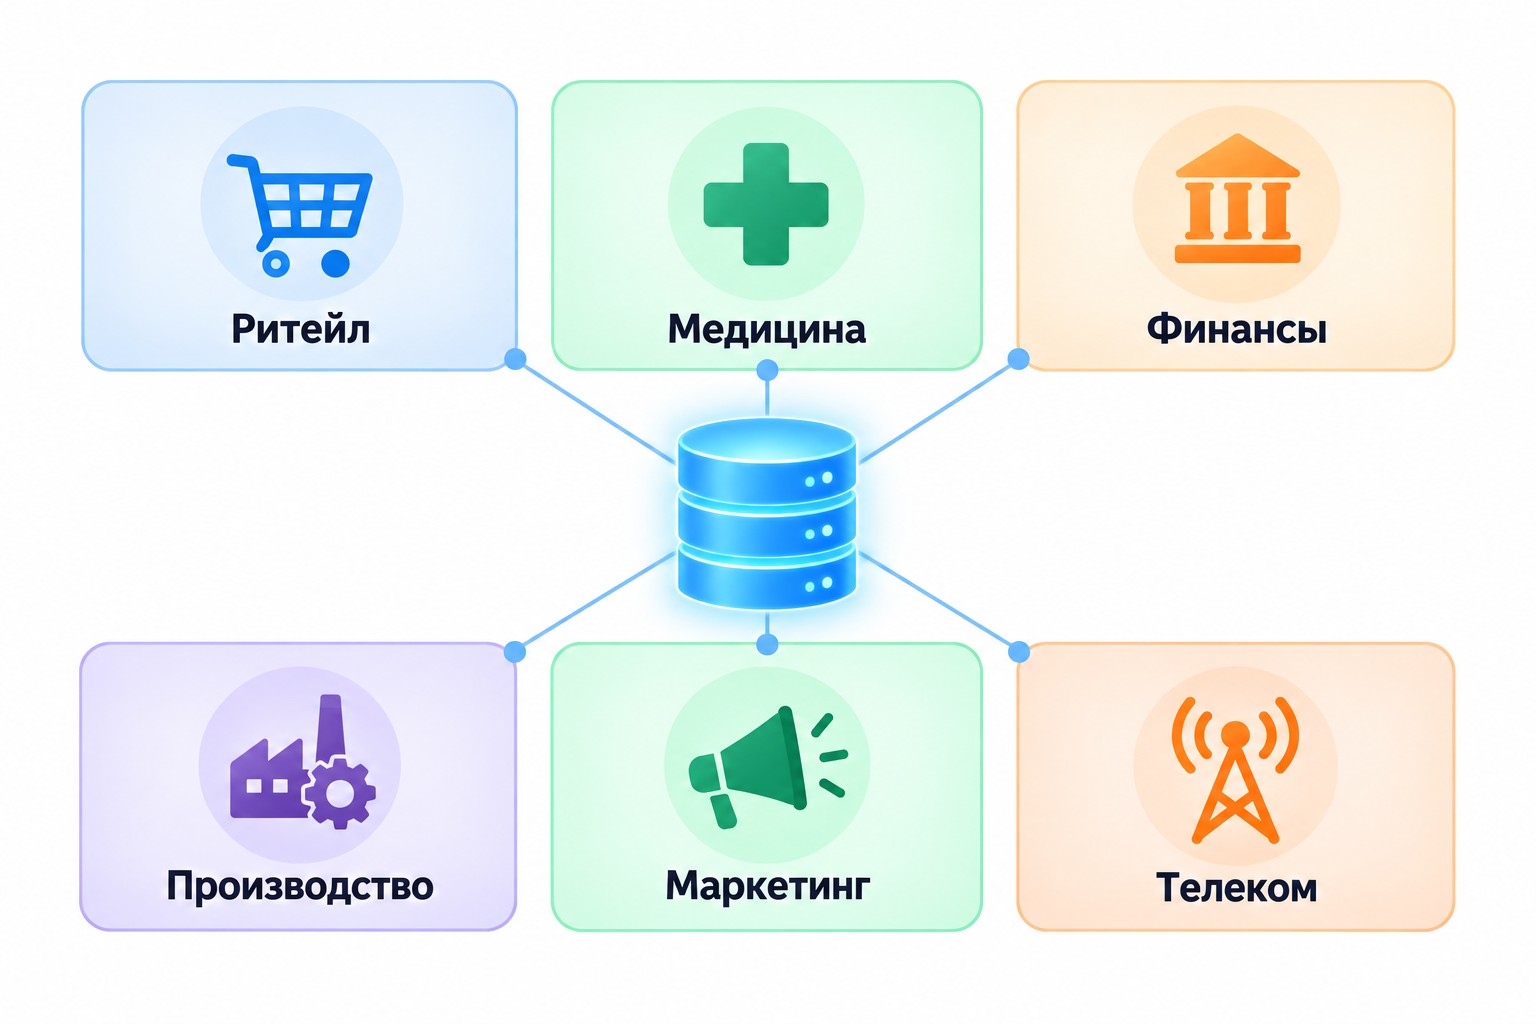
ETL используют везде, где данные приходят из нескольких систем и нужна единая аналитика.
Финансы и банкинг. Кредитный скоринг объединяет данные кредитных бюро, CRM и транзакционных систем. Регуляторная отчётность по стандартам Базель III требует консолидации данных из десятков источников. По оценке Deloitte, внедрение ETL в финансовом секторе снижает кредитные риски на 12–17%.
Ритейл и e-commerce. ETL строит 360°-профиль клиента: история покупок, поведение на сайте, данные программы лояльности. Персонализация на основе объединённых данных повышает конверсию на 10–15%, по расчётам McKinsey & Company.
Здравоохранение. Единый профиль пациента из медицинских информационных систем, лабораторий и данных страховщика позволяет строить предиктивные модели. Предиктивная аналитика снижает число повторных госпитализаций на 15–18%.
Производство. Данные с датчиков Интернета вещей (IoT), систем ERP и журналов обслуживания объединяются для предиктивного обслуживания оборудования — простои сокращаются на 30–50%.
Телеком. Анализ оттока клиентов на основе данных об использовании сервисов и истории обращенийпозволяет снизить отток на 15–25%.
По данным Forrester Research, компании с автоматизированными ETL-процессами сокращают время на подготовку отчётности на 65–78%. Заработная плата специалистов по данным существенно варьируется в зависимости от компании, региона и опыта.
Кто работает с ETL: инженер и аналитик данных
ETL-системами занимаются два специалиста с разными зонами ответственности.
Инженер данных проектирует, строит и поддерживает ETL-пайплайны. Типичный стек: Apache Airflow для оркестрации, PySpark для трансформации больших объёмов, SQL для работы с реляционными источниками. Инженер отвечает за бесперебойную работу инфраструктуры: данные должны поступать по расписанию, без потерь и ошибок.
Аналитик данных работает с уже подготовленными данными: строит дашборды, отчёты и аналитические модели. Его задача — извлечь бизнес-ценность из того, что уже находится в хранилище.
Разница простая: инженер строит «трубы», аналитик изучает, что по ним течёт. Оба специалиста работают в связке — автоматизация ETL освобождает аналитика от рутинной обработки и позволяет сосредоточиться на интерпретации данных.
Войти в аналитику данных с нуля помогает освоение баз данных, SQL и принципов работы с аналитическими системами. Программа «Специалист по аналитике и базам данных в информационных системах» охватывает эти навыки за 72 часа онлайн, бесплатно в рамках нацпроекта «Кадры». Подробнее — в каталоге программ.
Проблемы и ограничения ETL
ETL — мощный инструмент, но не без слабых мест. Знать их важно до начала внедрения.
Трудоёмкость настройки. Согласно данным Gartner за 2025 год, 63% ETL-проектов сталкиваются со сложностями на этапе первоначальной настройки. Разработка коннекторов, описание правил трансформации и тестирование требуют времени и экспертизы.
Качество данных. ETL не исправляет плохие данные автоматически: аномалии данных, дубликаты и пропуски в данных «переезжают» в хранилище, если правила очистки настроены неточно. Препроцессинг данных нужно продумывать до запуска, а не исправлять постфактум.
Задержка при пакетной обработке. Батчевый ETL обновляет данные раз в час, день или неделю — неприемлемо для задач реального времени. Потоковая загрузка решает проблему, но усложняет архитектуру и требует дополнительной инфраструктуры.
Масштабирование. При росте объёмов промежуточный слой трансформации становится узким местом: нужны дополнительные вычислительные ресурсы или переход к ELT.
Ошибки при загрузке. Нарушения схемы данных, конфликты типов, сетевые сбои — всё это требует механизмов повторных попыток и мониторинга в реальном времени.
Когда ETL избыточен. Если задача разовая, объём данных небольшой или все источники находятся в одной системе — ETL добавляет сложность без выгоды. В таких случаях достаточно прямого SQL-запроса или простого скрипта.
Хотите разобраться в аналитике данных на практике? В рамках федерального проекта «Активные меры содействия занятости» можно пройти обучение по аналитике и работе с базами данных — онлайн, без отрыва от текущей занятости, без вложений. Смотрите каталог доступных программ.
Часто задаваемые вопросы
Что такое ETL простыми словами?
ETL — процесс, который автоматически собирает данные из CRM, баз данных, API, приводит их к единому виду и загружает в аналитическое хранилище. Аналогия: ETL — комбайн, который собирает «урожай» данных с разных «полей», обрабатывает и складывает в один «амбар» для аналитики. Без этого процесса аналитики вручную сводят несовместимые таблицы — это занимает дни и порождает ошибки.
Что такое ETL-процесс и из чего он состоит?
ETL-процесс — три последовательных этапа: Extract (извлечь из источников), Transform (очистить, нормализовать, агрегировать по бизнес-правилам), Load (загрузить в хранилище). Выполняется автоматически по расписанию или триггеру. Без него аналитические запросы перегружают транзакционные базы данных и дают несогласованные результаты.
Чем ETL отличается от ELT?
В ETL трансформация происходит до загрузки в хранилище, в ELT — после. ETL выбирают для задач compliance, сложной бизнес-логики и чувствительных данных. ELT — для Big Data и облачных платформ. По данным Gartner за 2025 год, 72% компаний совмещают оба подхода в гибридной архитектуре.
Что такое ETL-пайплайн?
ETL-пайплайн — автоматизированная последовательность ETL-задач, описанных как DAG (направленный ациклический граф) в Apache Airflow. Запускается по расписанию или событию, ход выполнения виден в веб-интерфейсе. Один Airflow-сервер управляет тысячами пайплайнов одновременно.
Какие инструменты используют для ETL?
Популярные инструменты: Apache Airflow (оркестрация, open-source), Apache NiFi (потоковые данные), Talend (визуальный конструктор), Informatica (корпоративные задачи), AWS Glue (облачный ETL на Apache Spark). На практике их комбинируют: Airflow для оркестрации и NiFi или Glue для трансформаций.
Что такое ETL-система?
ETL-система — комплекс инструментов: коннекторы к источникам данных, оркестратор (Airflow), модуль трансформации (PySpark или SQL), целевое хранилище данных. Крупные компании собирают стек из нескольких компонентов под конкретные задачи — например, Apache Airflow для управления задачами, NiFi для потоков и ClickHouse как хранилище.
Что такое облачный ETL-сервис и чем он отличается от on-premise?
Облачный ETL-сервис (AWS Glue, Azure Data Factory) работает без собственных серверов, масштабируется автоматически, оплата — по потреблению. On-premise ETL даёт больше контроля и соответствует строгим требованиям compliance. Облако оптимально для проектов с переменной нагрузкой и отсутствием собственной инфраструктуры.
Кто в компании работает с ETL и как это освоить?
Инженер данных проектирует и поддерживает ETL-пайплайны (стек: Airflow, PySpark, SQL). Аналитик данных использует готовые данные для отчётов и дашбордов. Разница: инженер создаёт инфраструктуру, аналитик извлекает ценность. Освоить навыки работы с базами данных и аналитическими системами можно на программе «Специалист по аналитике и базам данных в информационных системах» — 72 часа, бесплатно, нацпроект «Кадры». Смотрите каталог программ.
Подайте заявку —
забронируйте место в группе
45 000 мест на 2026 год. Бесплатное обучение по федеральному проекту «Активные меры содействия занятости»
- Онлайн
- От 2 месяцев
- Бесплатно
- Диплом