Портфолио аналитика данных: пошаговое руководство по созданию с нуля
Портфолио аналитика данных — набор из 3–5 кейсов, опубликованных на GitHub или Notion. Каждый кейс доказывает работодателю конкретный навык: работу с данными, статистику, визуализацию, бизнес-мышление. Для джуна без коммерческого опыта портфолио заменяет строки в трудовой книжке — и в разы повышает шансы получить приглашение на интервью. В этой статье — пошаговый план: от выбора типов проектов и источников данных до оформления на GitHub и подготовки к собеседованию.
Зачем аналитику портфолио и почему резюме недостаточно
Резюме декларирует навыки — портфолио их доказывает. Строки «знаю SQL», «работал с Python» и «опыт визуализации» ничем не отличают одного джуна от другого. Готовый кейс с бизнес-выводами — другое дело: нанимающий менеджер видит реальный уровень аналитического мышления и технической грамотности.
Учитесь бесплатно за счёт государства
Экономия до 100 000 ₽ на любой программе
Портфолио обязательно в двух случаях: когда вы входите в аналитику без коммерческого опыта, и когда меняете профессию. По данным рекрутинговых платформ, значительная часть работодателей готова рассматривать кандидата-джуна даже без опыта работы — при условии, что его портфолио убедительное. Наличие диплома при этом уходит на второй план: рекрутёров интересует не документ, а то, что человек умеет делать.
Middle-аналитику портфолио полезно при переходе в новую нишу или другой стек. Senior — менее критично: там работают репутация и профессиональные рекомендации.
Рекрутёр просматривает десятки похожих резюме в день. Пет-проект (собственный аналитический проект по личной инициативе) на близкой вам теме — логистика, медицина, ритейл — делает кандидата заметным. Это не про «уникальность», а про конкретику и понятное бизнес-мышление.
Что входит в портфолио аналитика данных
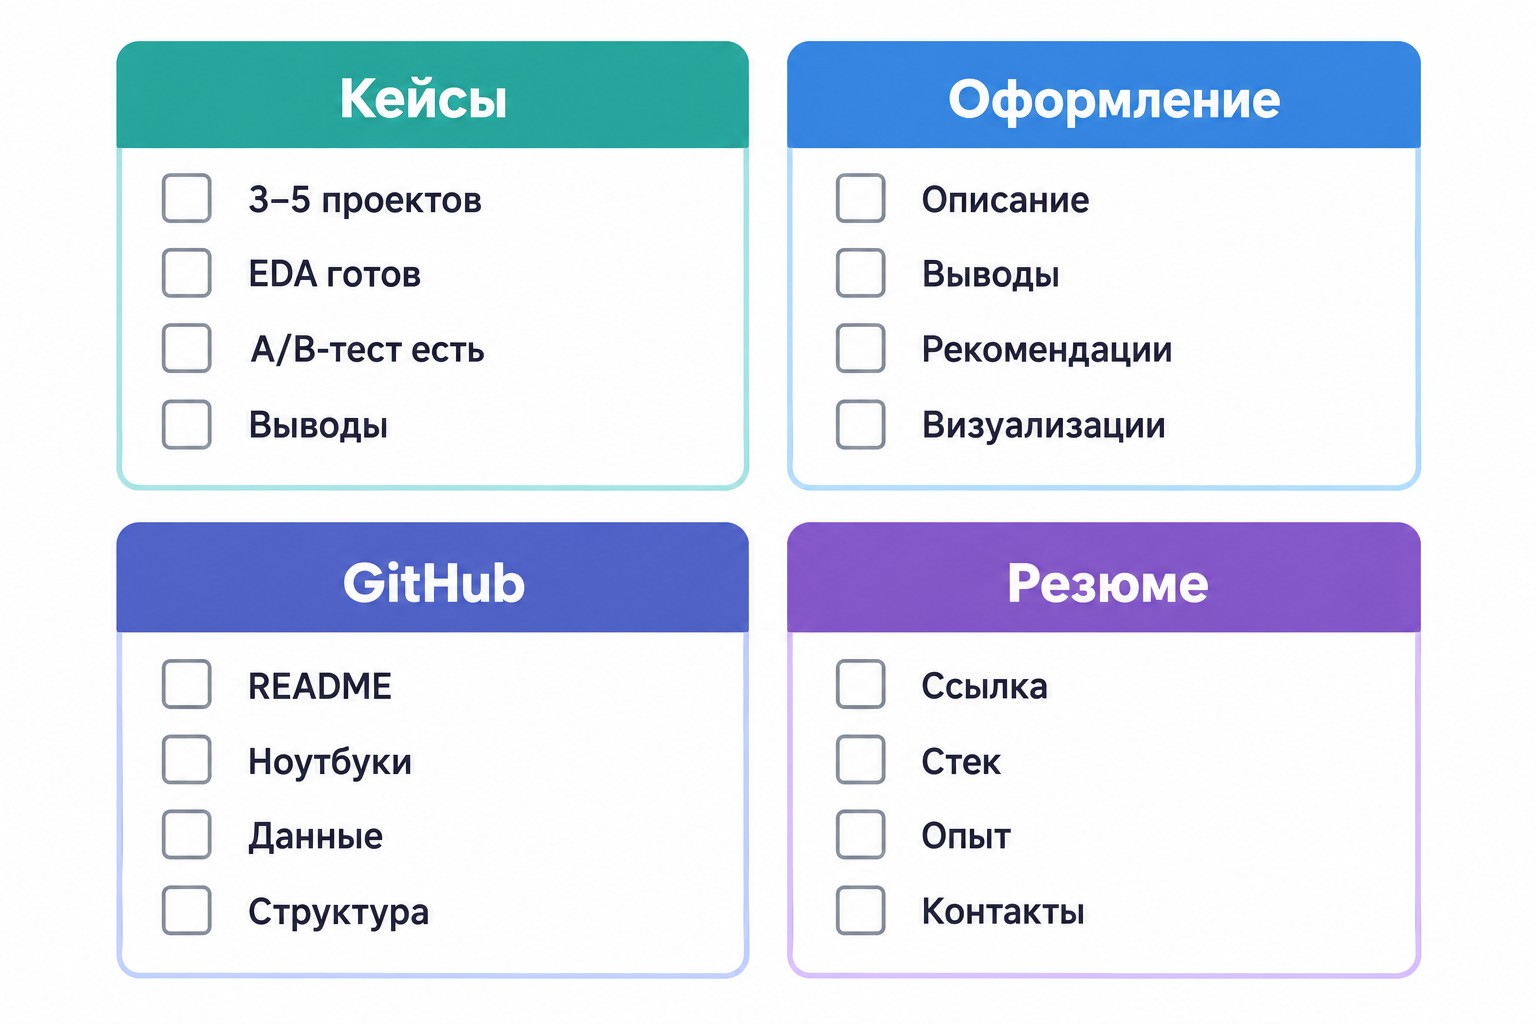
Минимальная структура портфолио: вводная страница с коротким описанием себя и стека → кейсы (3–5 штук) → контакты (GitHub, LinkedIn, Telegram). Это стандарт для того, чтобы собрать портфолио data analyst на рабочем уровне.
Правило качества: 3 сильных кейса лучше 10 поверхностных. Рекрутёр не откроет всё — он посмотрит первые два и сложит мнение. В каждом кейсе обязательны бизнес-контекст и ссылка на код. Без них проект не работает.
Из чего состоит качественный аналитический кейс
Структура кейса — 7 блоков:
- Контекст — какую бизнес-задачу решаете и для кого.
- Данные — источник, объём, ключевые поля.
- Методология — подходы и инструменты.
- Результаты — цифры и графики.
- Выводы — что обнаружили.
- Рекомендации — что следует сделать бизнесу.
- Ссылка на код — GitHub-репозиторий или Jupyter Notebook.
Рекрутёр тратит на один кейс 5–7 минут. За это время он должен понять задачу, увидеть результат и прочитать рекомендацию. README с описанием задачи и выводами — обязательный элемент каждого проекта.
Антипример: 20 графиков без единого вывода — это набор картинок, не аналитика. Кейс без рекомендации говорит рекрутёру: «Кандидат умеет строить графики, но не понимает зачем». Такой проект не запоминается.
Какие проекты включить в портфолио: 6 типов кейсов
Разные кейсы закрывают разные компетенции. Хорошее портфолио аналитика данных сочетает навыки работы с данными, статистику, визуализацию и бизнес-мышление — важно разнообразие, а не количество.
| Тип кейса | Сложность | Инструменты | Что показывает | Обязательность |
|---|---|---|---|---|
| EDA (разведочный анализ) | Базовая | Python pandas, Matplotlib, Seaborn | Работа с данными, визуализация | Обязательно |
| SQL-проект | Базовая | PostgreSQL, CTE, оконные функции | Владение SQL на практике | Обязательно |
| Дашборд | Базовая | Tableau Public, Yandex DataLens | Работа с BI-инструментами | Желательно |
| A/B-тестирование | Средняя | Python scipy.stats, statsmodels | Статистическое мышление | Обязательно для продуктового аналитика |
| Когортный анализ | Средняя | SQL + Python pandas, seaborn | Анализ поведения пользователей | Желательно |
| Анализ воронок и юнит-экономики | Высокая | SQL, Excel, Python | Понимание монетизации продукта | Опционально |
EDA — разведочный анализ данных
Разведочный анализ (EDA, Exploratory Data Analysis) — базовый и обязательный первый проект. Он показывает, умеете ли вы получить датасет, очистить данные и сделать из них понятные выводы.
Стандартные шаги EDA-кейса: загрузка данных → очистка пропусков и дубликатов → построение 5–7 графиков → формулировка 3–5 бизнес-инсайтов. Инструменты: библиотека pandas (обработка данных), Matplotlib и Seaborn (визуализация), Jupyter Notebook — интерактивная среда, где код и его результаты отображаются вместе.
Хорошие датасеты для старта: Airbnb listings, Spotify Charts, Uber fares — все доступны на Kaggle. Типичная ошибка: 20 графиков без единого вывода. Каждый график должен отвечать на конкретный вопрос, а вывод — содержать практическое следствие для бизнеса.
SQL-проект: оконные функции и аналитические запросы
SQL-кейс — серия из 5–10 запросов для решения одной бизнес-задачи: расчёт удержания пользователей, построение воронки, ранжирование по активности. Рекрутёр оценивает, владеете ли вы JOIN, CTE (Common Table Expressions — подзапросы, которые упрощают сложный SQL) и оконными функциями (аналитическими операторами SQL для расчётов внутри групп строк).
Минимальный набор: база PostgreSQL или публичный CSV с Kaggle, запросы с комментариями, README с описанием задачи и выводами. Когортный анализ и построение воронки через SQL — особенно ценимые задачи: они встречаются в реальной аналитике.
Дашборд: визуализация метрик продукта
Дашборд — интерактивный инструмент мониторинга: KPI-блок, фильтры по периоду и сегменту, динамика метрик. Он показывает, умеете ли вы переводить данные в картину, понятную нетехнической аудитории.
Инструменты: Tableau Public (бесплатная публикация для портфолио), Looker Studio, Yandex DataLens. Последний особенно актуален для российского рынка: многие компании строят аналитическую инфраструктуру именно на нём. Минимум: 3–5 визуализаций, фильтры, заголовок каждого блока — это вывод, не просто название метрики.
A/B-тестирование: статистически значимый кейс
A/B-тест — обязательный кейс для тех, кто метит в продуктовую аналитику. Он показывает, умеете ли вы правильно формулировать гипотезы, провести A/B-тест и корректно интерпретировать результат.
Структура кейса: гипотеза → контрольная и тестовая группы → статистический тест → бизнес-вывод. До запуска обязателен power analysis — расчёт минимально необходимого размера выборки. Стандартные параметры: α=0.05 (уровень значимости) и β=0.2 (допустимая вероятность пропустить реальный эффект). Без этого шага результат нельзя считать надёжным.
p-value — вероятность получить наблюдаемые различия случайно, если на самом деле эффекта нет. Стандартный порог: p < 0.05 означает, что различие статистически значимо с 95% уверенностью. Пример плохого вывода: «Конверсия группы A = 3.2%.» Пример хорошего: «Рост на 0.9 процентного пункта, p=0.032 — различие статистически значимо, рекомендуем раскатить изменение на всю аудиторию.»
Инструменты: Python-библиотеки scipy.stats и statsmodels. Умение работать со статистическими тестами — навык, который работодатели проверяют на собеседовании напрямую.
Когортный анализ и retention
Когортный анализ — отслеживание поведения группы пользователей с одинаковой датой регистрации во времени. Ключевые метрики: Retention Day 1 / Day 7 / Day 14 / Day 30 и churn rate (доля ушедших). Рассчитать retention — значит понять, насколько продукт удерживает людей после первого визита.
Как строить: группировка событий по дате первого визита → расчёт доли вернувшихся через N дней → сводная таблица когорт. Визуализация: тепловая карта (heatmap) когорт и кривая удержания — инструмент seaborn. Базовый стек: SQL (GROUP BY, DATE-функции) + Python pandas.
Отраслевой ориентир для сервисов доставки еды: Day 1 Retention = 50–55%. Низкое значение сигнализирует о проблемах с онбордингом — процессом знакомства нового пользователя с продуктом.
Пример кейса: сравнение когорт января и марта после запуска реферальной программы — рост Retention на 5–6 процентных пунктов. Именно такой формат объясняет, что изменилось в поведении пользователей и почему это важно для бизнеса.
Анализ воронок и юнит-экономики
Анализ воронок (funnel analysis) — путь пользователя от первого контакта до целевого действия с выявлением этапов с наибольшим оттоком. Юнит-экономика отвечает на вопрос «зарабатывает ли продукт?» через метрики LTV (Lifetime Value — суммарная выручка с одного пользователя), CAC (Customer Acquisition Cost — стоимость привлечения) и срок окупаемости (payback period).
Этот кейс особенно уместен для финтех-продуктов, SaaS и подписочных сервисов. Инструменты: SQL для расчёта воронок, Excel или Python для LTV/CAC-модели. Если у вас есть доменная экспертиза в финансах или e-commerce — добавьте этот кейс: он выделяет портфолио на фоне стандартных EDA и SQL-проектов.
Где найти данные для кейсов
Три рабочие стратегии: публичные датасеты с готовой лицензией, публичные API с кодом на Python, синтетические данные собственной генерации. Как найти проекты для портфолио аналитика — прежде всего через открытые источники с лицензиями CC BY или MIT.
Что нельзя: рабочие данные с предыдущего места работы (нарушение соглашения о неразглашении), парсинг сайтов без разрешения, персональные данные пользователей.
Kaggle и другие платформы с публичными датасетами
Kaggle (kaggle.com/datasets) — крупнейшая платформа с публичными датасетами. Стартовые наборы для кейсов: Online Retail (500 000 транзакций интернет-магазина), Instacart Orders (заказы продуктового сервиса), Google Analytics Sample (данные реального e-commerce сайта).
Помимо датасетов, у Kaggle есть соревновательная система рейтинга: активный профиль с публичными тетрадями (notebooks) — сигнал вовлечённости для работодателя. Ссылку на Kaggle стоит добавить в резюме рядом с GitHub.
Google Dataset Search (datasetsearch.research.google.com) — поисковик по открытым данным. Для российской аудитории важен data.gov.ru — портал открытых государственных данных с наборами по транспорту, здравоохранению, городской инфраструктуре. Публичные API (GitHub, Reddit, Spotify) дают уникальные датасеты — работа с ними демонстрирует навык автономного сбора данных.
Синтетические данные: когда и как создавать
Если подходящего датасета нет — сгенерируйте данные самостоятельно. Python-библиотека Faker создаёт таблицы пользователей, событий и транзакций с реалистичными полями: имена, даты, суммы, идентификаторы. Локаль faker.ru_RU выдаёт русскоязычные данные. Без кода подойдёт Mockaroo (mockaroo.com) — онлайн-генератор до 1 000 строк бесплатно.
Главное правило: явно укажите в кейсе, что данные синтетические. Это критично для доверия рекрутёра. Попытка выдать синтетику за реальные данные разрушается при первом же уточняющем вопросе на собеседовании. Честная пометка «данные сгенерированы через Python Faker» показывает навык и не вызывает вопросов — это плюс.
Как оформить проект на GitHub
GitHub — де-факто стандарт хранения кода для аналитика. Нанимающие менеджеры привыкли к нему и сразу оценивают качество README, структуру репозитория и читаемость кода. Портфолио data analyst на GitHub — это ещё и демонстрация культуры разработки.
Хотите сменить профессию или повысить квалификацию?
Федеральный проект «Активные меры содействия занятости» даёт возможность пройти обучение бесплатно за счёт государства
- Программы от ведущих вузов России — от 2 месяцев
- Удостоверение или диплом установленного образца
- Центр карьеры: 7 500+ вакансий, помощь с трудоустройством
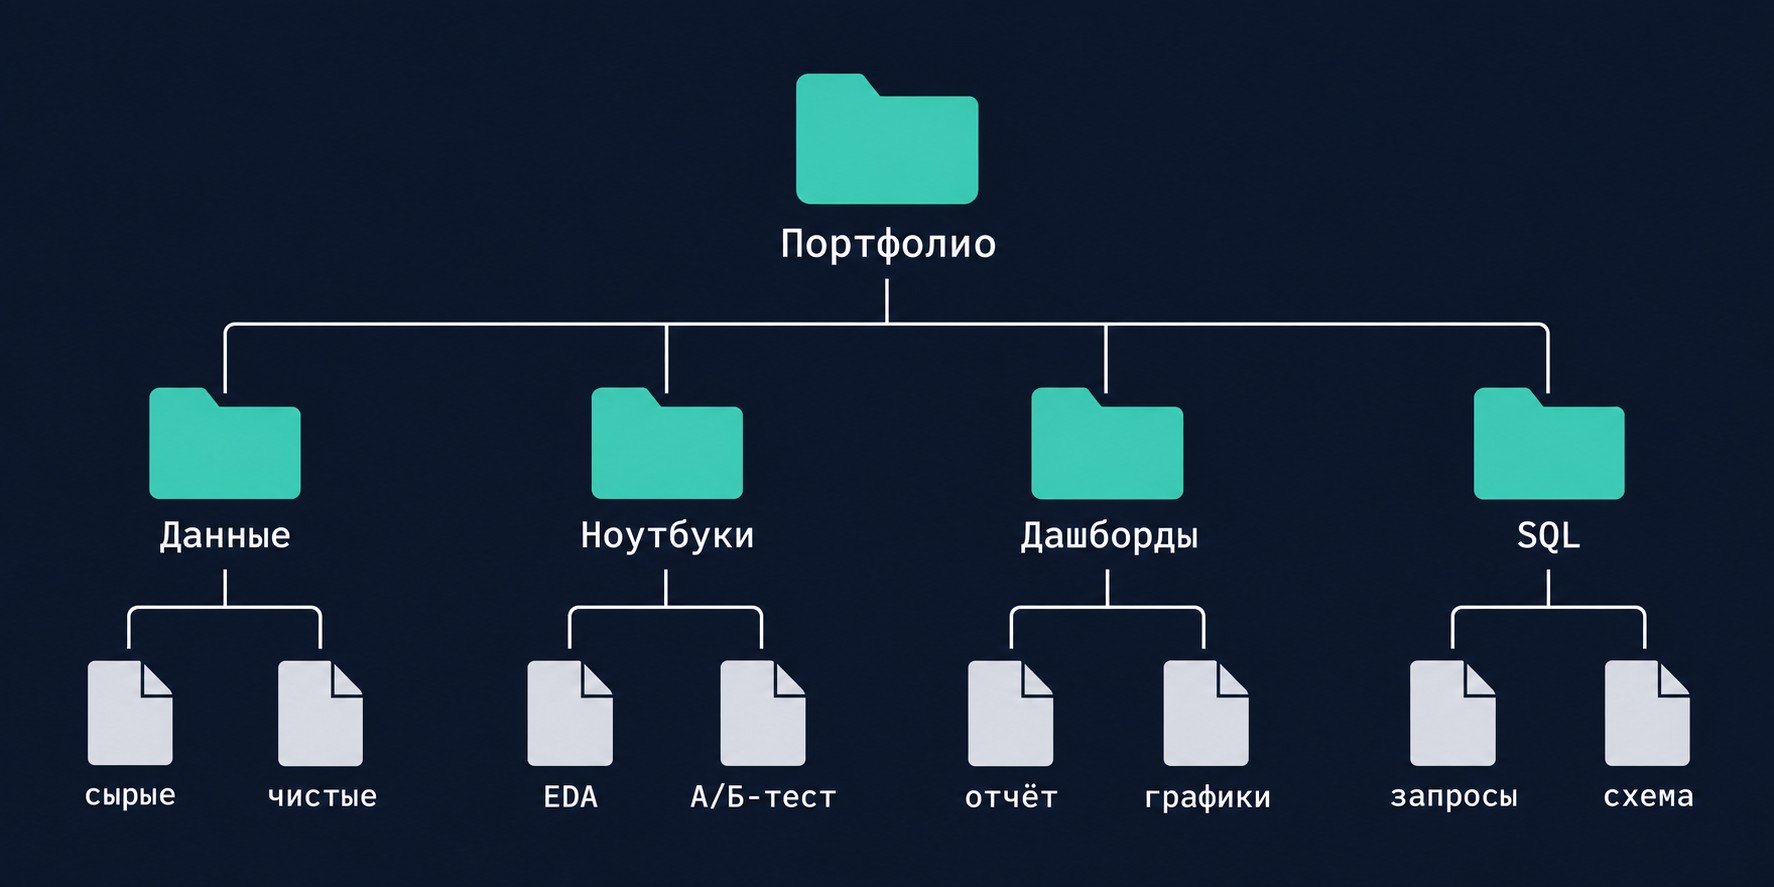
Рекомендуемая структура репозитория:
portfolio-data-analyst/
├── README.md # Описание портфолио и контакты
├── 01-eda/ # Разведочный анализ
│ ├── README.md # Задача, данные, выводы
│ ├── notebook.ipynb # Jupyter Notebook с кодом
│ └── data/ # Данные или ссылка на источник
├── 02-sql/ # SQL-проект
├── 03-dashboard/ # Дашборд — ссылка и скриншоты
└── 04-ab-test/ # A/B-тест
README каждого проекта — первое, что откроет рекрутёр. Структура: задача → данные → инструменты → ключевые выводы → рекомендации. Это краткое резюме кейса, которое читается за 1–2 минуты.
Требования к коду: понятные имена переменных, комментарии к нестандартным шагам, относительные пути вместо абсолютных, никаких паролей и токенов в коде. Отладочные принты (print statements), оставленные в тетради, и жёстко зашитые пути к файлам — признаки небрежности, которую рекрутёр замечает сразу.
GitHub Pages позволяет создать бесплатный сайт-портфолио на адресе username.github.io — удобная альтернатива Notion для тех, кто хочет показать технические навыки дополнительно.
Платформы для публикации портфолио аналитика
Выбор платформы зависит от того, какое первое впечатление вы хотите произвести и насколько хорошо знакомы с Git.
| Платформа | Технические навыки | Внешний вид | Видимость кода | Кому подойдёт |
|---|---|---|---|---|
| Notion | Не требуются | Профессиональный | Блоки кода и скриншоты | Всем, особенно джунам |
| GitHub Pages | Markdown / HTML | Технический | Полная | Тем, кто знает Git |
| Telegram-канал | Минимальные | Неформальный | Ограниченная | Как дополнение |
Notion — оптимальный старт для большинства: красивое оформление без кода, публичная ссылка, поддержка таблиц, скриншотов и блоков кода. Структура: главная страница «Обо мне + Стек» → подстраницы для каждого кейса → ссылки на GitHub и контакты. Ссылку из Notion вставляйте в резюме и LinkedIn.
GitHub Pages подходит тем, кто уже работает с Git: портфолио на Markdown, интеграция с репозиторием, ссылка в шапке профиля. Telegram-канал — быстрый старт, кейсы публикуются постепенно, но выглядит менее профессионально и хуже индексируется.
LinkedIn: заполните раздел Featured (Избранное) — добавьте ссылку на Notion или GitHub Pages. В разделе About — краткое описание стека и типов задач, которые вы умеете решать.
Типичные ошибки при создании портфолио аналитика
Ошибка 1: Учебные проекты с курсов без переработки. Рекрутёр видел сотни одинаковых работ с типовыми заданиями. Добавьте собственные гипотезы, дополнительный анализ, новые визуализации и рекомендации — тогда кейс перестаёт быть узнаваемым шаблоном.
Ошибка 2: Нет бизнес-контекста и рекомендаций. «Построил график зависимости конверсии от дня недели» — наблюдение. Должно быть следствие: что рекомендуете изменить и почему. Без этого кейс не завершён.
Ошибка 3: Датасеты Titanic и Iris. Это классические наборы для задач науки о данных (Data Science) — машинного обучения и классификации. Для аналитика данных они неуместны: сразу сигнализируют об отсутствии понимания специфики профессии.
Ошибка 4: Нет README и ссылки на код. Рекрутёр не будет разбираться в структуре проекта без навигации. README — обязательный элемент каждого репозитория.
Ошибка 5: Грязный код. Абсолютные пути, пароли в коде, незакомментированные отладочные принты — признаки небрежности. Это не технические навыки напрямую, но они влияют на первое впечатление.
Ошибка 6: Слишком много поверхностных кейсов. Десять проектов с одним графиком в каждом хуже трёх глубоких с полноценным анализом, выводами и рекомендациями.
Как использовать портфолио при поиске работы
Ссылку на портфолио ставьте в шапку резюме — рядом с именем и контактами. В сопроводительном письме упоминайте конкретный кейс, релевантный вакансии. В LinkedIn — ссылку в раздел Featured.
| Вопрос на собеседовании | Плохой ответ | Хороший ответ |
|---|---|---|
| «Расскажите о проекте» | «Анализировал данные, строил графики» | «Задача: выяснить, почему падает Day 7 Retention. Данные — 6 месяцев событий. SQL + Python. Вывод: сдвиг онбординговых писем с Day 2 на Day 1 поднял Retention на 4 п.п.» |
| «Какие инструменты знаете?» | «SQL, Python, Tableau» | «SQL с оконными функциями — в SQL-кейсе. Python с pandas и scipy — в A/B-тесте. Tableau Public — дашборд доступен по ссылке» |
| «Что такое p-value?» | «Статистическая метрика» | «Вероятность получить такой результат случайно. p < 0.05 — различие значимо с 95% уверенностью. В A/B-кейсе рассчитал выборку через power analysis до запуска» |
Структура ответа «расскажите о проекте»: контекст (1–2 предложения) → задача → что сделали → результат. Укладывайтесь в 1–2 минуты. Публикация кейса в профессиональном сообществе — дополнительная видимость: рекрутёры находят кандидатов через контент.
Если вы только начинаете путь в аналитику данных — посмотрите программы в рамках федерального проекта «Активные меры содействия занятости». Программа Специалист по аналитике и базам данных в информационных системах рассчитана на обучение с нуля, проводится онлайн и не требует отрыва от текущей работы — всё за счёт государственного финансирования. Смотрите каталог доступных программ.
Часто задаваемые вопросы
Сколько кейсов нужно в портфолио аналитика данных без опыта?
Минимальный набор — 3 кейса: EDA, SQL-проект или дашборд, A/B-тест или когортный анализ. Важно покрыть разные навыки, а не гнаться за количеством. Рекрутёр тратит 5–7 минут на просмотр — 3 глубоких кейса с бизнес-выводами ценнее 10 поверхностных.
Можно ли использовать учебные проекты с курсов?
Да, но только после переработки: добавьте собственные гипотезы, дополнительный анализ, другие визуализации и конкретные рекомендации. Курсовой проект без изменений рекрутёр узнаёт сразу — он видел сотни таких работ.
Обязателен ли GitHub для портфолио дата-аналитика?
Для Python и SQL-проектов GitHub — де-факто стандарт: нанимающие менеджеры привыкли к нему и оценивают качество README и кода. Для дашбордов подойдут Tableau Public или Yandex DataLens. Ссылку на GitHub указывайте в каждом кейсе и в резюме.
Как придумать бизнес-контекст для кейса с Kaggle-датасетом?
Создайте гипотетический сценарий: «Представим, что я аналитик в сервисе доставки еды — задача понять, почему Day 1 Retention ниже отраслевого ориентира 50–55%.» Kaggle-данные становятся «рабочими», выводы — реальными рекомендациями для воображаемого продукта.
Зачем в A/B-кейсе нужен p-value и как его объяснить?
p-value — вероятность получить такой результат случайно. Стандартный порог: p < 0.05 означает статистически значимый результат с 95% уверенностью. В кейсе обязательны: формулировка гипотезы, расчёт выборки (power analysis), p-value, доверительный интервал и бизнес-рекомендация.
Можно ли использовать синтетические данные в портфолио?
Да, это профессионально и законно. Генерируйте через Python Faker (локаль faker.ru_RU) или Mockaroo. Обязательно укажите в кейсе, что данные синтетические — не выдавайте их за реальные. Это критично для доверия и дополнительно демонстрирует навык работы с данными с нуля.
Сколько времени занимает создание портфолио аналитика данных?
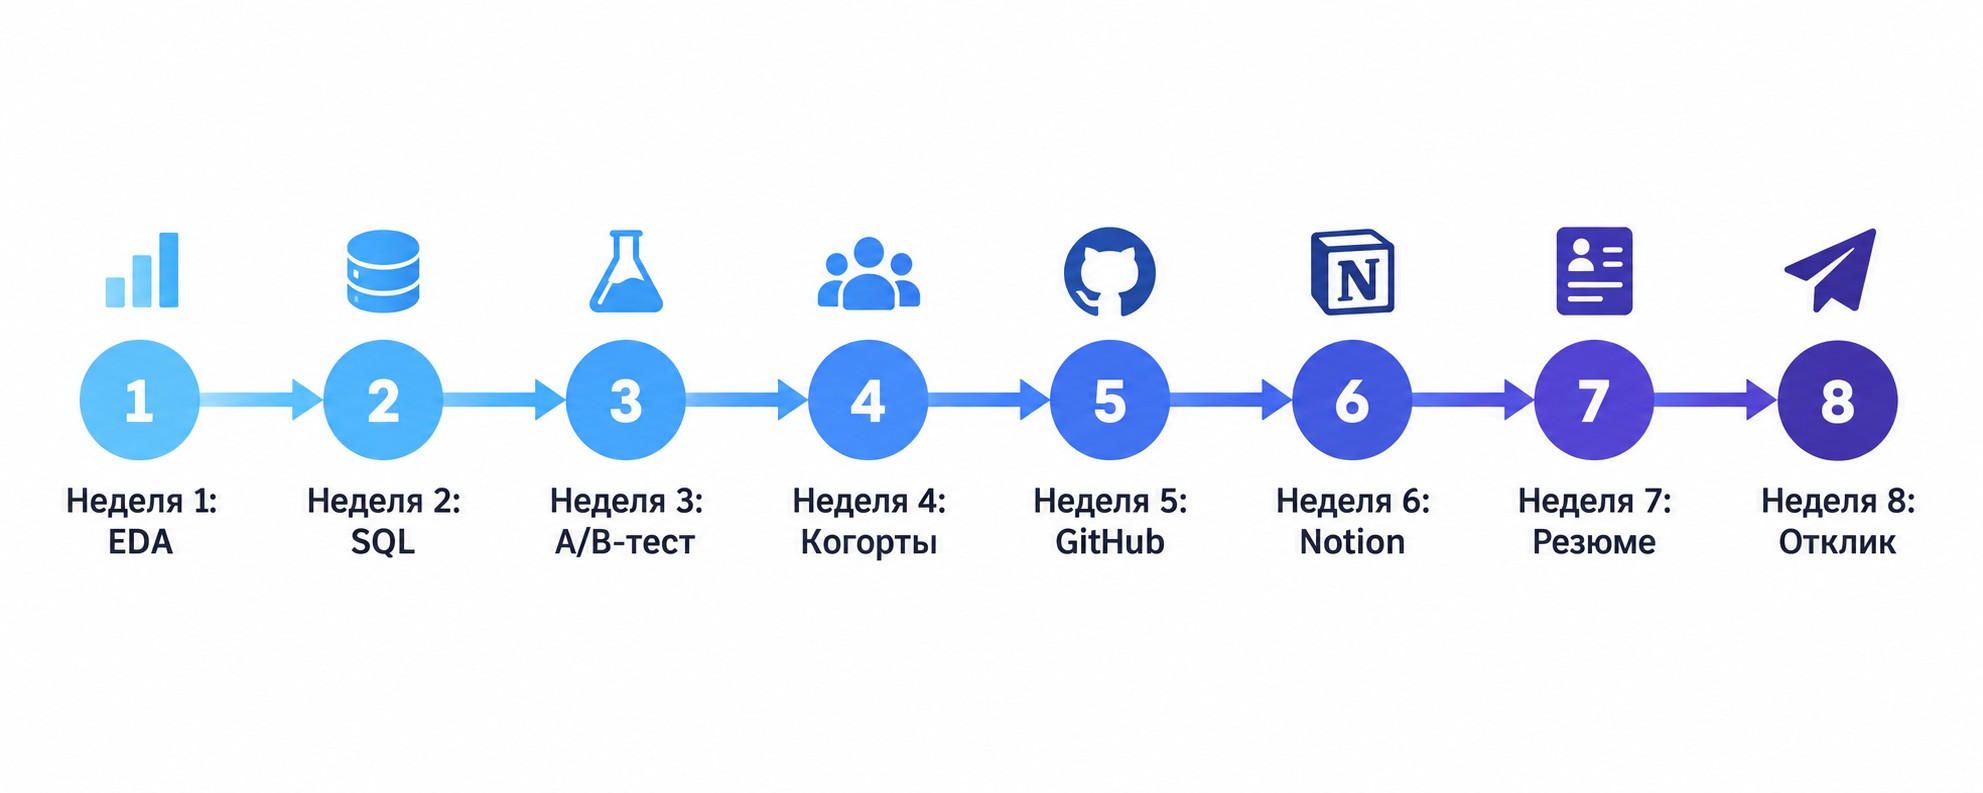
Один кейс — 10–20 часов (поиск данных, анализ, оформление). Три кейса плюс оформление на Notion или GitHub — 35–70 часов итого. При темпе 2–3 часа в день это 1–2 месяца. Лучше не торопиться: глубокий кейс с выводами ценнее быстрого и поверхностного.
Как выделиться среди одинаковых портфолио?
Три способа: добавьте бизнес-рекомендации к каждому графику — большинство кандидатов этого не делают. Создайте пет-проект на стыке с вашей прошлой экспертизой (ритейл, медицина, логистика) — уникальный угол запоминается. Добавьте в кейс раздел «Что бы улучшил» — это показывает зрелость аналитического мышления.
Как оформить портфолио без навыков HTML и вёрстки?
Notion — лучший выбор: красивое оформление без кода, публичная ссылка, поддержка таблиц, скриншотов и блоков кода. Создайте главную страницу «Обо мне + Навыки» и подстраницы для каждого кейса. Ссылку из Notion ставьте в резюме и LinkedIn.
Стоит ли добавлять Kaggle-профиль в резюме и LinkedIn?
Да, если у вас есть соревновательный рейтинг или публичные тетради (notebooks) с откликами. Многие работодатели воспринимают активность на Kaggle как сигнал вовлечённости в профессию. Добавьте ссылку в раздел «Контакты» рядом с GitHub и LinkedIn.
Подайте заявку —
забронируйте место в группе
45 000 мест на 2026 год. Бесплатное обучение по федеральному проекту «Активные меры содействия занятости»
- Онлайн
- От 2 месяцев
- Бесплатно
- Диплом