SLA: что это такое простыми словами — соглашение об уровне обслуживания и как оно работает
SLA: что это такое простыми словами — соглашение об уровне обслуживания и как оно работает
SLA (Service Level Agreement) — соглашение об уровне обслуживания между поставщиком услуг и заказчиком. Это не просто договор о том, что делается, а документ, фиксирующий, насколько хорошо: в числах, сроках и с ответственностью за нарушения. Термин пришёл из методологии ITIL (IT Infrastructure Library) — библиотеки лучших практик управления IT-сервисами. Если договор — это «паспорт услуги», то SLA — её «паспорт качества». В статье разберём структуру соглашения, ключевые метрики, виды SLA, отличие от OLA и KPI, пошаговый план составления и типичные ошибки.
Что такое SLA и в чём его суть
SLA расшифровывается как Service Level Agreement — в переводе на русский это «соглашение об уровне сервиса» или «соглашение об уровне обслуживания». Документ закрепляет измеримые параметры качества: доступность сервиса, время реакции на обращения, скорость устранения инцидентов и производительность.
Учитесь бесплатно за счёт государства
Экономия до 100 000 ₽ на любой программе
Концепция SLA возникла в рамках методологии ITIL, которая описывает жизненный цикл IT-услуги в пяти этапах — от стратегии до непрерывного улучшения. Сегодня соглашение применяют далеко за пределами IT: контакт-центры, HR-службы, отделы административно-хозяйственного обеспечения, облачные провайдеры и компании на IT-аутсорсинге используют SLA как стандартный инструмент управления качеством.
Стороны соглашения — поставщик услуг (Service Provider) и заказчик. Для провайдера SLA структурирует внутренние процессы и снижает риск споров: понятные правила устраняют двусмысленность в том, что считать нарушением. Для клиента — это прозрачность: он заранее знает, на каком уровне будет работать сервис и что произойдёт, если этот уровень упадёт.
Чем SLA отличается от обычного договора
Договор оказания услуг описывает, что делается: перечень работ, цену, срок действия. SLA отвечает на другой вопрос — насколько хорошо услуга выполняется — и фиксирует это в измеримых показателях с конкретными числами.
Технически SLA оформляется как приложение к основному договору оказания услуг, а не как самостоятельный юридический документ. Законодательство не обязывает его заключать — это добровольное соглашение сторон. ITIL и COBIT (корпоративная система IT-управления, охватывающая требования ISO, GDPR и SOX) рекомендуют SLA как лучшую практику управления IT-сервисами.
Главное отличие: договор — обязательство выполнить работу; SLA — обязательство выполнить её на конкретном уровне качества, подкреплённое санкциями за отклонение.
Зачем нужен SLA — задачи и преимущества
SLA решает сразу несколько задач — для каждой из сторон они разные.
| Задача | Как помогает SLA |
|---|---|
| Фиксация уровня сервиса | Прописывает конкретные числовые обязательства, исключая разночтения |
| Контроль KPI | Даёт единые критерии оценки работы провайдера |
| Управление ожиданиями | Снижает количество споров о том, что считать нарушением |
| Компенсация убытков | Закрепляет механизм Service Credits при нарушении условий |
| Автоматизация отчётности | Упрощает внедрение ITSM-систем с автоматическим трекингом |
Для провайдера соглашение об уровне обслуживания помогает распределить ресурсы, оптимизировать процессы и снизить финансовые риски. Для клиента SLA — гарантия прозрачности и инструмент защиты: он знает, что при систематических нарушениях вправе потребовать компенсацию или расторгнуть договор.
Соглашение об уровне сервиса применяется в Service Desk, облачных сервисах, IT-аутсорсинге, контакт-центрах и корпоративном HR. Везде, где услугу можно измерить — SLA будет уместен.
Из чего состоит SLA — структура соглашения
Стандартный SLA включает десять разделов. Чем точнее они прописаны, тем проще контролировать выполнение и избегать разногласий.
| Раздел | Что содержит |
|---|---|
| 1. Описание услуги | Что конкретно предоставляется и в каком объёме |
| 2. Стороны соглашения | Провайдер и заказчик; ответственные лица с обеих сторон |
| 3. KPI и метрики | Числовые показатели качества с формулами расчёта |
| 4. Время обслуживания | Часы доступности (рабочее время / 24×7) |
| 5. Приоритеты инцидентов | Классификация P1–P4 и сроки реакции для каждого |
| 6. Санкции и компенсации | Механизм Service Credits: триггеры и размер |
| 7. Исключения | Форс-мажор, плановые технические работы, вина клиента |
| 8. Мониторинг и отчётность | Инструменты, частота, формат отчётов |
| 9. Порядок эскалации | Кто принимает решение при спорах и нарушениях |
| 10. Условия пересмотра | Когда и как пересматривается SLA |
Ключевые KPI и метрики SLA
Основу SLA составляют измеримые KPI — показатели, по которым оценивают качество сервиса. Каждый показатель становится целевым значением (SLO), а фактические данные собирает инструмент мониторинга и передаёт в виде SLI.
| Метрика | Что измеряет | Пример цели | Формула расчёта |
|---|---|---|---|
| Доступность (Availability) | Процент времени работоспособного сервиса | ≥99,9% в месяц | (Общее время − Простой) / Общее время × 100% |
| Время реакции | Скорость первого ответа на обращение | ≤30 мин для P2 | Момент обращения → первый ответ агента |
| MTTR | Среднее время восстановления сервиса | ≤2 ч для P1 | От регистрации инцидента до закрытия тикета |
| Производительность | Скорость и стабильность отклика | API ≤200 мс в 95% запросов | Медиана / 95-й процентиль времени отклика |
| SLA Compliance | Доля обращений, закрытых в срок | ≥95% | (Закрыто в срок / Всего обращений) × 100% |
Связка работает по цепочке: инструмент мониторинга фиксирует фактический SLI → сравнивает с целью SLO → при приближении к пороговому значению SLA отправляет алерт. Команда реагирует до нарушения, а не после.
Уровни доступности (Uptime) — таблица «девяток»
Доступность в SLA принято выражать в «девятках» — количестве цифр 9 после запятой. Чем больше девяток, тем жёстче требования и короче допустимый простой.
| Уровень Uptime | Простой в месяц | Простой в год |
|---|---|---|
| 99% | ≤7 ч 18 мин | ≤87,6 ч |
| 99,9% | ≤43 мин | ≤8,8 ч |
| 99,95% | ≤21 мин | ≤4,4 ч |
| 99,99% | ≤4 мин | ≤52 мин |
| 99,999% | ≤26 сек | ≤5,3 мин |
Числовой пример расчёта: в месяце 720 часов; простой 43 минуты (0,72 ч) → (720 − 0,72) / 720 × 100% ≈ 99,9%. Именно этот расчёт лежит в основе SLA облачных провайдеров уровня «три девятки». Уровни доступности коррелируют с классификацией Datacenter Tier I–IV: дата-центр Tier IV обеспечивает uptime 99,995%.
Виды SLA — классификация по типу и пакету обслуживания
SLA классифицируют по двум осям одновременно: по ориентации (для кого составляется) и по пакету (какой уровень обслуживания включён). Конкуренты, как правило, описывают классификацию по одной оси — практичнее сразу понимать обе.
| Вид | Описание | Пример применения |
|---|---|---|
| По ориентации | ||
| Service-oriented | Единые условия для всех пользователей одной услуги | Корпоративная почта — одинаковый SLA для всех сотрудников компании |
| Customer-oriented | Индивидуальные условия под конкретного заказчика | Крупный клиент IT-аутсорсера с расширенными параметрами |
| Dynamic SLA | Параметры меняются автоматически в зависимости от нагрузки | Облако масштабирует ресурсы в пиковые часы |
| Operational | Внутренний SLA между подразделениями | HR-служба обязуется обработать заявку за 3 рабочих дня |
| По пакету | ||
| Standard | Поддержка в рабочее время, базовые метрики | Малый бизнес — поддержка 9:00–18:00 по рабочим дням |
| Premium | Поддержка 24×7, ускоренное время реакции | Средний бизнес с критичной инфраструктурой |
| Enterprise | Персональный менеджер, минимальное время реакции | Банки, ритейл, телеком |
Например, крупный ритейл берёт Customer-oriented SLA в пакете Enterprise — это персональные условия с реакцией за 15 минут круглосуточно. Динамическое SLA актуально для облачных сервисов: ITSM-системы автоматически фиксируют изменение нагрузки и корректируют приоритеты.
SLA, OLA, SLO и SLI — чем они отличаются друг от друга
Четыре термина часто путают. Вот единая мета-таблица — чтобы разобраться сразу со всеми:
| Термин | Уровень | Что гарантирует / измеряет | Юридический статус |
|---|---|---|---|
| SLA | Внешний (провайдер ↔ клиент) | Уровень сервиса + санкции за нарушение | Договорное обязательство |
| OLA | Внутренний (отдел ↔ отдел) | Выполнение внутренних условий для обеспечения SLA | Внутренний регламент |
| SLO | Внутри SLA | Целевое значение конкретного KPI (например, uptime ≥99,9%) | Часть договора, не самостоятельный документ |
| SLI | Измерительный | Фактически зафиксированный показатель (реальный uptime 99,95%) | Данные мониторинга, не договор |
Мнемоника: SLI — факт, SLO — цель, SLA — контракт с санкциями, OLA — внутренний регламент.
SLA и OLA — внешнее и внутреннее соглашение
OLA (Operational Level Agreement) — операционное соглашение между подразделениями внутри провайдера. Если SLA — обещание клиенту, то OLA — внутреннее требование, обеспечивающее это обещание.
Пример: в SLA клиенту прописана реакция на инцидент за 30 минут. Чтобы выполнить это обязательство, OLA обязывает DevOps-команду принять тикет от Service Desk в течение 10 минут. OLA входит в процессы управления инцидентами в рамках ITSM и является инструментом выполнения внешнего SLA.
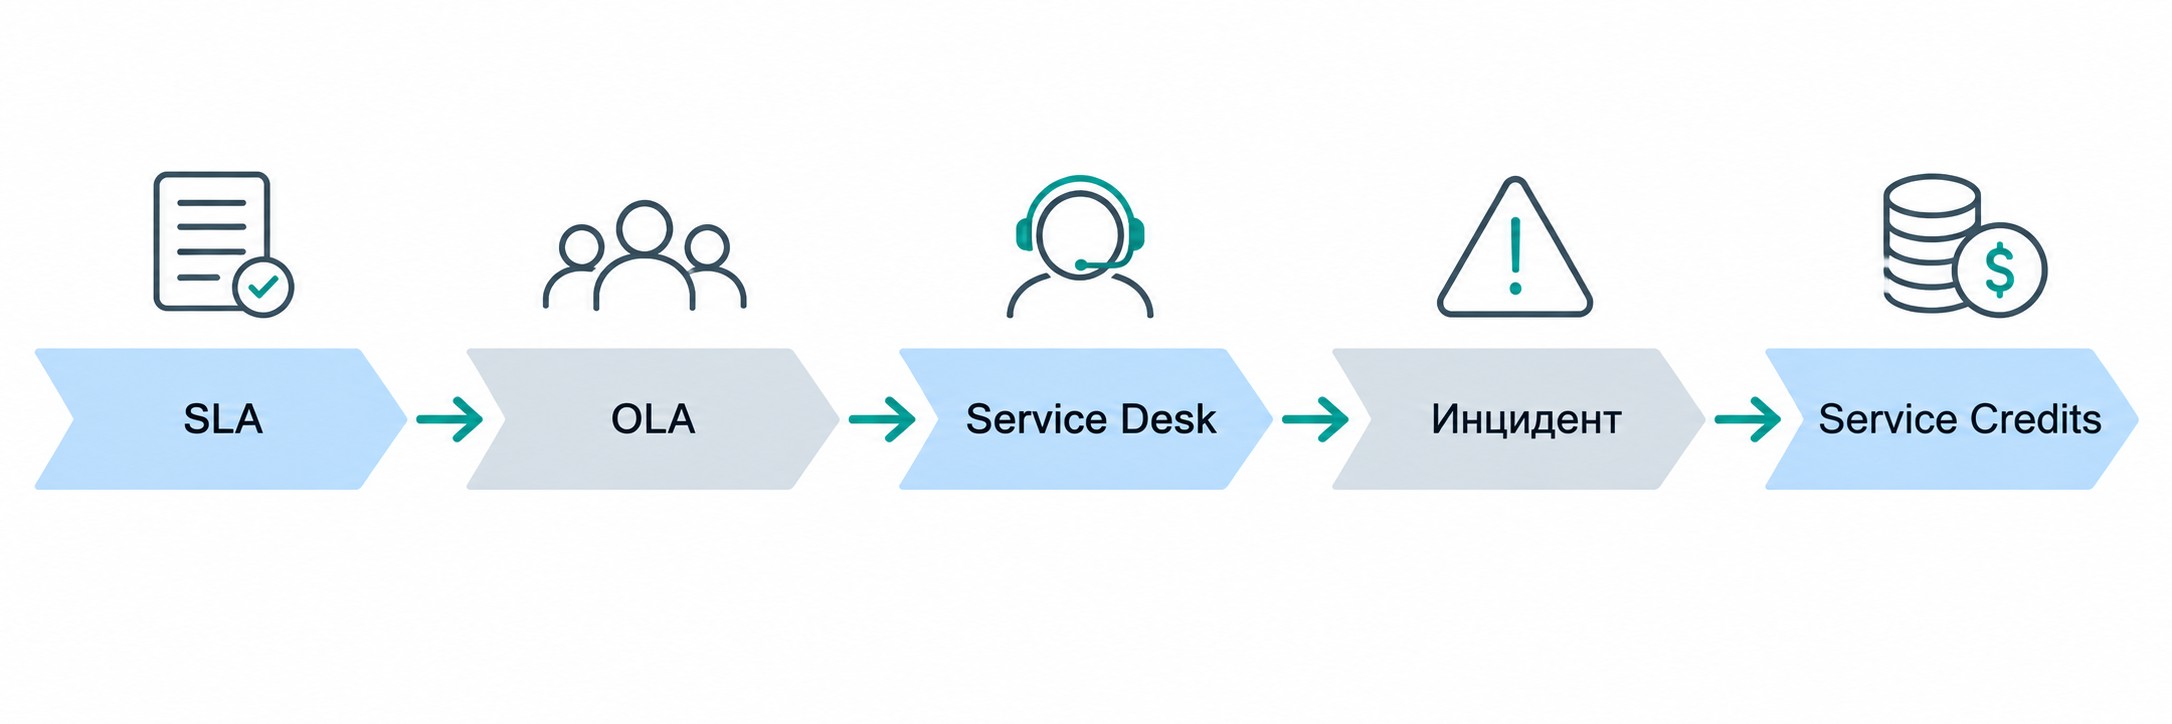
Цепочка выглядит так: клиент фиксирует инцидент → Service Desk регистрирует тикет → по условиям OLA DevOps принимает его в течение 10 минут → инцидент устраняется в рамках согласованного MTTR → если срок SLA нарушен, клиент получает компенсацию в виде Service Credits.
SLA и KPI — договор и метрика
KPI (ключевые показатели эффективности) — внутренняя метрика без юридических последствий. Нарушение KPI ведёт к оптимизации процессов, но не к штрафу и не к компенсации заказчику.
SLA — договор, содержащий KPI плюс ответственность сторон и санкции. KPI входит в SLA как измеримый показатель, но приравнивать эти понятия нельзя.
Пример: KPI отдела поддержки — 90% ответов за 20 минут (внутренняя цель команды). SLA клиенту — ответ за 30 минут с компенсацией при нарушении (внешнее обязательство). Разница не в числах, а в правовых последствиях.
Приоритеты инцидентов в SLA — классификация P1–P4
Управление инцидентами в SLA строится на приоритетах: чем критичнее сбой, тем жёстче сроки реакции и устранения. Стандартная классификация — P1–P4.
| Приоритет | Пример ситуации | Время реакции | Время решения |
|---|---|---|---|
| P1 — Критический | Сайт полностью недоступен для всех пользователей | 15–30 мин | 2 часа |
| P2 — Высокий | Ключевая функция (оплата, авторизация) не работает | 1 час | 8 часов |
| P3 — Средний | Ошибка у отдельных пользователей, обходное решение есть | 4 часа | 3 рабочих дня |
| P4 — Низкий | Консультация или некритичная настройка | 1 рабочий день | По согласованию |
Хотите сменить профессию или повысить квалификацию?
Федеральный проект «Активные меры содействия занятости» даёт возможность пройти обучение бесплатно за счёт государства
- Программы от ведущих вузов России — от 2 месяцев
- Удостоверение или диплом установленного образца
- Центр карьеры: 7 500+ вакансий, помощь с трудоустройством
MTTR считается от момента регистрации инцидента в Service Desk до закрытия тикета. Эскалация между приоритетами регулируется через OLA: если P1 не решается в срок, процесс автоматически передаётся на следующую линию поддержки. При нарушении SLA провайдер предоставляет Service Credits согласно разделу санкций.
Как составить SLA — пошаговый план
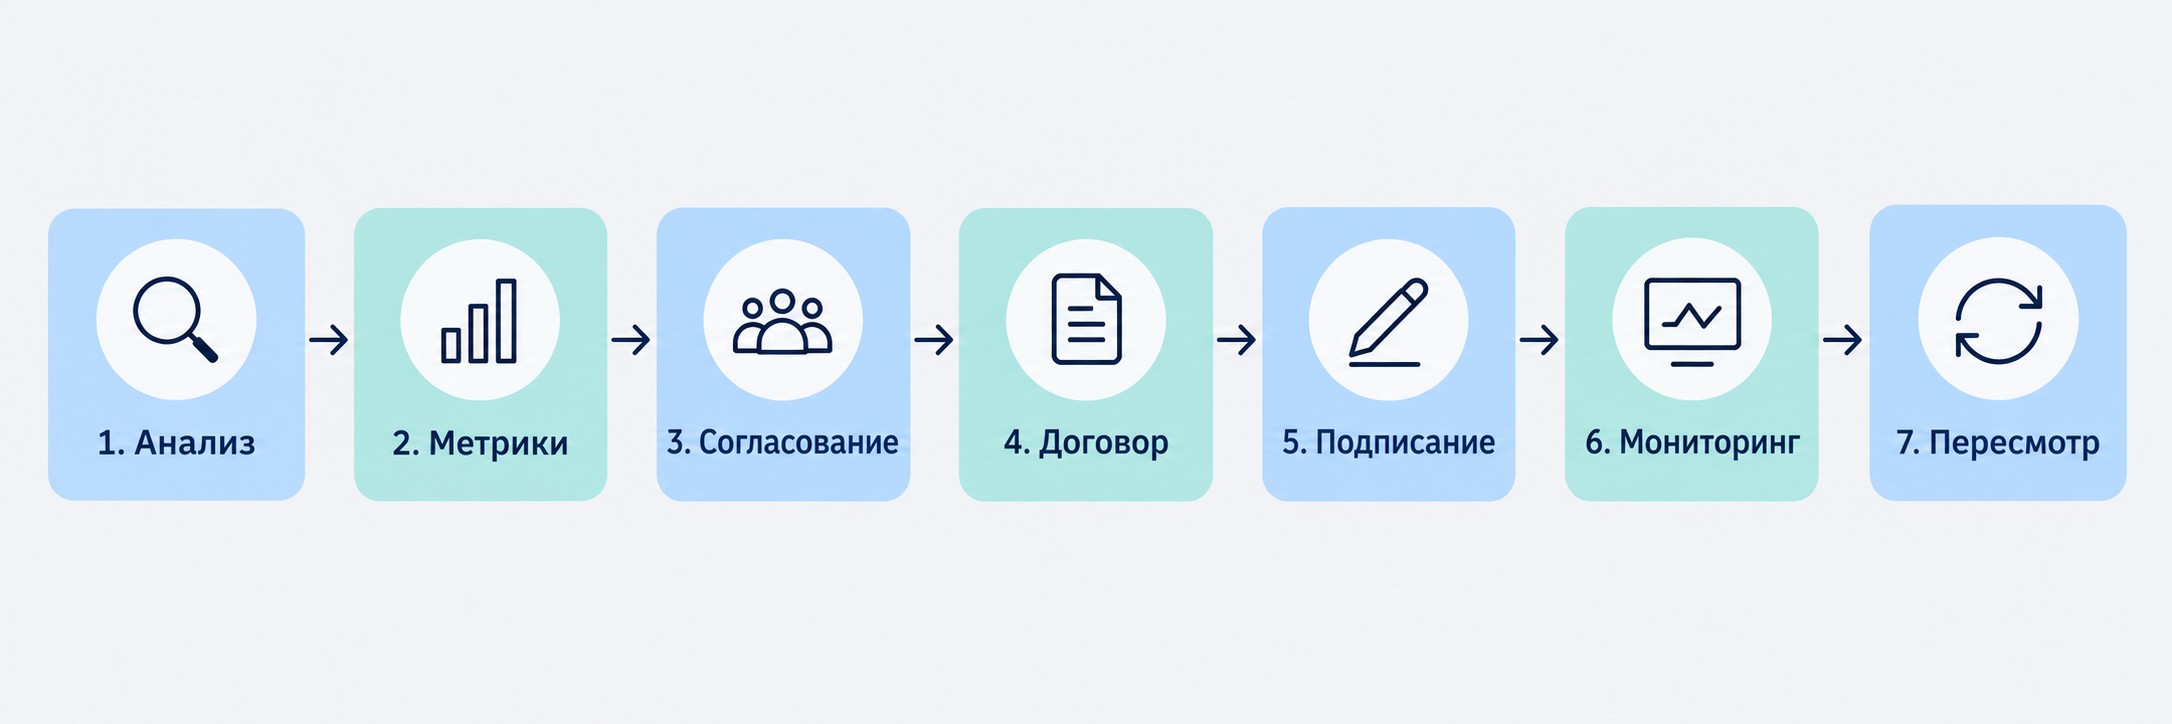
Составление SLA — совместная работа юристов, менеджеров по клиентам и технических специалистов. Стандартный процесс включает семь последовательных шагов.
1. Определить цель. Зафиксировать, какую услугу покрывает SLA и какие потребности клиента он закрывает. Без чёткой цели метрики будут выбраны наугад.
2. Зафиксировать границы. Прописать, что входит в зону ответственности провайдера, а что — нет: форс-мажор, плановые технические работы, действия третьих сторон, ошибки на стороне клиента.
3. Описать метрики. Согласовать измеримые KPI: доступность, время реакции, MTTR, производительность, SLA Compliance. Метрики должны быть достижимыми при текущих ресурсах — нереалистичные SLO подрывают доверие ещё до первого нарушения.
4. Прописать процесс инцидентов. Классифицировать инциденты по приоритетам P1–P4 и установить конкретные сроки реакции и решения для каждого уровня.
5. Закрепить санкции. Описать механизм Service Credits: при каком отклонении активируется компенсация, в каком размере и в каком формате — скидка, возврат, бесплатный период или Remediation Plan.
6. Предусмотреть форс-мажор. Перечислить обстоятельства, освобождающие провайдера от ответственности: аварии у оператора связи, стихийные бедствия, DDoS-атаки третьих сторон, плановые регламентные работы.
7. Настроить мониторинг и отчётность. Выбрать инструменты ITSM, определить частоту отчётов, установить автоматические алерты и зафиксировать ответственных за предоставление данных.
Пересматривать SLA рекомендуется минимум раз в год, оптимально — ежеквартально. Триггеры для внепланового пересмотра: изменение бизнес-процессов, рост нагрузки, смена инфраструктуры, новые требования заказчика.
Типичные ошибки при составлении SLA
Даже хорошо задуманный SLA может оказаться неработающим документом — если при его составлении допущены типовые ошибки.
| Ошибка | Последствие | Решение |
|---|---|---|
| Нечёткие KPI | Невозможно объективно оценить выполнение | Прописать конкретные числовые значения и формулы расчёта |
| Нет раздела исключений | Споры при форс-мажоре или плановых работах | Добавить перечень форс-мажорных обстоятельств и плановых окон |
| Нереалистичные сроки | Постоянное нарушение SLA, потеря доверия | Согласовать метрики, достижимые при текущих ресурсах |
| Нет механизма компенсаций | Нарушение условий без последствий для провайдера | Прописать Service Credits с чёткими триггерами |
| Ручной мониторинг | Ошибки в отчётах, запоздалое обнаружение нарушений | Автоматизировать через ITSM с алертами в реальном времени |
| Нет регламента пересмотра | Устаревший SLA не соответствует реальным условиям | Зафиксировать периодичность и триггеры пересмотра |
Самая частая ошибка — нечёткость формулировок. Если в SLA написано «своевременно» вместо «в течение 30 минут», обе стороны будут трактовать это по-своему. Штрафные санкции без конкретных числовых порогов превращаются в декларацию.
Инструменты для мониторинга и автоматизации SLA
Контролировать выполнение SLA вручную — значит получать данные с опозданием. Современные инструменты автоматически собирают SLI, сравнивают с SLO и сигнализируют о приближении к пороговому значению.
| Инструмент | Категория | Функция |
|---|---|---|
| Zabbix | Мониторинг инфраструктуры | Сбор метрик серверов, сетей, сервисов |
| Prometheus | Мониторинг инфраструктуры | Метрики в реальном времени и автоматические алерты |
| PRTG Network Monitor | Мониторинг инфраструктуры | Мониторинг сети и оборудования с SLA-отчётами |
| New Relic | Мониторинг производительности (APM) | Трассировка запросов, uptime, производительность API |
| Jira Service Management | Тикет-система / ITSM | Трекинг обращений, SLA-таймеры, эскалация |
| ServiceNow | Тикет-система / ITSM | Комплексная ITSM-платформа с SLA-аналитикой |
| OTRS | Тикет-система / ITSM | Система управления инцидентами с открытым кодом |
| AWS Auto Scaling | Автоматизация облака | Масштабирование ресурсов для поддержания доступности |
| Kubernetes | Автоматизация / оркестрация | Управление контейнерами и высокая доступность сервисов |
Логика цепочки: инструменты отслеживают SLI → сравнивают с SLO → при приближении к порогу SLA отправляют алерт → команда реагирует до нарушения, а не после. IT-аутсорсеры с выстроенным ITSM видят отклонения в режиме реального времени и закрывают инциденты быстрее, чем успевает сработать таймер SLA.
Если вы хотите освоить профессию в сфере IT и управления цифровыми процессами — в рамках федерального проекта «Активные меры содействия занятости» нацпроекта «Кадры» можно пройти обучение без вложений по направлениям аналитики, 1С, дизайна, нейросетей и кибербезопасности. Смотрите каталог доступных программ.
Часто задаваемые вопросы
Чем SLA отличается от OLA?
SLA — внешнее соглашение между поставщиком услуг и заказчиком, гарантирующее уровень сервиса клиенту. OLA (Operational Level Agreement) — внутренний документ между подразделениями провайдера, обеспечивающий выполнение внешнего SLA. Пример: SLA гарантирует реакцию за 30 минут, OLA обязывает DevOps принять тикет за 10 минут.
Чем SLA отличается от KPI?
KPI — внутренняя метрика без юридических последствий: нарушение ведёт к оптимизации процессов, но не к штрафу. SLA — договор, содержащий KPI плюс ответственность сторон и санкции за отклонение. Нарушение KPI исправляется внутри команды; нарушение SLA обязывает провайдера выплатить компенсацию.
Что означает SLA 99,9%?
SLA 99,9% гарантирует доступность сервиса не ниже 99,9% времени в расчётном периоде. Допустимый простой — не более 43 минут в месяц и 8,8 часа в год. Для сравнения: SLA 99,99% допускает лишь 4 минуты простоя в месяц.
Чем SLA отличается от SLO и SLI?
SLI (Service Level Indicator) — фактически измеренный показатель, например реальный uptime 99,95%. SLO (Service Level Objective) — целевое значение для SLI внутри SLA: не ниже 99,9%. SLA — юридический контракт с заказчиком, включающий SLO и санкции за отклонение. Формула: SLI — факт, SLO — цель, SLA — контракт.
Что происходит при нарушении SLA?
Провайдер предоставляет компенсацию в рамках механизма Service Credits. Форматы: финансовая выплата в процентах от стоимости услуг, скидка на следующий период, бесплатное продление подписки или Remediation Plan — план устранения причин нарушения. При систематических нарушениях клиент вправе расторгнуть договор без штрафа.
Как рассчитывается доступность сервиса?
Формула: (Общее время − Время простоя) / Общее время × 100%. Пример: в месяце 720 часов, простой 43 минуты (0,72 ч) → (720 − 0,72) / 720 × 100% ≈ 99,9%. Результат сравнивается с целевым SLO. Данные собирают инструменты мониторинга: Zabbix, Prometheus, New Relic.
Обязателен ли SLA по закону?
Нет. Закон не обязывает заключать SLA. Соглашение добровольное и оформляется как приложение к договору оказания услуг по соглашению сторон. ITIL и COBIT рекомендуют его как лучшую практику управления IT-сервисами и корпоративного IT-управления.
Как часто нужно пересматривать SLA?
Рекомендуется минимум раз в год, оптимально — раз в квартал. Триггеры для внепланового пересмотра: изменение бизнес-процессов, рост нагрузки, новые требования клиента, смена оборудования или инфраструктуры. Устаревший SLA с нереалистичными метриками подрывает доверие обеих сторон.
Что такое Service Credits?
Service Credits — механизм компенсации заказчику при нарушении SLA. Провайдер предоставляет скидку на следующий расчётный период, возврат части оплаты, бесплатное продление подписки или Remediation Plan — подробный план действий по устранению причин инцидента. Конкретный формат фиксируется в разделе санкций соглашения.
Кто составляет SLA?
SLA разрабатывается совместно: юристы отвечают за формулировки и санкции, менеджеры по клиентам — за учёт потребностей заказчика, технические специалисты — за реалистичность метрик. Со стороны заказчика участвуют операционные руководители и IT-отдел. Готовое соглашение подписывается обеими сторонами.
Подайте заявку —
забронируйте место в группе
45 000 мест на 2026 год. Бесплатное обучение по федеральному проекту «Активные меры содействия занятости»
- Онлайн
- От 2 месяцев
- Бесплатно
- Диплом