Что такое Apache Kafka: распределённый брокер сообщений и журнал событий
Apache Kafka — распределённая платформа потоковой передачи данных, работающая одновременно как брокер сообщений и неизменяемый журнал событий (commit log). Её создала компания LinkedIn в 2011 году, а затем передала в Apache Software Foundation под лицензией Apache 2.0. Сегодня Kafka обрабатывает миллиарды событий в реальном времени в инфраструктурах Netflix, Uber, Airbnb и Spotify. Главное отличие от классических очередей: сообщения не удаляются после прочтения — каждый консьюмер читает поток независимо, отслеживая свою позицию через числовой идентификатор, называемый смещением (offset).
Apache Kafka — что это такое простыми словами
Представьте книгу, которую одновременно читают несколько человек. У каждого своя закладка: один на странице 10, другой — на 47, третий только открыл первую главу. Никто не мешает друг другу, и страницы из книги не вырываются после прочтения. Именно так устроена Apache Kafka.
Учитесь бесплатно за счёт государства
Экономия до 100 000 ₽ на любой программе
В традиционных очередях сообщений сообщение удаляется, как только его получил консьюмер. Это удобно для задач, где каждую задачу нужно выполнить ровно один раз. Но что, если одно и то же событие должны обработать три независимых сервиса? Или нужно «перемотать» поток назад и переобработать данные? Классическая очередь здесь не поможет.
Apache Kafka решает эту задачу через паттерн «издатель-подписчик» (publish-subscribe). Продюсеры (producers) записывают сообщения в именованные каналы — топики (topics). Консьюмеры (consumers) читают из топиков независимо, каждый с собственной позицией. Если нужно сымитировать поведение обычной очереди — несколько консьюмеров объединяют в Consumer Group: тогда каждое сообщение обработает ровно один из них.
Конкретный пример: интернет-магазин. Когда клиент оформляет заказ, сервис оформления публикует событие order.placed в Kafka. Сервис уведомлений читает его и отправляет письмо. Сервис складского учёта списывает остаток. Сервис аналитики записывает данные в хранилище. Все три работают независимо и асинхронно — никто не ждёт ответа от других через прямой вызов. Если сервис уведомлений был недоступен час, он прочитает пропущенные события, когда восстановится: Kafka хранит сообщения по умолчанию 7 дней.
Apache Kafka — это распределённый, отказоустойчивый журнал событий. Не просто очередь, а фундамент для событийно-ориентированных (event-driven) архитектур, где сервисы общаются через события, а не через прямые вызовы.
Архитектура Apache Kafka: ключевые компоненты
Apache Kafka — не одна программа, а кластер из нескольких узлов-брокеров. Для отказоустойчивости минимальный рекомендуемый размер кластера — три брокера. Вот семь ключевых компонентов, из которых состоит Kafka:
- Топик (Topic) — именованный канал, в который пишут продюсеры и из которого читают консьюмеры.
- Партиция (Partition) — физическое разделение топика; гарантирует порядок сообщений внутри себя.
- Продюсер (Producer) — компонент, публикующий сообщения в топик.
- Консьюмер (Consumer) — компонент, читающий сообщения из топика.
- Consumer Group — группа консьюмеров, которые совместно обрабатывают топик как очередь.
- Брокер (Broker) — узел кластера, хранящий партиции и обслуживающий запросы.
- Контроллер (Controller) — управляет выборами лидеров и метаданными кластера.
Каждый из этих компонентов выполняет строго свою роль. Именно разделение обязанностей и позволяет Kafka масштабироваться горизонтально без остановки сервиса.
Топик и партиция: как устроено хранение данных
Топик — это не единая очередь, а логический контейнер. Внутри каждый топик разбит на партиции — независимые последовательности сообщений, растущие только вперёд (append-only). Именно такая организация позволяет Kafka параллельно читать один топик несколькими консьюмерами одновременно.
Физически каждая партиция хранится как набор сегментов — файлов с расширением .log. К каждому сегменту прилагаются индексные файлы: .index для поиска по смещению и .timeindex для поиска по времени. Это обеспечивает быстрое позиционирование при чтении даже в топиках с миллиардами сообщений.
Порядок сообщений гарантирован только внутри одной партиции, но не в топике целиком. Если для задачи важна глобальная упорядоченность — топик создают с одной партицией, жертвуя параллелизмом. На практике чаще важен порядок в рамках конкретной сущности: например, все события одного пользователя всегда попадают в одну партицию, если использовать идентификатор пользователя как ключ сообщения.
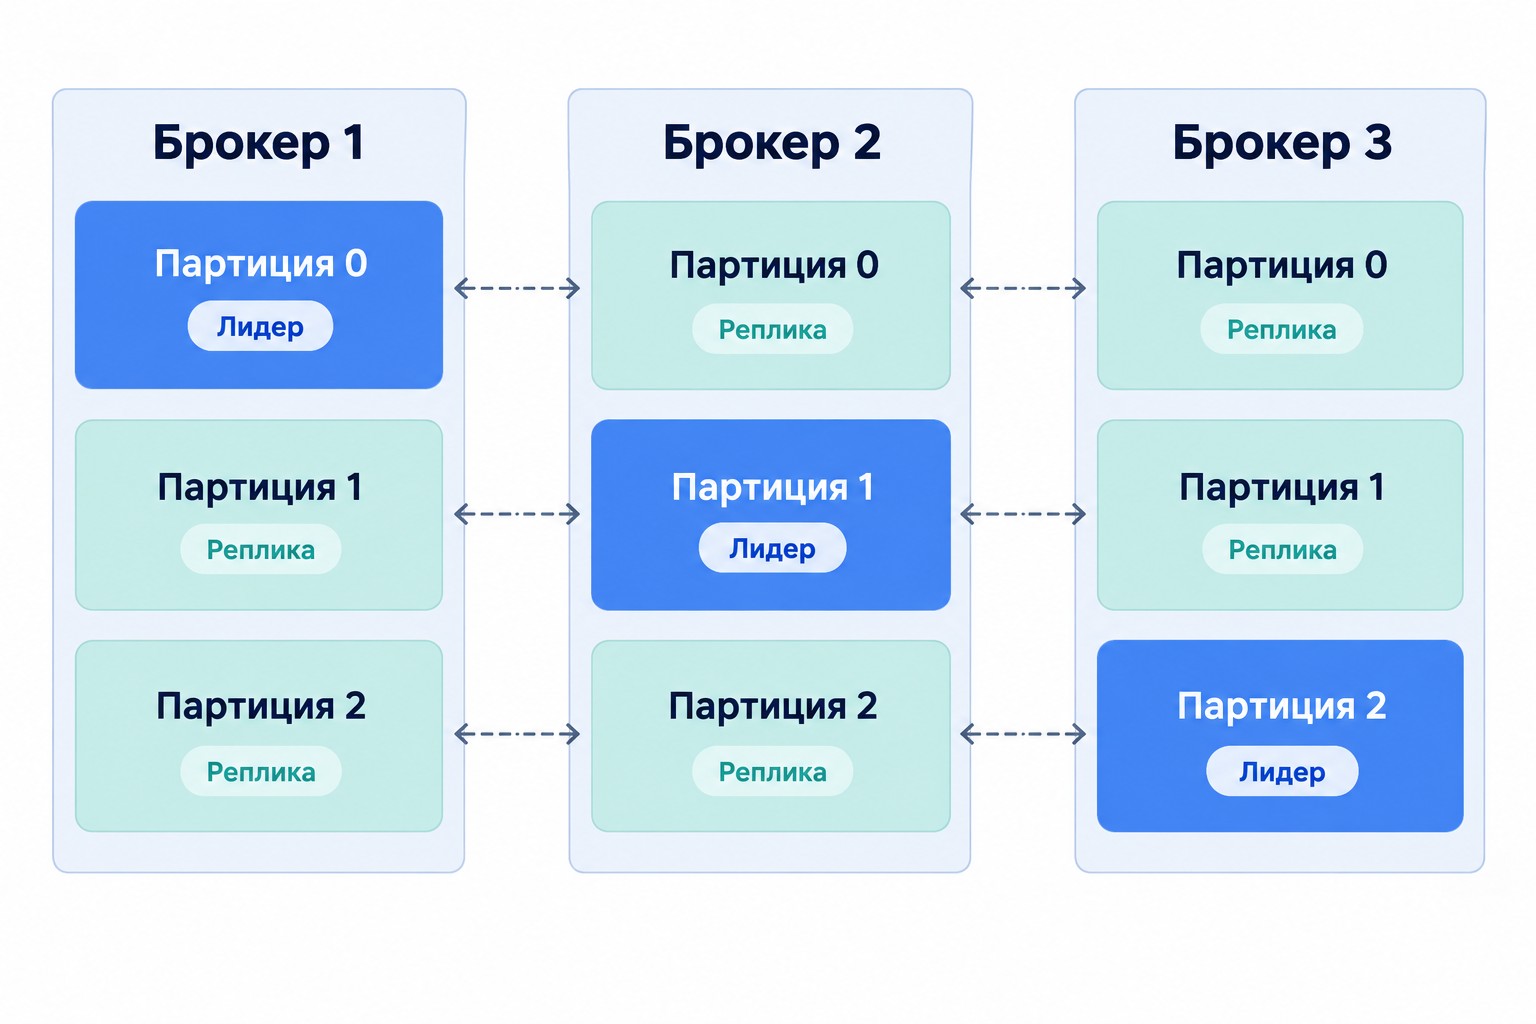
Рекомендуемый фактор репликации — 3: каждая партиция хранится на трёх брокерах. Это обеспечивает сохранность данных даже при одновременном отказе одного узла и плановом обслуживании второго.
Продюсер, консьюмер и Consumer Group
Продюсер решает, в какую партицию отправить сообщение, по следующему алгоритму: если у сообщения есть ключ — выбирается партиция по формуле Hash(key) % количество_партиций. Это гарантирует, что все сообщения с одним ключом попадут в одну партицию. Если ключа нет, современные версии Kafka используют Sticky Partitioning — продюсер заполняет одну партицию пакетом, затем переходит к следующей. Этот подход эффективнее старого Round-Robin, потому что уменьшает количество сетевых запросов.
Консьюмер отслеживает, до какого сообщения он дочитал, через offset. После обработки каждого сообщения (или пакета) он коммитит offset — сохраняет позицию в Kafka. Если консьюмер неожиданно остановится, при перезапуске он продолжит чтение ровно с того места, где остановился. Жизнеспособность консьюмера подтверждается сигналом heartbeat, отправляемым координатору группы. Если heartbeat не поступал 45 секунд, координатор считает консьюмера недоступным и запускает ребалансировку — перераспределяет партиции между оставшимися участниками группы.
Consumer Group объединяет несколько консьюмеров под одним идентификатором group_id. Kafka гарантирует: каждая партиция топика назначена ровно одному консьюмеру внутри группы. Если консьюмеров больше, чем партиций, лишние простаивают без работы. Максимальный полезный параллелизм группы равен числу партиций в топике.
Брокер и контроллер: узлы кластера
Брокер — рабочая лошадка кластера. Он принимает сообщения от продюсеров, хранит партиции на диске и отдаёт данные консьюмерам. Каждый брокер имеет уникальный числовой идентификатор. Один из брокеров дополнительно берёт на себя роль контроллера.
Контроллер следит за состоянием кластера: проводит выборы нового лидера партиции при падении текущего, синхронизирует метаданные и контролирует состав ISR (In-Sync Replicas — синхронизированные реплики).
Исторически Kafka использовала внешний сервис ZooKeeper для координации. Начиная с версии 3.3.1 в продакшен-среде доступен режим KRaft (реализован в рамках предложения KIP-500) — встроенный консенсус-модуль, полностью заменяющий ZooKeeper. KRaft упрощает развёртывание: больше не нужно поддерживать отдельный кластер, метаданные хранятся непосредственно в Kafka.
Как работает Apache Kafka: передача, хранение и надёжность
Жизнь сообщения в Kafka выглядит так: продюсер отправляет его брокеру-лидеру партиции → брокер записывает в append-only log и реплицирует на фолловеры → консьюмер читает сообщение, обрабатывает и коммитит offset. Два механизма обеспечивают надёжность этого цикла: репликация партиций и сохранение смещения.
Репликация партиций и отказоустойчивость
Каждая партиция существует в кластере в нескольких экземплярах: один лидер и несколько фолловеров. Лидер обрабатывает все запросы на чтение и запись. Фолловеры синхронизируются, реплицируя данные лидера в фоновом режиме.
ISR — это набор реплик, которые полностью синхронизированы с лидером (или отстают не более чем на допустимую задержку). Если лидер партиции выходит из строя, новый лидер выбирается только из ISR. Это принципиально важно: реплика вне ISR может содержать устаревшие данные, и её выбор лидером привёл бы к потере части сообщений.
Рекомендуемое значение min.insync.replicas при трёх брокерах — 2, а не 3. Если установить значение 3, то при кратковременной недоступности даже одного брокера Kafka заблокирует все записи: условие «не менее 3 синхронизированных реплик» нарушено, хотя два брокера работают нормально. Значение 2 обеспечивает баланс: кластер продолжает принимать записи, пока хотя бы два узла здоровы.
Параметр acks и гарантии доставки сообщений
Продюсер настраивает желаемую надёжность через параметр acks:
| acks |
Гарантия |
Риск |
Сценарий |
|---|---|---|---|
| 0 | at-most-once | Потеря данных при сбое | Метрики, логи низкой важности |
| 1 | at-least-once | Дублирование при падении лидера до репликации | Чат, уведомления |
| all | at-least-once (надёжный) | Снижение пропускной способности | Финансовые транзакции |
Почему возникают дубликаты при acks=1? Лидер записал сообщение и собирался отправить подтверждение, но упал до его отправки. Продюсер не получил ответ, решил, что отправка провалилась, и повторил запись. Новый лидер из ISR уже содержит первую копию — теперь сообщение в партиции дважды.
Режим «exactly-once» (доставка ровно один раз) имитируется двумя механизмами в связке: идемпотентный продюсер присваивает каждому сообщению уникальный порядковый номер, и брокер отбрасывает повторную запись с тем же номером; транзакционный API позволяет атомарно записать сообщения в несколько топиков. Это снижает пропускную способность, поэтому exactly-once применяют только там, где дублирование действительно критично.
Offset и механизм отслеживания чтения
Offset — монотонно возрастающий числовой идентификатор позиции сообщения в партиции. Он уникален в рамках одной партиции и начинается с нуля. Консьюмер сам отвечает за хранение и обновление offset — именно это позволяет нескольким независимым Consumer Groups читать один топик с разных позиций одновременно.
Commit offset — операция сохранения текущей позиции в специальный служебный топик Kafka (__consumer_offsets). После коммита при перезапуске или ребалансировке консьюмер продолжит чтение с сохранённой позиции, а не с начала партиции.
Главное следствие этой архитектуры: данные в Kafka можно «перемотать» назад. Достаточно сбросить offset консьюмера на более раннюю позицию — и он переобработает историю. Это принципиально отличает Kafka от традиционных очередей сообщений, где прочитанное сообщение безвозвратно удаляется.
Для чего нужна Apache Kafka: пять сценариев применения
Kafka применяется там, где нужно надёжно передавать большие потоки событий между сервисами, сохранять историю и давать возможность воспроизвести её повторно. Вот пять типичных сценариев.
Интеграция микросервисов. Сервисы публикуют события в Kafka вместо прямых вызовов друг к другу. Новый сервис подключается как дополнительный консьюмер — без изменений на стороне продюсера. Слабая связанность снижает риск «эффекта домино» при сбоях и упрощает развитие системы.
Потоковая аналитика в реальном времени. Потоки кликов интернет-магазина, события мобильного приложения или телеметрия устройств поступают в Kafka и тут же обрабатываются: выявляются аномалии, строятся персональные рекомендации, обновляются операционные дашборды без заметной задержки.
Агрегация логов и метрик. Все сервисы пишут логи в единый топик Kafka, а дальше данные маршрутизируются в любое хранилище — Elasticsearch, ClickHouse, S3 — без изменений на стороне источников.
Перехват изменений в базе данных (CDC). Kafka Connect с коннектором Debezium отслеживает журнал транзакций PostgreSQL или MySQL и транслирует каждую вставку, обновление или удаление строки как событие в Kafka. Это основа для синхронизации баз данных, построения проекций и инвалидации кешей.
Очереди с повторным чтением и аудит. Благодаря хранению данных в течение настраиваемого периода можно читать события повторно: история действий пользователей, журнал изменений конфигурации, аудит финансовых операций остаются доступны любому консьюмеру в любой момент.
Если вы работаете с информационными системами и хотите системно освоить архитектуру таких решений — в рамках федерального проекта «Активные меры содействия занятости» доступна программа «Специалист по информационным системам», бесплатная для участников нацпроекта «Кадры».
Экосистема Apache Kafka: Streams, Connect и REST Proxy
Apache Kafka — не только брокер. Вокруг ядра выстроена экосистема инструментов, которые превращают её в полноценную платформу обработки данных. Три главных компонента экосистемы: Kafka Streams для потоковой обработки внутри кластера, Kafka Connect для интеграции с внешними системами и Kafka REST Proxy для HTTP-доступа без нативного клиента.
Kafka Streams — потоковая обработка данных
Kafka Streams — библиотека для обработки потоков данных, работающая непосредственно в рамках кластера Kafka. В отличие от Apache Flink или Apache Spark Streaming, Kafka Streams не требует отдельного кластера обработки: логика пишется как обычное Java- или Scala-приложение, которое запускается рядом с остальными сервисами.
Типичные задачи: фильтрация событий по условию, агрегация по скользящим временным окнам (например, количество заказов за последние 5 минут), объединение потоков из нескольких топиков. Kafka Streams входит в состав экосистемы Apache Kafka и распространяется вместе с основным пакетом.
Kafka Connect и паттерн Change Data Capture
Kafka Connect — фреймворк для создания коннекторов между Kafka и внешними системами без написания кода вручную. Коннекторы бывают двух типов: Source Connector (читает данные из внешней системы и пишет в Kafka) и Sink Connector (читает из Kafka и пишет во внешнюю систему — Elasticsearch, Amazon S3, ClickHouse и другие).
На базе Kafka Connect реализуется паттерн CDC (Change Data Capture — перехват изменений в базе данных). Коннектор Debezium подключается к журналу транзакций PostgreSQL, MySQL или MongoDB и транслирует каждое изменение строки как событие в топик Kafka. Потребители этого потока могут обновлять кеш, реплицировать данные в аналитическое хранилище или строить проекции без опроса основной базы.
Kafka REST Proxy — HTTP-доступ без нативного клиента
Kafka REST Proxy предоставляет HTTP-интерфейс к кластеру Kafka — для языков и платформ, у которых нет нативного Kafka-клиента. Через обычные REST API запросы можно публиковать сообщения в топик, читать из топика и управлять Consumer Groups. Это удобно при интеграции Kafka с устаревшими системами или скриптами на языках с ограниченной поддержкой клиентских библиотек.
Apache Kafka в сравнении с RabbitMQ и NATS: когда выбирать каждый брокер
Выбор брокера сообщений зависит от требований к пропускной способности, задержке, хранению и паттернам потребления. Вот сравнение трёх популярных решений:
| Параметр |
Apache Kafka |
RabbitMQ |
NATS |
|---|---|---|---|
| Модель | Pub-Sub + Queue (Consumer Group) | Queue + гибкий роутинг | Pub-Sub + Queue (JetStream) |
| Хранение после чтения | Да (настраиваемый retention) | Нет | Нет (без JetStream) |
| Пропускная способность | До 1 ГБ/с (кластер 6 узлов) | Средняя | Очень высокая |
| Задержка | От нескольких миллисекунд | Миллисекунды | Субмиллисекунды |
| Exactly-once | Через idempotent producer + транзакции | Ограниченно | Через JetStream |
| Масштабирование | Горизонтальное, без остановки | Вертикальное / кластер | Горизонтальное |
| Лучший сценарий | Большие потоки данных, replay событий | Маршрутизация задач, гибкий роутинг | IoT, ultra-low latency, микросервисы |
Практическое правило выбора: Kafka — когда нужны высокая пропускная способность, хранение истории и возможность повторного чтения; RabbitMQ — когда важна гибкая маршрутизация задач между воркерами; NATS — когда критична минимальная задержка в IoT или межсервисной коммуникации.
Быстрый старт с Apache Kafka: Docker Compose и первый код
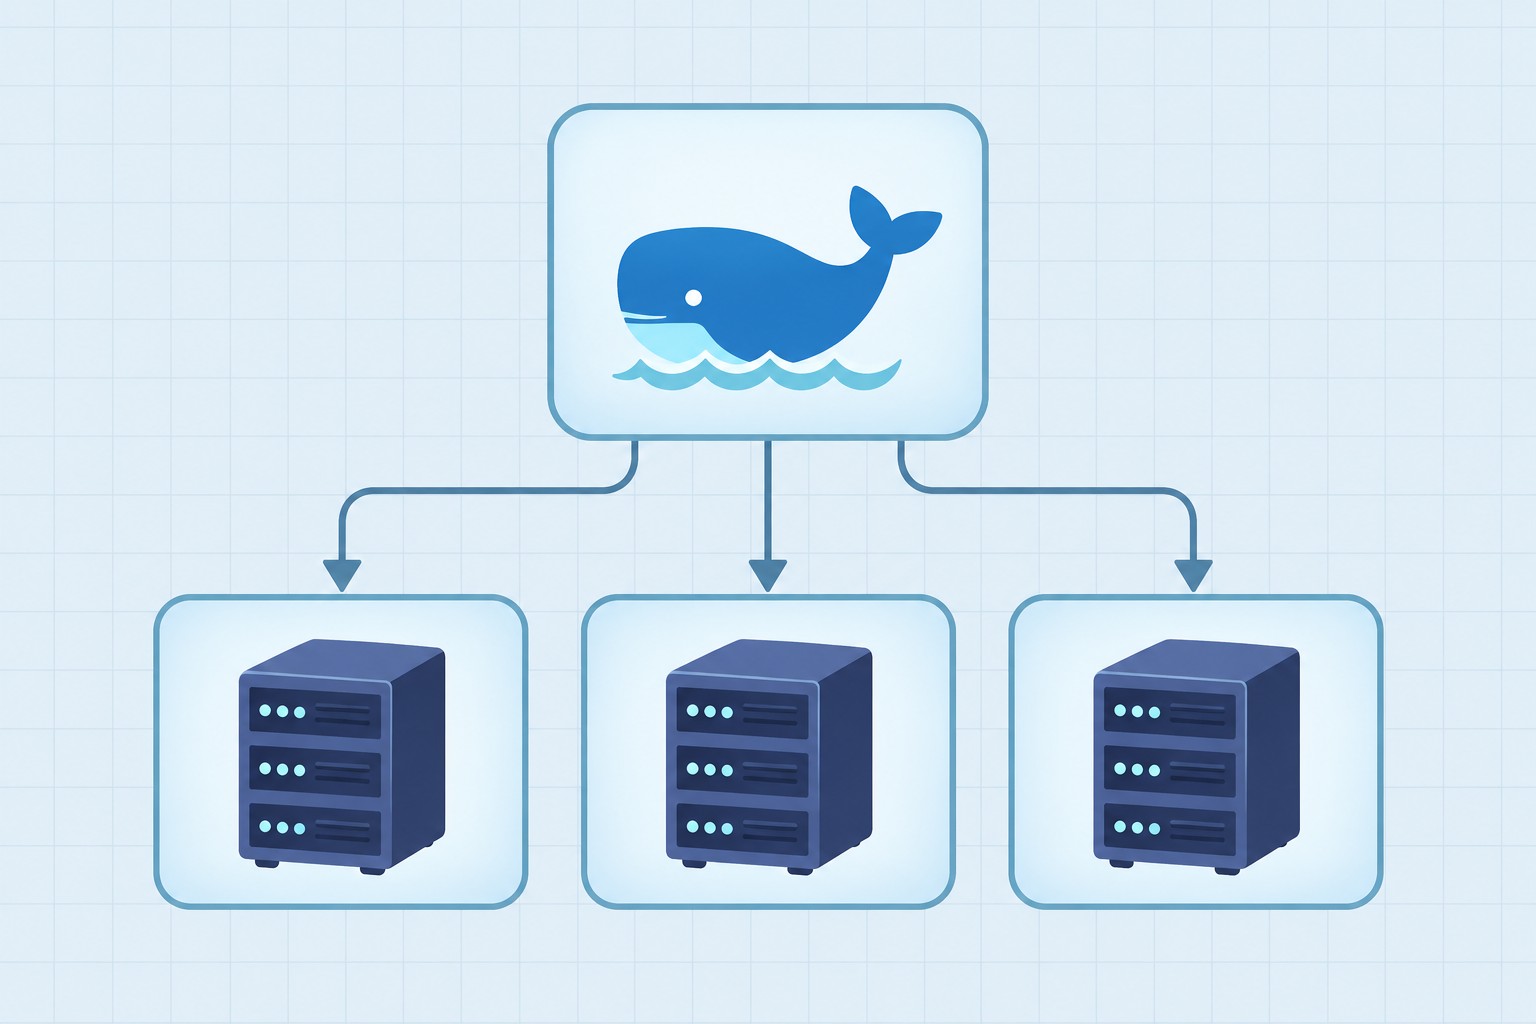
Поднять Kafka локально можно двумя путями: через Docker Compose для разработки и тестирования или через облачные управляемые сервисы — Confluent Cloud, Amazon MSK, Aiven — для продакшена без необходимости настраивать кластер вручную.
Локальный запуск Kafka через Docker Compose
Для локальной разработки достаточно четырёх шагов.
Шаг 1. Создайте файл docker-compose.yml с двумя сервисами: ZooKeeper и Kafka (или один KRaft-брокер в режиме без ZooKeeper).
Хотите сменить профессию или повысить квалификацию?
Федеральный проект «Активные меры содействия занятости» даёт возможность пройти обучение бесплатно за счёт государства
- Программы от ведущих вузов России — от 2 месяцев
- Удостоверение или диплом установленного образца
- Центр карьеры: 7 500+ вакансий, помощь с трудоустройством
Шаг 2. Запустите кластер:
docker-compose up -d
Шаг 3. Создайте топик с тремя партициями:
docker exec kafka kafka-topics.sh \
—bootstrap-server localhost:9092 \
—create —topic orders \
—partitions 3 \
—replication-factor 1
Шаг 4. Проверьте список топиков:
docker exec kafka kafka-topics.sh \
—bootstrap-server localhost:9092 —list
Для отправки тестовых сообщений используйте kafka-console-producer.sh, для чтения — kafka-console-consumer.sh —from-beginning. Флаг —from-beginning читает партицию с нулевого offset — то самое «перемотать назад», которое недостижимо в классических очередях.
Первый продюсер и консьюмер на Python
Рекомендуемая библиотека — confluent-kafka (официальный клиент Confluent, обёртка над librdkafka). Альтернатива — kafka-python, чистая реализация на Python.
Минимальный продюсер:
from confluent_kafka import Producer
p = Producer({‘bootstrap.servers’: ‘localhost:9092’})
p.produce(‘orders’, key=’user-1′, value='{«order_id»: 42}’)
p.flush()
Минимальный консьюмер:
from confluent_kafka import Consumer
c = Consumer({
‘bootstrap.servers’: ‘localhost:9092’,
‘group.id’: ‘order-processor’,
‘auto.offset.reset’: ‘earliest’
})
c.subscribe([‘orders’])
while True:
msg = c.poll(1.0)
if msg and not msg.error():
print(f»Получено: {msg.value().decode()}»)
c.commit()
Ключевые параметры: bootstrap.servers — адрес брокера для начального подключения; group.id — идентификатор Consumer Group; auto.offset.reset — с какой позиции начать, если нет сохранённого offset (earliest = с начала, latest = только новые сообщения).
Инструменты для работы с Kafka: мониторинг, управление, тестирование
Администрирование и отладка Kafka требуют визуальных инструментов — особенно когда нужно быстро понять состояние топиков, Consumer Groups или найти причину задержки обработки.
Kafka UI (Kafdrop) — веб-интерфейс с открытым исходным кодом. Показывает список топиков, число партиций, текущие offset и lag (отставание) каждой Consumer Group. Запускается как отдельный Docker-контейнер рядом с кластером. Незаменим при локальной разработке и интеграционном тестировании.
Kafka Tool (Offset Explorer) — десктопный графический клиент для Windows, macOS и Linux. Позволяет просматривать и редактировать сообщения в топиках, управлять Consumer Groups и партициями. Подходит для разовых административных задач и аудита данных в топике.
Kafka в тестировании. Специалисты по тестированию (QA) используют Kafka для интеграционных тестов микросервисных систем. Схема проста: поднять изолированный кластер в Docker (через Testcontainers или docker-compose), тест публикует событие в топик, сервис-консьюмер обрабатывает его, тест проверяет результат в базе данных или другом топике. Kafka UI помогает визуально убедиться, что сообщение действительно попало в партицию и было прочитано нужной Consumer Group. Такой подход проверяет реальный асинхронный контракт между сервисами — то, что интеграционный тест через REST API не покрывает.
Преимущества и ограничения Apache Kafka
Kafka — мощный инструмент, но не универсальное решение. Понимание её сильных и слабых сторон одинаково важно для правильного выбора.
Преимущества:
- Высокая пропускная способность — до 1 ГБ/с на кластере из шести узлов по результатам теста Aiven.
- Горизонтальное масштабирование без остановки сервиса: добавление брокеров и партиций увеличивает производительность.
- Хранение истории с возможностью повторного чтения: настраиваемый retention period и сброс offset.
- Независимые Consumer Groups позволяют разным сервисам читать один топик без влияния друг на друга.
- Отказоустойчивость через ISR и репликацию: кластер продолжает работу при выходе из строя брокера.
Ограничения:
- Сложность настройки и операционного управления: нужны навыки администрирования, мониторинга и тонкой настройки параметров репликации.
- Зависимость от дискового ввода-вывода: производительность кластера напрямую зависит от скорости хранилища брокеров.
- Избыточность для небольших проектов с низкими нагрузками: три брокера, KRaft или ZooKeeper, настройка репликации — значительный overhead для простых задач.
- Компромисс между задержкой и пропускной способностью: увеличение размера батча повышает throughput, но увеличивает latency.
Часто задаваемые вопросы
Что такое offset в Kafka и зачем его коммитить?
Offset — числовой идентификатор позиции сообщения в партиции. Консьюмер хранит offset и инкрементирует его после обработки каждого сообщения. Commit offset — операция сохранения текущей позиции в Kafka. Без коммита при перезапуске консьюмер начнёт читать с начала партиции и продублирует обработку уже прочитанных сообщений.
Почему нельзя добавить консьюмеров больше, чем партиций в топике?
Consumer Group распределяет партиции между консьюмерами: каждая партиция назначается строго одному консьюмеру внутри группы. Если консьюмеров больше, лишние просто ждут без работы. Максимальный полезный параллелизм Consumer Group равен числу партиций в топике.
Чем KRaft лучше ZooKeeper в Apache Kafka?
ZooKeeper — внешний сервис координации, который нужно разворачивать и обслуживать отдельно от Kafka. KRaft (реализован в рамках KIP-500) — встроенный модуль консенсуса, заменяющий ZooKeeper начиная с Kafka 3.3.1. Убирает внешнюю зависимость, упрощает развёртывание и ускоряет управление метаданными кластера.
Как в Kafka достигается exactly-once доставка?
Нативной гарантии exactly-once нет — она имитируется двумя механизмами. Идемпотентный продюсер присваивает каждому сообщению уникальный порядковый номер, и брокер автоматически отбрасывает повторные записи с тем же номером. Транзакционный API позволяет атомарно записать сообщения в несколько топиков. Вместе они исключают дубликаты, но снижают производительность — применять только там, где дублирование критично.
Какой минимальный ISR рекомендуется при трёх брокерах?
Оптимально min.insync.replicas = 2. Значение 3 блокирует все записи, как только один из трёх брокеров становится недоступен — даже если два оставшихся работают нормально. Значение 2 обеспечивает баланс надёжности и доступности.
В чём разница между Kafka Streams и Kafka Connect?
Kafka Streams — библиотека для потоковой обработки данных внутри кластера: фильтрация, агрегация, объединение потоков. Kafka Connect — фреймворк коннекторов к внешним системам: базам данных, объектным хранилищам, поисковым движкам. Connect отвечает за ввод и вывод данных, Streams — за их трансформацию внутри платформы.
Как Kafka используется при тестировании микросервисов?
В интеграционных тестах Kafka запускается в изолированном Docker-контейнере — через Testcontainers или docker-compose. Тест публикует событие в топик → сервис-консьюмер обрабатывает его → тест проверяет результат в базе данных или другом топике. Kafka UI позволяет визуально верифицировать состояние топика и Consumer Group во время отладки.
Как Kafka связана с событийно-ориентированной архитектурой?
Событийно-ориентированная архитектура (Event-Driven Architecture, EDA) — паттерн взаимодействия сервисов через события вместо прямых вызовов. Kafka служит центральным брокером EDA: продюсеры публикуют события, консьюмеры подписываются на них независимо. Новый консьюмер подключается к существующему топику без каких-либо изменений на стороне продюсера — это и есть слабая связанность.
Какие книги помогут изучить Apache Kafka?
«Kafka: The Definitive Guide» (O’Reilly, авторы Narkhede, Shapira, Palino) охватывает архитектуру и продакшен-эксплуатацию. «Kafka Streams in Action» (Bejeck) посвящена потоковой обработке. Официальная документация Confluent актуальна для KRaft-кластеров и содержит практические руководства по конфигурации.
Стоит ли использовать Kafka для небольших проектов?
Как правило, нет. Kafka требует минимум трёх брокеров, навыков управления кластером и значительных ресурсов. Для небольших объёмов проще использовать RabbitMQ или NATS — они легче в развёртывании и обслуживании. Kafka оправдана при высоких нагрузках, необходимости хранить историю событий с возможностью повторного чтения или построении масштабируемой событийно-ориентированной архитектуры.
Подайте заявку —
забронируйте место в группе
45 000 мест на 2026 год. Бесплатное обучение по федеральному проекту «Активные меры содействия занятости»
- Онлайн
- От 2 месяцев
- Бесплатно
- Диплом