Что такое инцидент-менеджмент: управление IT-сбоями от обнаружения до устранения
Управление инцидентами — структурированный процесс выявления, регистрации, классификации и устранения незапланированных сбоев в IT-системах, закреплённый стандартом ITIL 4. Представьте пожарную команду: без регламента каждый тушит своё, и здание сгорает. С регламентом — чёткое распределение ролей, минимальный ущерб. Система инцидент-менеджмента работает по тому же принципу: ответить быстро, восстановить сервис, извлечь урок. Процесс охватывает восемь этапов — от первого алерта до постинцидентного анализа.
Что считается инцидентом в IT-системе
По определению ITIL — незапланированное отклонение от нормальной работы IT-сервиса, затрагивающее пользователей или бизнес-процессы. На практике событие считается инцидентом, если одновременно выполняются три условия: массовое влияние на пользователей, блокировка ключевого функционала и отсутствие обходного решения (workaround). Причины бывают четырёх типов: ошибка в коде, сбой сети, кибератака, человеческий фактор.
Учитесь бесплатно за счёт государства
Экономия до 100 000 ₽ на любой программе
| Это инцидент |
Не инцидент |
|---|---|
| Авторизация недоступна для >30% пользователей | Один пользователь не может войти |
| Платёжный шлюз возвращает ошибку всем | Медленная загрузка баннера на главной |
| API недоступен более 10 минут | Косметический баг в мобильном приложении |
Какие события НЕ являются инцидентами
Единичная жалоба пользователя — ещё не инцидент: нужна статистика по группе. Визуальный баг в баннере, лёгкая задержка push-уведомления, запрос на обслуживание (Service Request) — это отдельные категории обращений в службу поддержки (Service Desk), а не инциденты. Главное правило: при сомнении считайте событие инцидентом и понижайте статус позже. Лучше среагировать раньше, чем пропустить реальный P1.
Инцидент-менеджмент — что это такое простыми словами
Инцидент-менеджмент — структурированный процесс выявления, регистрации, классификации и устранения сбоев с чётким регламентом и измеримым результатом. Антипаттерн — «пожарное реагирование»: команда узнаёт о проблеме от разгневанных клиентов, хаотично ищет виноватых и теряет часы на выяснение отношений вместо восстановления сервиса.
Что такое инцидент-менеджмент на практике? Это прежде всего скорость петли обратной связи. Чем короче цепочка «обнаружение → решение → выводы», тем меньше ущерб для бизнеса. Важно понимать границу: работа с инцидентами не занимается поиском глубинных причин — это задача управления проблемами, которое проводит анализ первопричин (Root Cause Analysis, RCA) уже после того, как сервис восстановлен.
Полный цикл управления инцидентами: от сигнала до выводов
Процесс управления инцидентами строится как конвейер из восьми шагов. Разрыв на любом этапе — потерянное время восстановления.
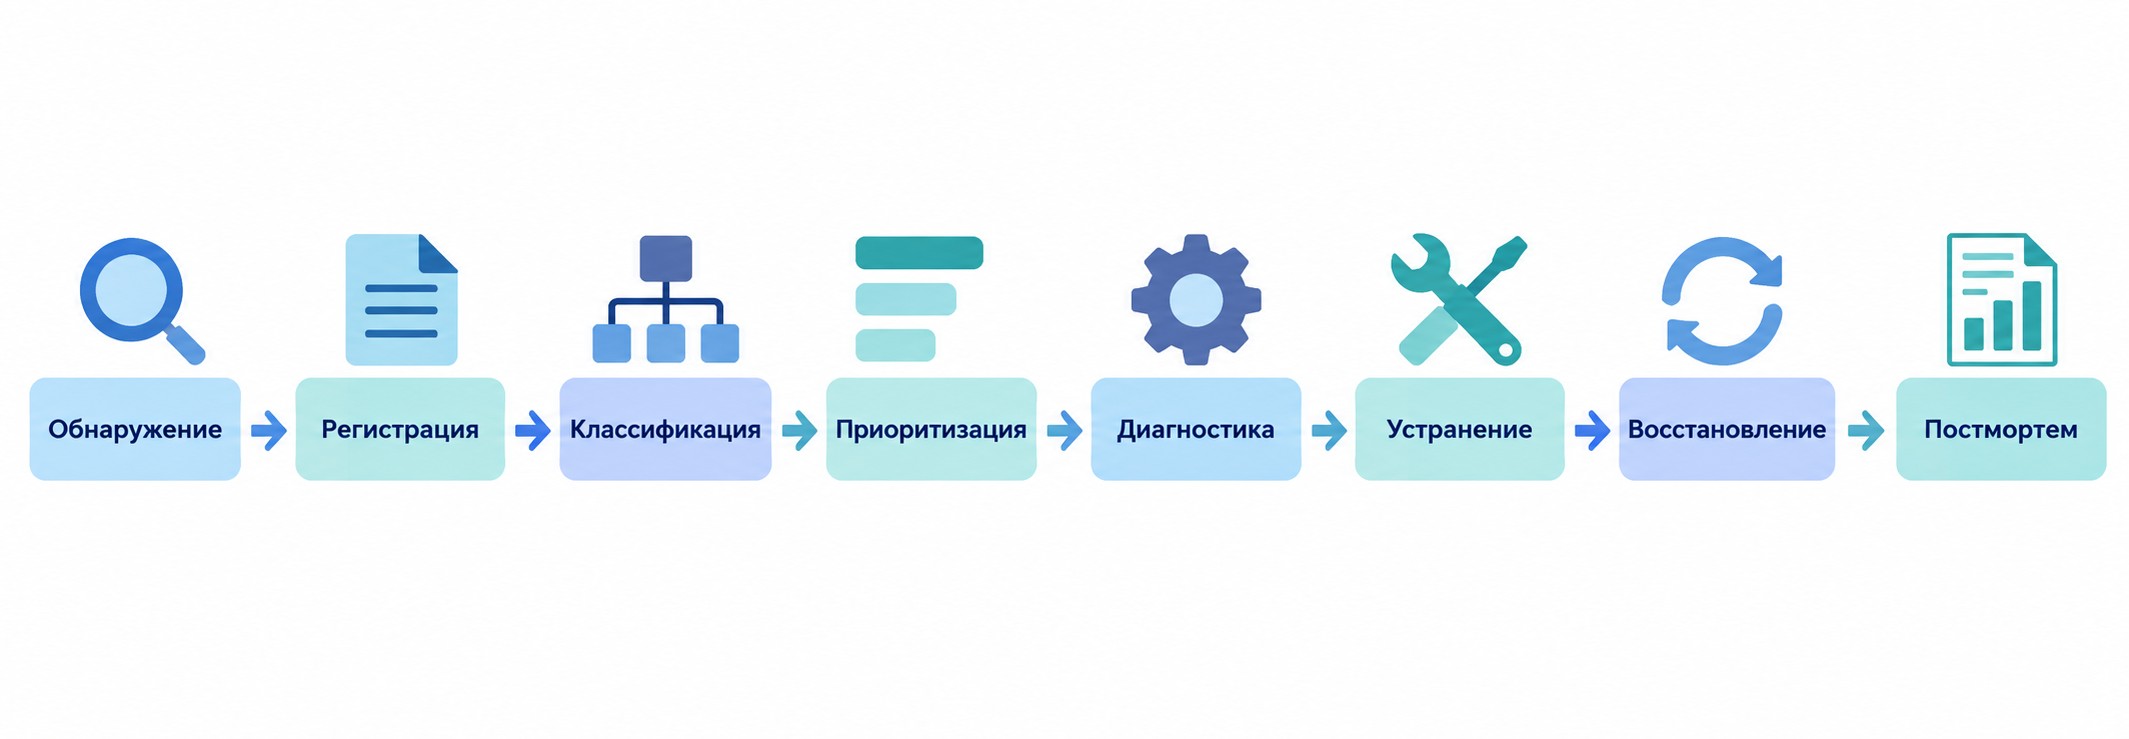
- Обнаружение — алерт от системы мониторинга или сигнал от пользователей.
- Регистрация — тикет с временны́м штампом.
- Классификация — тип и категория сбоя.
- Приоритизация — уровень P1/P2/P3.
- Диагностика — масштаб и локализация.
- Устранение — быстрое исправление или откат.
- Верификация — проблема не воспроизводится, метрики в норме.
- Постмортем — разбор причин и задачи на улучшение.
Ключевой показатель первого этапа — среднее время обнаружения (MTTD, Mean Time To Detect). Чем раньше система фиксирует аномалию, тем меньше пользователей затронуто.
Классификация и расстановка приоритетов
Четыре основных метода: шкала P1–P5 (простая, но субъективная), SEV1–SEV4 (учитывает бизнес-импакт, требует зрелости команды), Impact×Urgency (стандарт ITIL, но абстрактный), Rich×Criticality (охват × критичность функционала — наиболее конкретный, рекомендуется).
| C1 (авторизация, оплата) |
C2 (важная функция с workaround) |
C3 (второстепенная) |
|
|---|---|---|---|
| R1 (>30% пользователей) | P1 | P1 | P2 |
| R2 (10–30%) | P1 | P2 | P3 |
| R3 (<10%) | P2 | P3 | P3 |
| Приоритет |
Время реакции |
Время решения |
|---|---|---|
| P1 | 15 минут | 4 часа |
| P2 | 1 час | 24 часа |
| P3 | Рабочий день | 72 часа |
Эскалация: что делать, если дежурный не отвечает
Цепочка: дежурный разработчик (Dev on-call) → дежурный тестировщик (QA on-call) → тимлид → менеджер продукта → технический директор. Таймаут — 20 минут без ответа, после чего переходят на следующий уровень. Каналы по порядку: Slack → сообщение в Telegram → звонок в Telegram → звонок на мобильный.
Инициировать эскалацию может любой член команды: лучше среагировать раньше, чем не вовремя. Исключение: при инфраструктурных сбоях (база данных, сервер) обращаются сразу к DevOps-инженерам, минуя стандартную цепочку.
Система инцидент-менеджмента: ключевые компоненты
Три основных компонента эффективной системы: мониторинг с алертингом, тикет-система и база знаний.
Мониторинг. Инструменты Grafana, Datadog, Crashlytics отслеживают состояние систем. Ключевое правило: алерты привязывают к бизнес-метрикам (auth_success_rate <99.5%), а не к техническим показателям вроде cpu_usage.
Тикет-система. Регистрирует каждое обращение, маршрутизирует к нужной команде, хранит историю действий.
Дежурства (on-call). Разработчик устраняет сбой, тестировщик проверяет фикс, тимлид — резерв. Ротация еженедельная. Переработки компенсируются по Трудовому кодексу РФ: ×1.5 в будние дни (первые два часа), ×2 — далее и в выходные.
Хотите глубже разобраться в устройстве IT-систем и процессах управления ими? В рамках федерального проекта «Активные меры содействия занятости» нацпроекта «Кадры» можно освоить востребованные IT-направления онлайн — без отрыва от работы и без вложений. Смотрите каталог доступных программ.
Post-Mortem: как не наступить на те же грабли
Постинцидентный анализ (Post-Mortem) проводится в течение 24–48 часов после закрытия инцидента. Главный принцип — культура без обвинений (blameless): «что в системе позволило ошибке произойти?», а не «кто виноват?».
Конкретный кейс: авторизация через Apple ID сломалась после релиза. Разбор выявил четыре системных фактора — ревьюер не заметил изменение, автотестов на этот сценарий не было, QA не проверил iOS-флоу, мониторинг не отслеживал метрику успешных авторизаций. Итог: добавили алерт на auth_success_rate, расширили чек-лист ревью. Ни выговоров, ни поиска виноватых — только задачи.
Шаблон включает 9 полей: дата, серьёзность, длительность, импакт, хронология, причина, фикс, профилактика, наблюдаемость. Все задачи из постмортема уходят в систему управления задачами (task tracker) с ответственным и конкретным сроком (дедлайном).
Метрики инцидент-менеджмента: как измерить эффективность
Хотите сменить профессию или повысить квалификацию?
Федеральный проект «Активные меры содействия занятости» даёт возможность пройти обучение бесплатно за счёт государства
- Программы от ведущих вузов России — от 2 месяцев
- Удостоверение или диплом установленного образца
- Центр карьеры: 7 500+ вакансий, помощь с трудоустройством
Среднее время обнаружения (MTTD) — цель менее 5 минут. Снижается за счёт автоматических алертов, привязанных к целевым показателям уровня сервиса (SLO, Service Level Objective).
Среднее время восстановления (MTTR, Mean Time To Recover) — цель для P1 менее одного часа. Зависит от точности классификации и скорости эскалации.
| KPI |
Целевое значение |
|---|---|
| Среднее время обнаружения (MTTD) | < 5 минут |
| Среднее время восстановления (MTTR, P1) | < 1 часа |
| Количество инцидентов | Тренд снижения |
| Доля повторных инцидентов | < 10% |
| Выполнение SLA | > 95% |
| Покрытие постмортемами | 100% |
| Выполнение задач из постмортемов | > 80% |
Отдельный управленческий инструмент — бюджет ошибок (Error Budget). Если SLO для авторизации составляет ≥99.9%, допустимый простой — около 43 минут в месяц. Исчерпали бюджет — замораживаем новые функции, приоритет уходит на надёжность.
ITIL и управление инцидентами: стандарт и практика
ITIL 4 (издатель — AXELOS / PeopleCert) — библиотека практик управления IT-услугами (ITSM), отраслевой стандарт в корпоративном сегменте. Управление инцидентами — один из трёх ключевых процессов: рядом стоят управление проблемами и управление уровнем услуг.
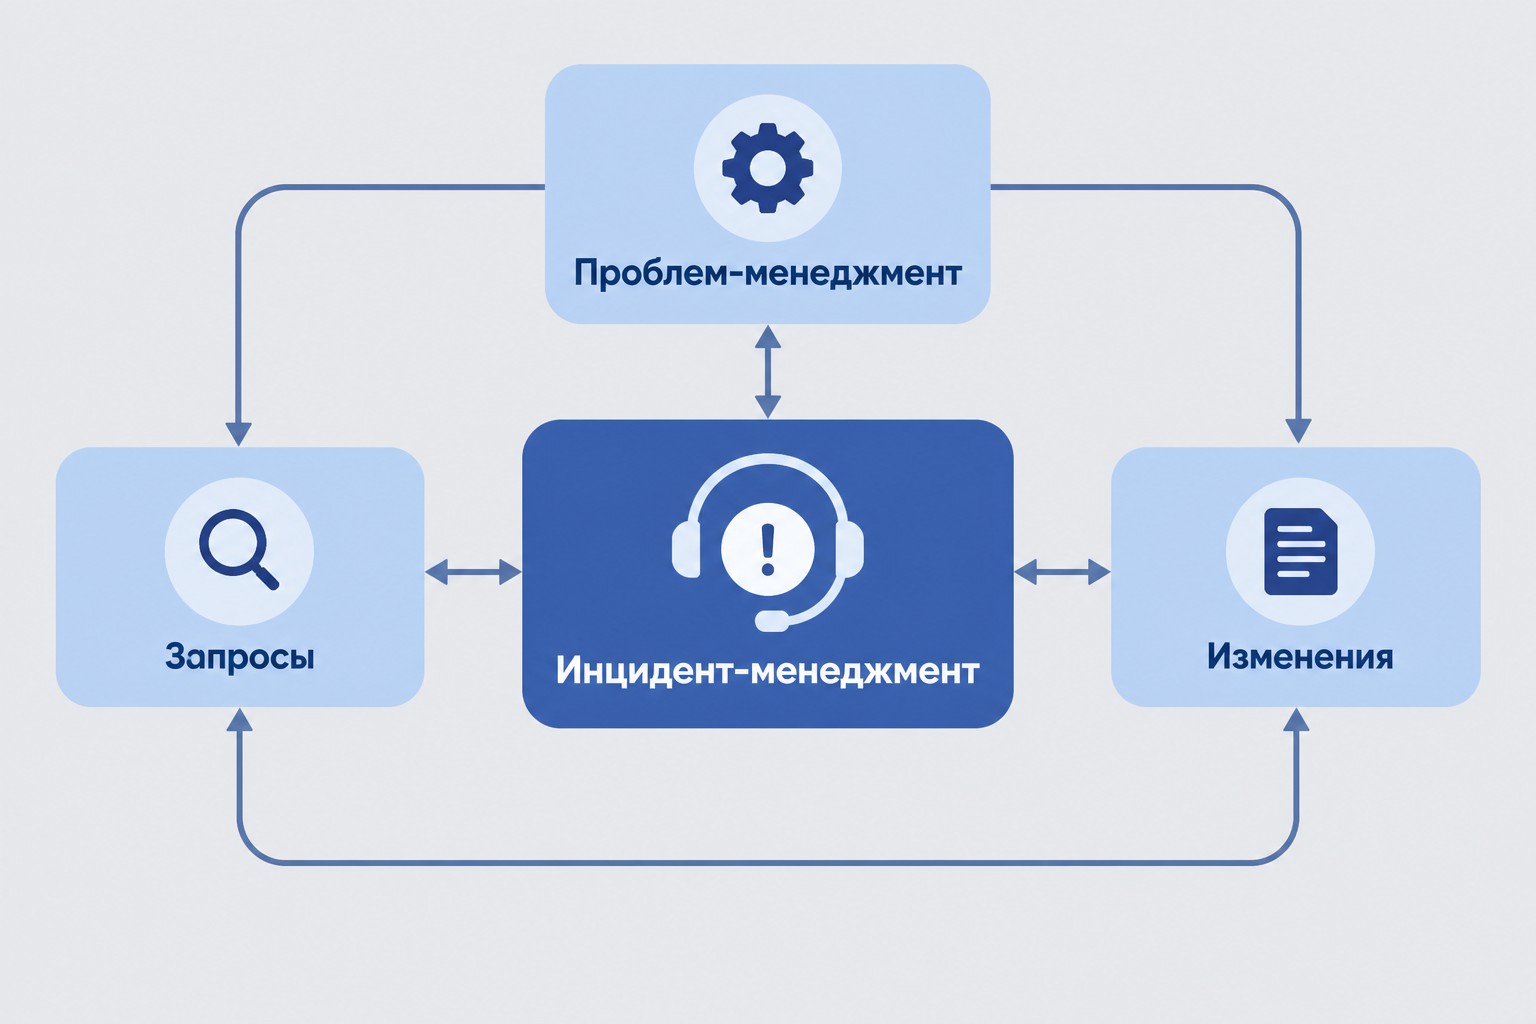
Служба поддержки (Service Desk) — первая линия: регистрирует тикет, классифицирует, маршрутизирует и закрывает обращение. Разграничение чёткое: инцидент-менеджмент отвечает за скорость восстановления сервиса, управление проблемами — устраняет корневые причины через RCA, чтобы инциденты не повторялись.
Часто задаваемые вопросы
Что такое инцидент-менеджмент простыми словами?
Инцидент-менеджмент — структурированный процесс выявления, регистрации и устранения незапланированных IT-сбоев. Цель — вернуть сервис в рабочее состояние как можно быстрее. Без регламента команды тратят часы на поиск виноватых вместо восстановления работы. Стандарт — ITIL 4.
Чем инцидент отличается от проблемы в ITIL?
Инцидент — конкретный сбой, требующий немедленного восстановления сервиса. Проблема — корневая причина, которая порождает повторяющиеся инциденты. Инцидент-менеджмент устраняет последствия быстро; управление проблемами ищет глубинную причину через анализ первопричин (RCA).
Что такое MTTD и MTTR в управлении инцидентами?
Среднее время обнаружения (MTTD) — целевое значение менее 5 минут. Среднее время восстановления (MTTR) — для P1 цель менее одного часа. Оба показателя отражают зрелость процесса: чем ниже, тем меньше ущерб для бизнеса.
Зачем проводить Post-Mortem после каждого инцидента?
Постмортем — разбор в течение 24–48 часов после закрытия инцидента. Цель — понять, что в системе допустило сбой, и сформировать конкретные задачи с дедлайнами. Без постинцидентного анализа одни и те же проблемы повторяются снова.
Как расставить приоритеты инцидентов?
Используйте матрицу Rich×Criticality: охват (R1 >30% / R2 10–30% / R3 <10%) × критичность (C1 — авторизация и оплата / C2 — важная функция с обходным решением / C3 — второстепенная). Результат — P1/P2/P3. При сомнении ставьте P1 — понизить всегда успеете.
Что такое SLO и как он связан с инцидент-менеджментом?
Целевой показатель уровня сервиса (SLO) задаёт допустимые границы, например auth_success_rate ≥99.9%. Бюджет ошибок (Error Budget) — это допустимый объём отклонений, около 43 минут простоя в месяц. При исчерпании бюджета новые функции замораживаются.
Кто дежурит в IT-команде и как это организовано?
Дежурства строятся ротационно: разработчик (Dev on-call) устраняет сбой, тестировщик (QA on-call) проверяет фикс, тимлид — резерв. Смена — еженедельно, доступность 24/7. Переработки компенсируются по ТК РФ: ×1.5 в будние дни, ×2 — в выходные.
Что такое культура blameless и почему она важна?
Культура без обвинений (blameless) — подход к постмортему: вместо поиска виноватых анализируют, какие системные факторы позволили ошибке произойти. Результат — улучшения в процессах, мониторинге и чек-листах. Команда перестаёт скрывать ошибки, система становится надёжнее.
Как инцидент-менеджмент применяется в информационной безопасности?
При кибератаке центр управления безопасностью (SOC-команда) и IT-служба действуют по единому регламенту: быстрое обнаружение, блокировка угрозы, документирование всех действий. Накопленная база знаний ускоряет реагирование на похожие угрозы в будущем.
По каким метрикам оценивать зрелость инцидент-менеджмента?
Семь ключевых KPI: среднее время обнаружения (менее 5 мин), среднее время восстановления (менее 1 ч для P1), количество инцидентов (тренд снижения), доля повторных (менее 10%), выполнение SLA (более 95%), покрытие постмортемами (100%), выполнение задач из постмортемов (более 80%).
Подайте заявку —
забронируйте место в группе
45 000 мест на 2026 год. Бесплатное обучение по федеральному проекту «Активные меры содействия занятости»
- Онлайн
- От 2 месяцев
- Бесплатно
- Диплом