Что такое агрегатные функции в SQL и как их применять
Агрегатные функции SQL — встроенные операции языка запросов, которые принимают набор значений столбца и возвращают одно скалярное число для всей группы строк. Стандарт ANSI SQL включает пять базовых функций: COUNT, SUM, AVG, MIN, MAX. В статье разберём синтаксис каждой, правила применения GROUP BY и HAVING, а также главное отличие агрегации от оконных функций.
Что такое агрегатные функции в SQL
Агрегация в SQL строится на принципе «множество строк → одно значение». Функция принимает данные целого столбца или группы и возвращает один результат: сумму, среднее, счётчик, минимум или максимум. Все функции агрегирования игнорируют NULL, кроме COUNT(*). Важное ограничение: применять их в WHERE нельзя — только в SELECT и HAVING. Стандарт закреплён в ISO/IEC 9075 (ANSI SQL).
Учитесь бесплатно за счёт государства
Экономия до 100 000 ₽ на любой программе
Зачем использовать агрегацию в SQL
Три практических сценария: аналитика данных (выручка, средний чек, количество заказов); фильтрация групп (только регионы с суммой > 1 млн); оптимизация нагрузки — агрегация в СУБД снижает объём данных, передаваемых приложению, вместо построчного подсчёта на стороне сервера.
Пять стандартных функций агрегирования
SQL-стандарт определяет пять базовых функций. Ниже — сравнительный обзор:
| Функция |
Что вычисляет |
Тип аргумента |
Поведение с NULL |
|---|---|---|---|
| COUNT | Количество строк | Любой / * | COUNT(*) включает NULL; COUNT(col) игнорирует |
| SUM | Сумма значений | Числа | Игнорирует NULL |
| AVG | Среднее арифметическое | Числа | Игнорирует NULL; делит на кол-во не-NULL строк |
| MIN | Минимальное значение | Числа, строки, даты | Игнорирует NULL |
| MAX | Максимальное значение | Числа, строки, даты | Игнорирует NULL |
COUNT — три формы подсчёта строк
COUNT работает в трёх формах: COUNT(*) считает все строки таблицы, включая NULL; COUNT(col) — только строки, где столбец не пустой; COUNT(DISTINCT col) — уникальные не-NULL значения. Ключевое: разность COUNT(*) − COUNT(col) равна количеству NULL в этом столбце.
— Уникальные клиенты по месяцам
SELECT DATE_FORMAT(order_date, ‘%Y-%m’) AS month,
COUNT(DISTINCT customer_id) AS unique_customers
FROM orders
GROUP BY month;
SUM и AVG — суммирование и среднее значение
SUM принимает только числовые значения и игнорирует NULL — пропущенные данные не искажают итоговую сумму. AVG делит сумму на количество не-NULL строк; при целочисленных данных результат обрезается — используйте CAST(AVG(col) AS FLOAT), чтобы получить точное среднее значение.
— Выручка за период
SELECT SUM(amount) AS total_revenue
FROM orders WHERE order_date >= ‘2026-01-01’;
— Точный средний чек
SELECT CAST(AVG(amount) AS FLOAT) AS avg_order FROM orders;
MIN и MAX — поиск граничных значений
MIN и MAX работают с числами, строками (лексикографический порядок) и датами; NULL игнорируется. Практический приём: MAX(col) − MIN(col) сразу даёт диапазон значений в группе без дополнительных запросов.
— Самый ранний и последний заказ
SELECT MIN(order_date) AS first_order,
MAX(order_date) AS last_order
FROM orders;
Если хотите освоить SQL и работу с базами данных, в рамках нацпроекта «Кадры» доступна программа «Специалист по аналитике и базам данных в информационных системах» — 72 часа онлайн, бесплатно за счёт государства.
Группировка данных с GROUP BY
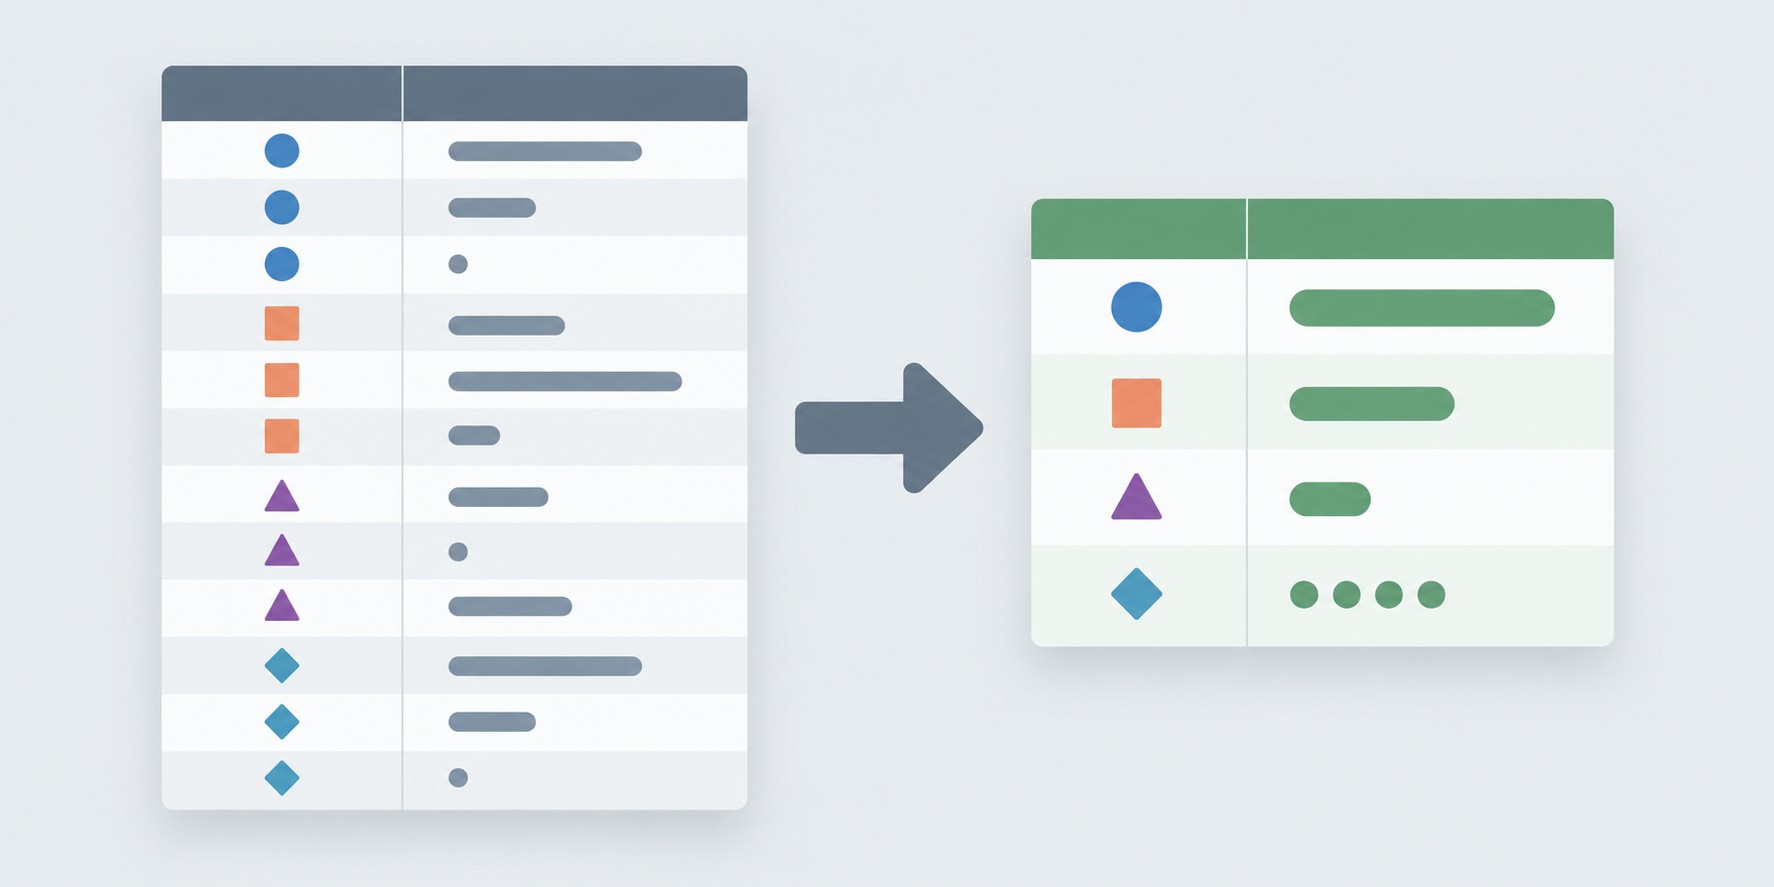
GROUP BY разбивает таблицу на группы строк с одинаковым значением указанного столбца и применяет агрегатную функцию к каждой группе отдельно — результат содержит одну строку на группу. Частая ошибка новичков: в SELECT нельзя указывать столбцы, которых нет в GROUP BY и которые не обёрнуты в агрегатную функцию.
— Суммарная выручка по регионам
SELECT region, SUM(amount) AS total
FROM orders
GROUP BY region;
Фильтрация сгруппированных результатов через HAVING
HAVING — это «WHERE для агрегатов»: он фильтрует группы после GROUP BY, тогда как WHERE фильтрует отдельные строки до агрегации. Правило простое: если в условии стоит агрегатная функция — используйте HAVING.
— Только регионы с выручкой больше 1 000 000
SELECT region, SUM(amount) AS total
FROM orders
GROUP BY region
HAVING SUM(amount) > 1000000;
Почему агрегатные функции нельзя применять в WHERE
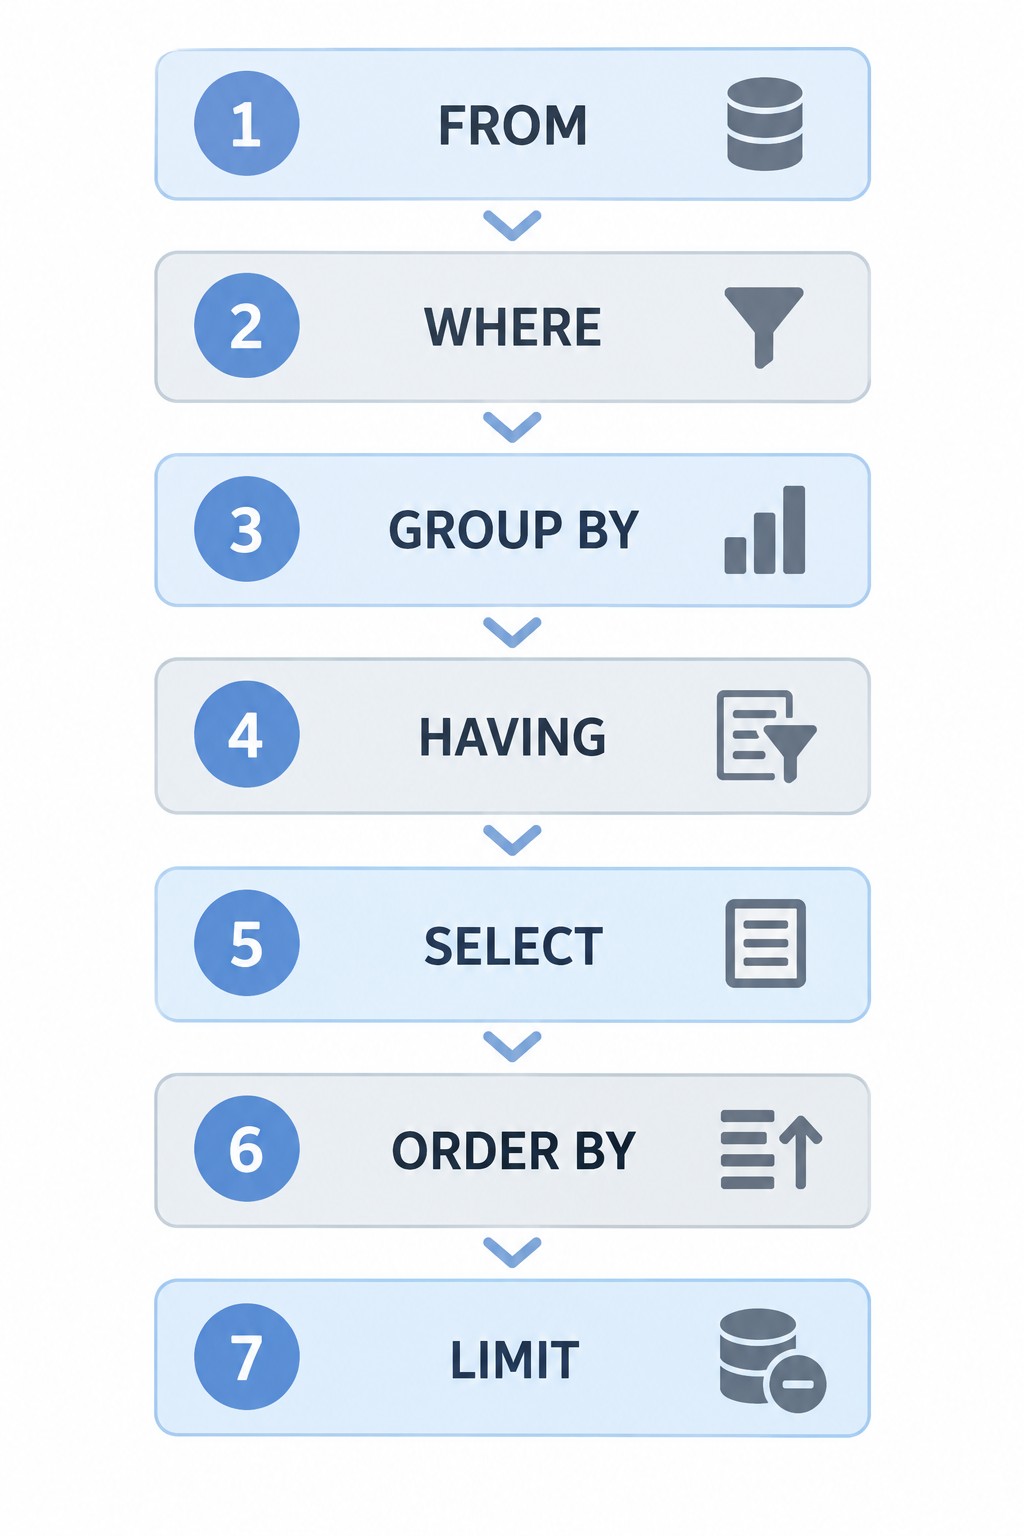
Порядок выполнения SQL-запроса строго фиксирован: FROM → WHERE → GROUP BY → HAVING → SELECT → ORDER BY → LIMIT. WHERE обрабатывается до GROUP BY — агрегированных данных в этот момент ещё не существует, поэтому функции агрегирования здесь запрещены.
— ❌ Ошибка: агрегат в WHERE
SELECT region FROM orders
Хотите сменить профессию или повысить квалификацию?
Федеральный проект «Активные меры содействия занятости» даёт возможность пройти обучение бесплатно за счёт государства
- Программы от ведущих вузов России — от 2 месяцев
- Удостоверение или диплом установленного образца
- Центр карьеры: 7 500+ вакансий, помощь с трудоустройством
WHERE SUM(amount) > 1000000;
— ✅ Правильно: агрегат в HAVING
SELECT region FROM orders
GROUP BY region
HAVING SUM(amount) > 1000000;
HAVING — единственное место для условий по результатам агрегации.
Несколько агрегатных функций в одном запросе
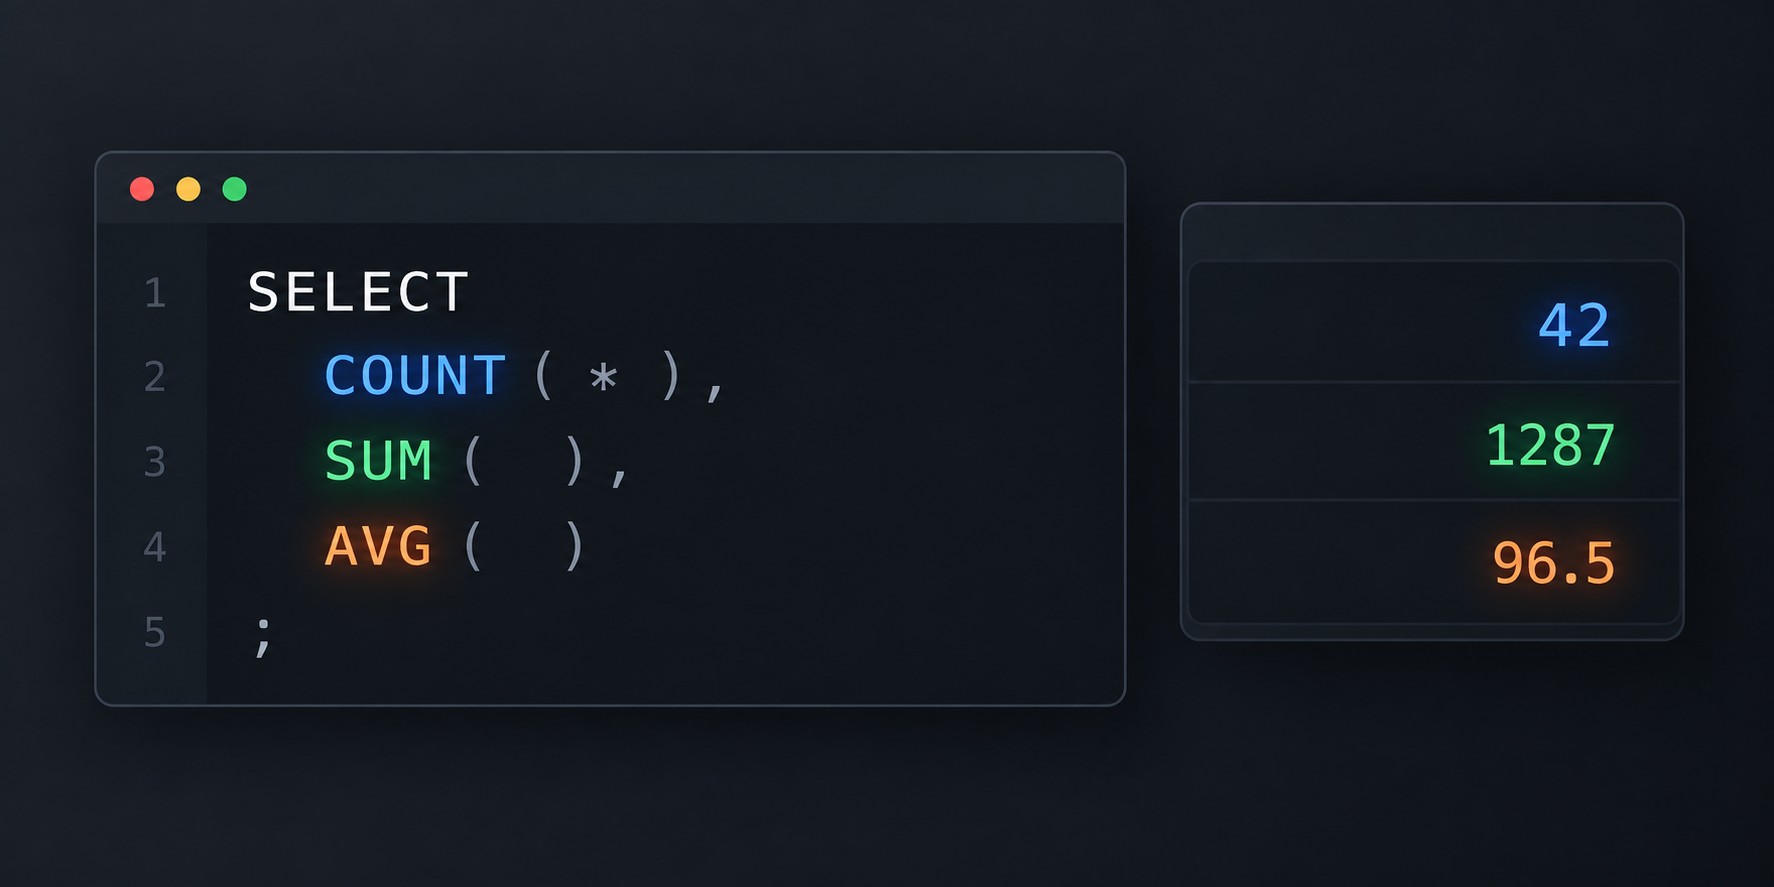
В одном SELECT допустимо использовать любое число агрегатных функций одновременно. Типичный аналитический запрос собирает сразу несколько показателей: уникальные клиенты, сумма продаж, средний чек.
SELECT
DATE_FORMAT(order_date, ‘%Y-%m’) AS month,
COUNT(DISTINCT customer_id) AS unique_clients,
SUM(amount) AS total_revenue,
CAST(AVG(amount) AS FLOAT) AS avg_check
FROM orders
GROUP BY month
ORDER BY month;
DISTINCT внутри агрегата работает только с одним столбцом — синтаксис COUNT(DISTINCT a, b) стандартным SQL не поддерживается.
Оконные функции и их отличие от агрегатных
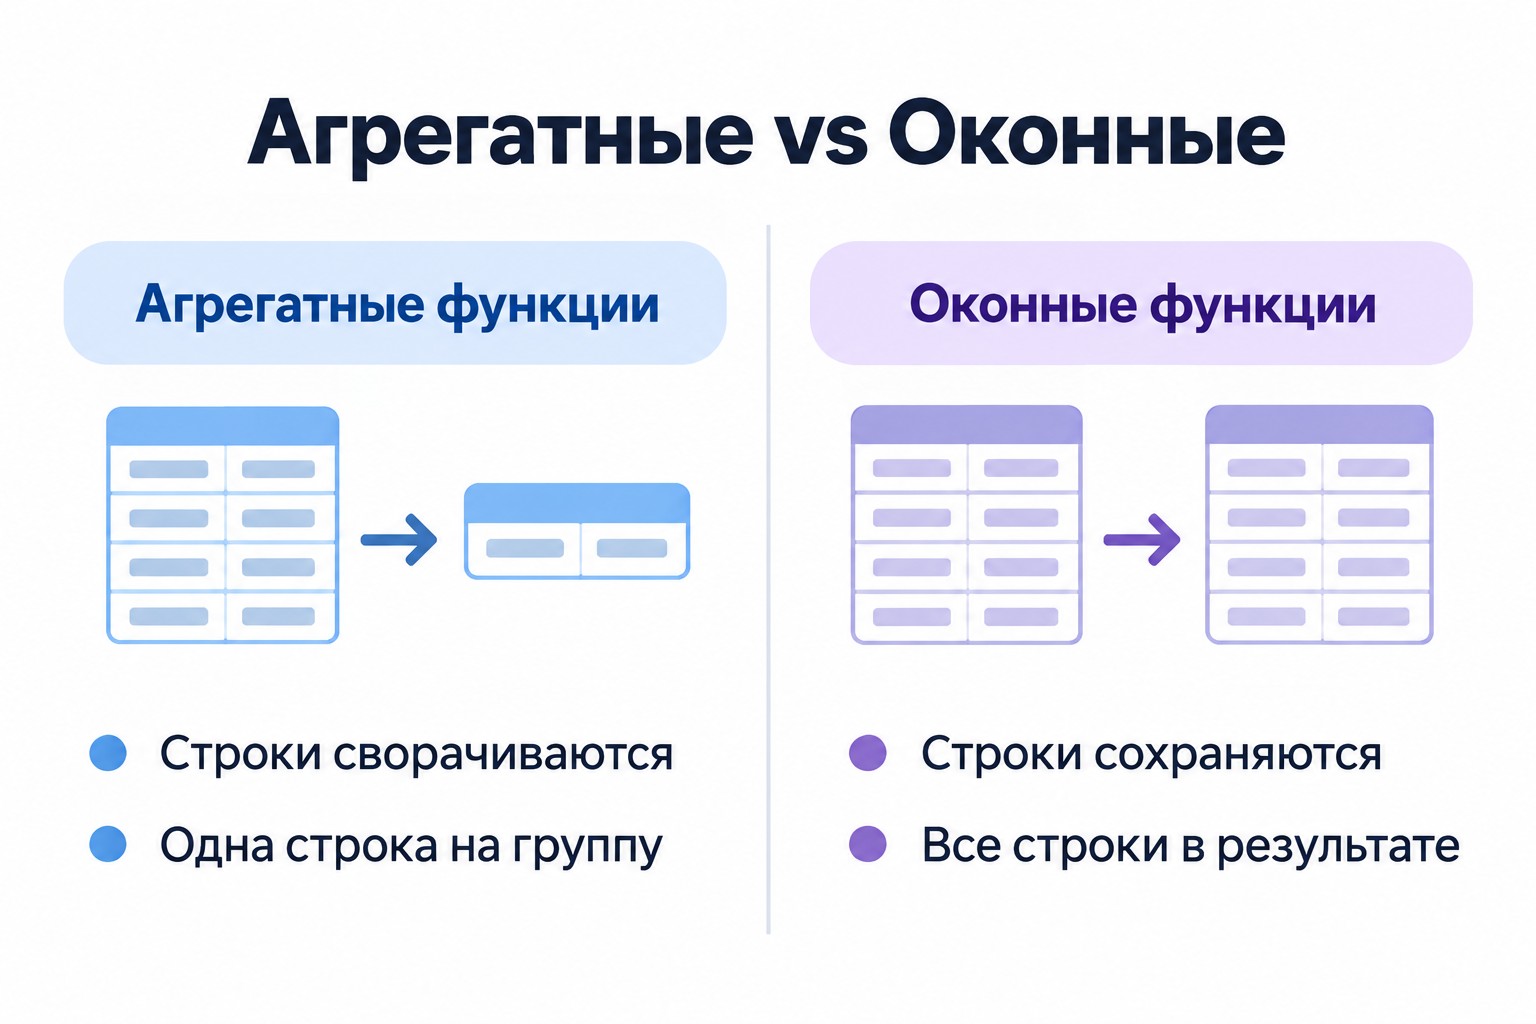
Ключевое различие: агрегатные функции сворачивают результат до одной строки на группу — исходные строки из результата исчезают. Оконные функции с ключевым словом OVER применяют вычисления к каждой строке отдельно, сохраняя весь набор строк.
— Нарастающий итог по регионам
SELECT order_date, amount,
SUM(amount) OVER(PARTITION BY region ORDER BY order_date) AS running_total
FROM orders;
PARTITION BY внутри оконной функции выполняет ту же группировку, что GROUP BY, но без сворачивания строк в одну.
Часто задаваемые вопросы
Чем отличается COUNT(*) от COUNT(столбец)?
COUNT(*) считает все строки таблицы, включая NULL. COUNT(столбец) — только строки, где в этом столбце есть значение. Разность двух результатов показывает количество NULL в столбце.
Можно ли использовать агрегатные функции в WHERE?
Нет: WHERE выполняется до GROUP BY и агрегации — агрегатных данных ещё не существует. Для фильтрации по агрегату используйте HAVING, которое применяется после группировки.
В чём разница между HAVING и WHERE?
WHERE фильтрует отдельные строки до агрегации по значениям столбцов, HAVING — группы после агрегации по результатам функций (COUNT, SUM и т.д.). Правило: агрегат в условии → всегда HAVING.
Как агрегатные функции обрабатывают NULL?
Все функции (SUM, AVG, MIN, MAX, COUNT(col)) игнорируют NULL при вычислениях. Исключение — COUNT(*): считает каждую строку независимо от наличия NULL в любом столбце.
Как получить точное среднее без округления в SQL?
При целочисленных данных AVG выполняет целочисленное деление. Решение: CAST(AVG(col) AS FLOAT) или CAST(AVG(col) AS DECIMAL(10,2)) — возвращает дробный результат.
Чем оконные функции отличаются от агрегатных?
Агрегатные функции сворачивают результат до одной строки на группу. Оконные (с OVER) применяют вычисление к каждой строке по отдельности, сохраняя полное число строк в результате.
Зачем выполнять агрегацию в SQL, а не в приложении?
Агрегация в СУБД обрабатывает данные там, где они хранятся, и передаёт приложению только итог. При больших таблицах это снижает нагрузку на сеть и ускоряет получение результата.
Есть ли особенности агрегатных функций в MS SQL Server?
T-SQL (диалект Microsoft SQL Server) поддерживает те же пять стандартных функций плюс STRING_AGG для объединения строк в одну. Специфика: вместо LIMIT используется TOP N; тип MONEY оптимален при суммировании денежных значений.
Подайте заявку —
забронируйте место в группе
45 000 мест на 2026 год. Бесплатное обучение по федеральному проекту «Активные меры содействия занятости»
- Онлайн
- От 2 месяцев
- Бесплатно
- Диплом