Что такое матрица эскалации и как её построить
Матрица эскалации — инструмент управления инцидентами, фиксирующий, кому и когда передаётся нерешённая проблема. Устраняет коммуникационные сбои, снижает риск потери инцидентов и сокращает время реакции команды. Применяется в IT-командах, бизнес-процессах и контакт-центрах — везде, где важна чёткая цепочка ответственности. Методологическую основу задают стандарты управления инцидентами ITSM и лучшие практики Google SRE. Atlassian реализует матрицу через инструменты Opsgenie и Jira Service Management.
Матрица эскалации — что это такое и зачем нужна
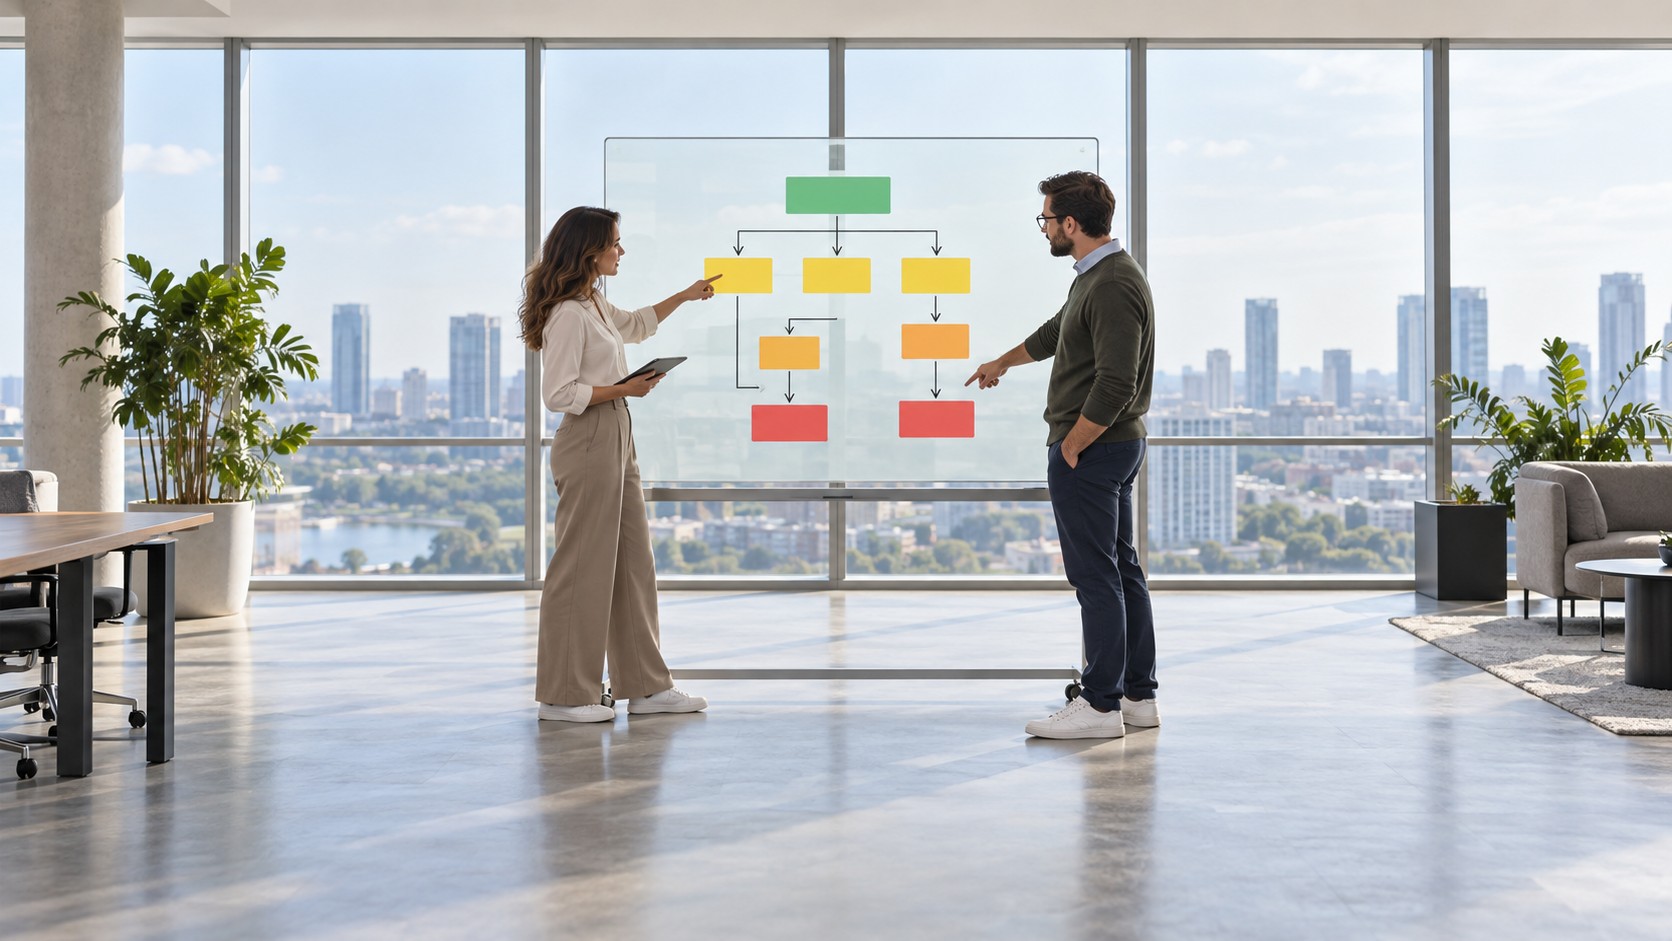
Матрица эскалации — это документ или система, определяющая, когда и кому передаётся нерешённый инцидент. По структуре — двухосевая таблица: ось уровня сложности проблемы и ось уровня её влияния на организацию. На пересечении осей задаётся приоритет и назначается ответственный.
Учитесь бесплатно за счёт государства
Экономия до 100 000 ₽ на любой программе
Без матрицы команды сталкиваются с тремя повторяющимися проблемами: коммуникационные сбои (непонятно, кому передать), неверная расстановка приоритетов (критический инцидент ждёт, пока разбираются с незначительным) и отсутствие закреплённой зоны ответственности. Матрица решает все три — это одновременно инструмент риск-менеджмента и управления инцидентами.
Три основных домена применения: IT-команды — маршрутизация инцидентов от дежурного инженера к специалисту по надёжности сайта (SRE); бизнес-процессы — эскалация рисков между подразделениями; контакт-центры — передача обращений между линиями поддержки.
Структура матрицы эскалации: две ключевые оси
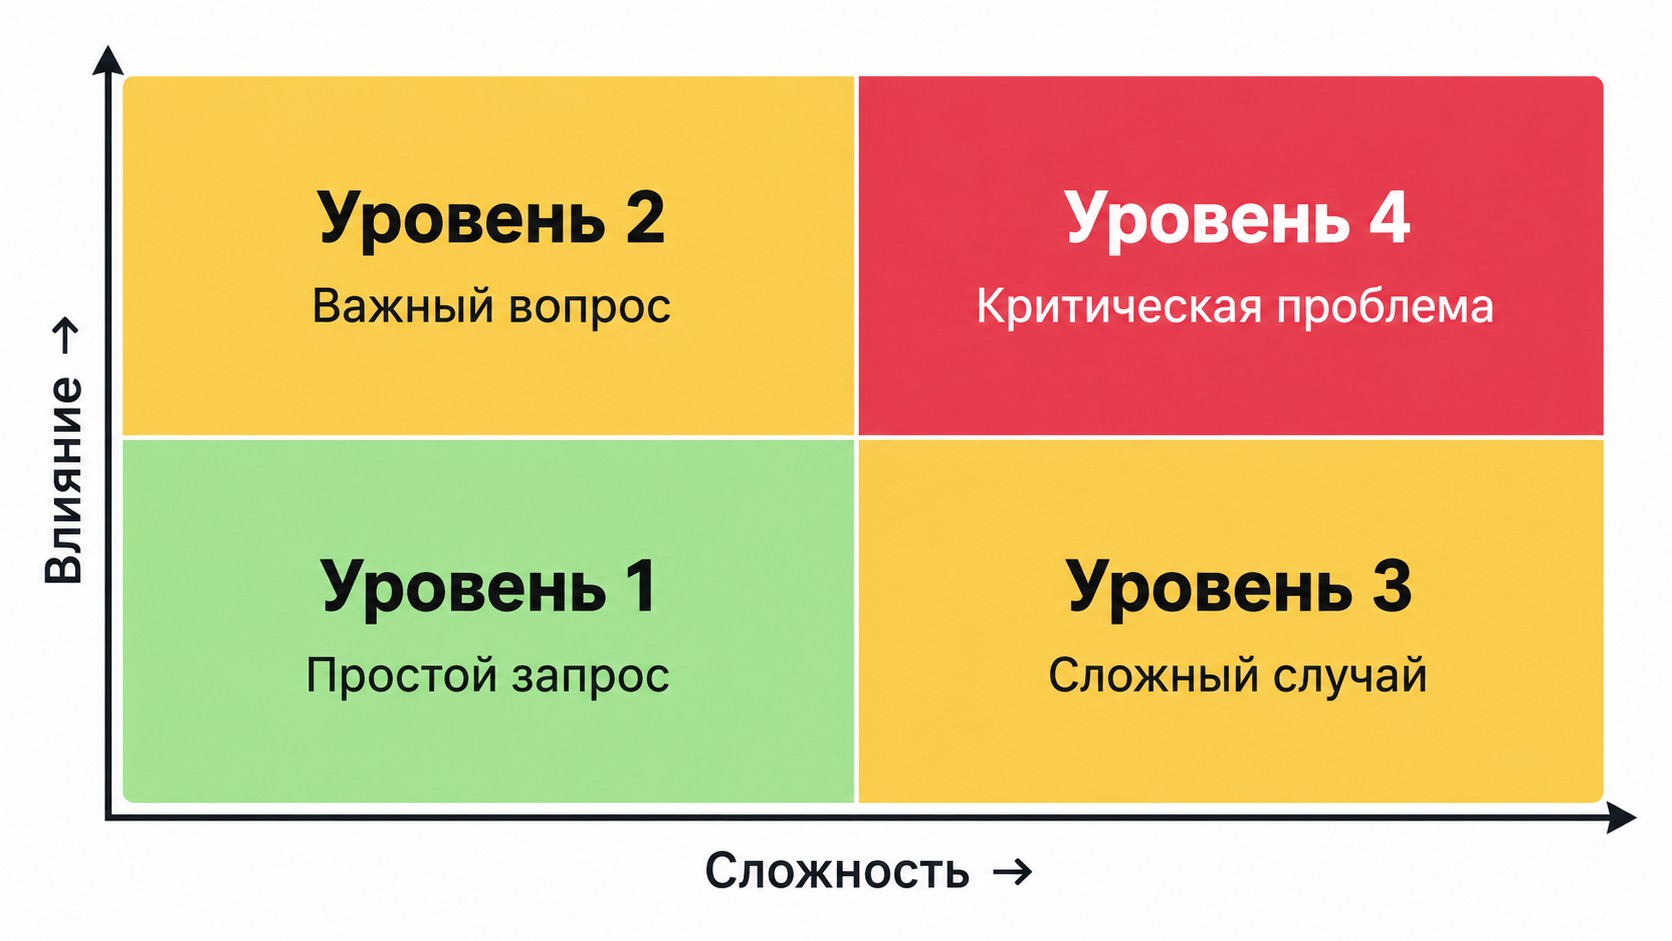
Матрица строится на пересечении двух осей. Их комбинация определяет уровень приоритета инцидента и ответственного за его решение. Пороговые значения каждой оси задаются на этапе проектирования.
Ось уровня сложности
Ось сложности измеряет, какого уровня квалификации требует решение проблемы. На нижнем конце — задачи для линейного сотрудника, на верхнем — инциденты, требующие узкой экспертизы. Пример: junior-разработчик не устранил ошибку — эскалирует проблему senior-инженеру. Это типичная иерархическая эскалация по оси сложности.
Ось уровня влияния
Ось влияния измеряет воздействие инцидента на организацию: масштаб затронутых пользователей, финансовые потери, репутационный урон. Чем выше уровень критичности, тем выше уровень эскалации. Прямая связь с соглашением об уровне сервиса (SLA): превышение порога времени простоя автоматически подключает SRE или менеджера инцидентов — условие задаётся при настройке матрицы.
Виды эскалации в матрице
Правила эскалации задают три маршрута передачи инцидента: по должности, по специализации или автоматически по таймеру. IT-команды чаще всего применяют все три в комбинации.
Освоить управление ИТ-системами и процессами — от организации службы поддержки до сопровождения проектов — можно на программе «Специалист по информационным системам: от организации до сопровождения ИТ-проектов» в рамках национального проекта «Кадры»: бесплатно, с нуля, онлайн. Смотрите каталог программ обучения.
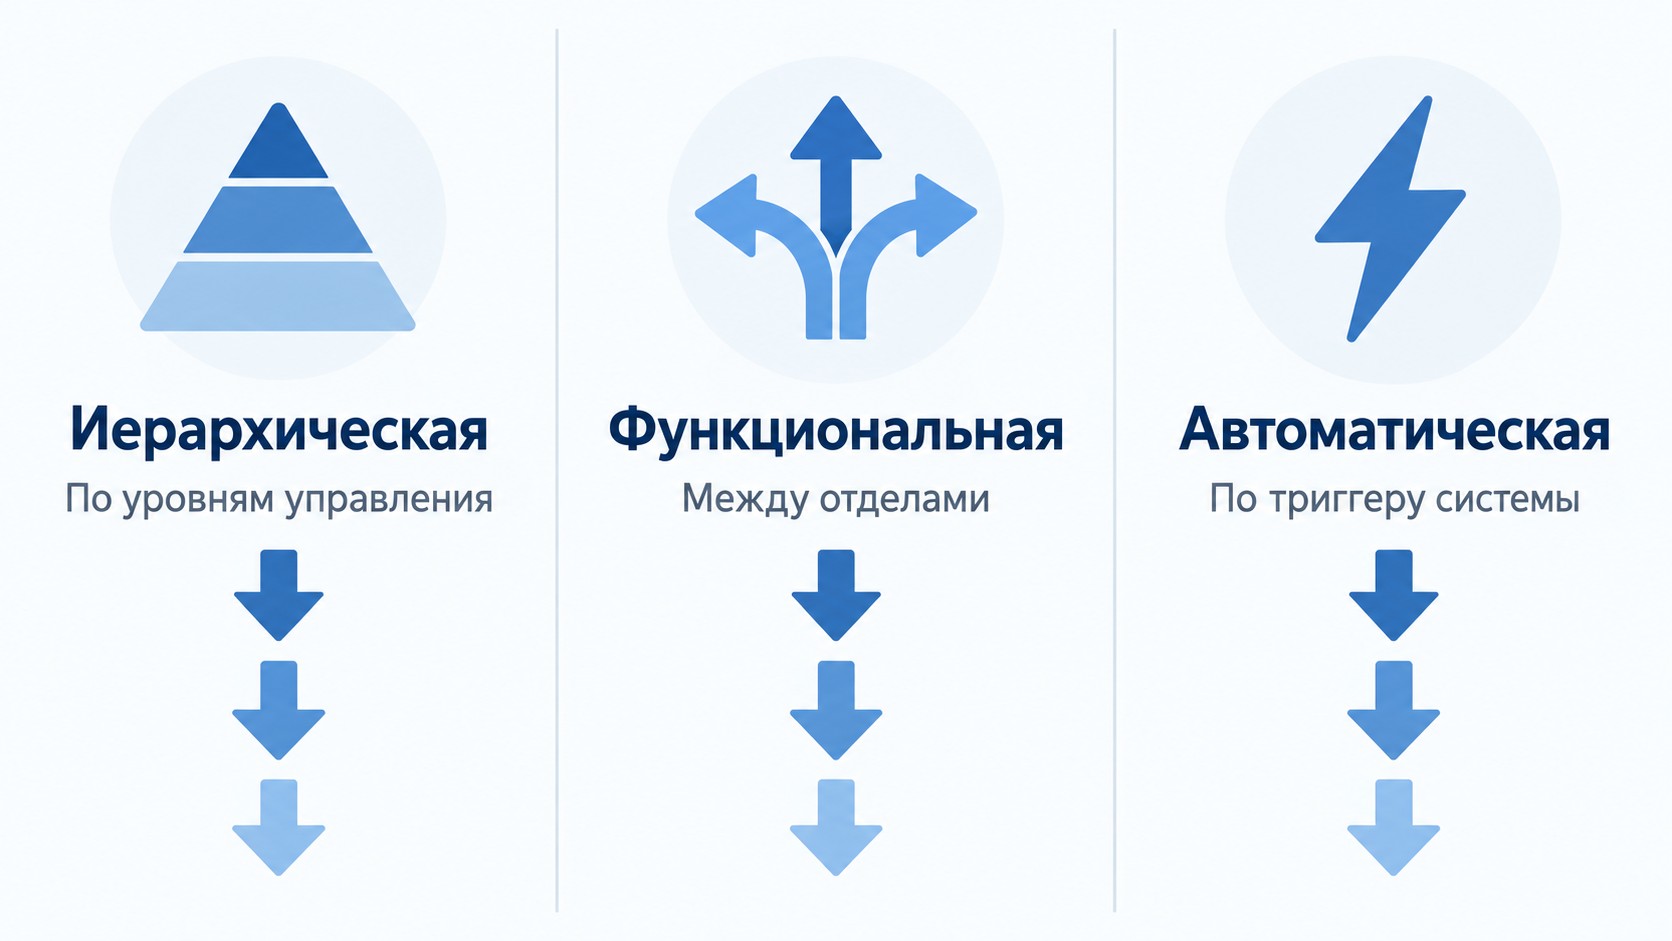
Иерархическая эскалация
Критерий маршрутизации — должность в структуре организации. Первый исполнитель не справился — передаёт задачу сотруднику с более высокими полномочиями. Пример: junior → senior → Team Lead при каждом провале на текущем уровне. Дежурный инженер подключается, когда исчерпаны предыдущие звенья. Время на каждом уровне фиксируется в правилах; эскалировать на руководство допустимо только при превышении установленного SLA.
Функциональная эскалация
Критерий — специализация, а не должность. Инцидент передаётся профильному специалисту, лучше знающему конкретную систему или продукт. Пример: баг в интеграции Product A, обнаруженный командой Product B, эскалируется в команду Product A — независимо от уровней должностей участников. Квалифицированный специалист по нужной технологии важнее иерархии.
Автоматическая эскалация
Триггер — таймер: если дежурный инженер не подтвердил получение оповещения в установленный срок, система эскалирует инцидент без участия человека. Платформы управления инцидентами (ITSM) — Opsgenie и Jira Service Management — поддерживают настройку таких правил из коробки. Это снижает риск пропуска критического события.
Типы матрицы эскалации
Выбор типа матрицы зависит от структуры организации и характера типичных рисков. Одной компании достаточно единой матрицы, другой — нескольких, под разные подразделения.
| Тип |
Применение |
Ответственный |
|---|---|---|
| Функциональная | Распределение рисков по отделам | Руководитель подразделения |
| Процессная | Риски на этапах проекта | Менеджер проекта |
| Географическая | Компании с региональными филиалами | Региональный директор |
| Продуктовая | Проблемы по продуктовым командам | Владелец продукта (Product Owner) |
Функциональная и процессная матрицы
Функциональная матрица распределяет ответственность по отделам: каждый риск закреплён за руководителем подразделения. Подходит для операционных, постоянно действующих процессов. Процессная ориентирована на риски внутри конкретного проекта: ответственным становится менеджер проекта, маршрутизация меняется от этапа к этапу.
Географическая и продуктовая матрицы
Географическая матрица нужна компаниям с филиалами: инцидент в регионе эскалируется к региональному директору, а не в центральный офис. Продуктовая строится вокруг продуктовых команд: эскалацию проекта закрывает владелец продукта. Оба типа актуальны для IT-компаний с матричной организационной структурой.
Как создать матрицу эскалации
Алгоритм создания — восемь шагов: четыре на анализ и классификацию рисков, четыре на настройку и автоматизацию. Работа с эскалациями строится последовательно — от описания рисков до регулярного аудита.
Шаги 1–4: анализ и классификация рисков
Шаг 1. Определить типичные проблемы и потенциальные риски компании: технические сбои, ошибки процессов, нештатные ситуации.
Шаг 2. Оценить влияние каждого риска (ось влияния) — по масштабу затронутых пользователей, финансовым потерям и репутационному урону.
Шаг 3. Оценить сложность устранения (ось сложности) — по необходимой квалификации, ресурсам и времени.
Шаг 4. Распределить проблемы по уровням опасности и зафиксировать в шаблоне.
| Уровень |
Тип проблемы |
Влияние |
Сложность |
Ответственный |
Срок реакции |
|---|---|---|---|---|---|
| 1 — Низкий | Единичный сбой, один пользователь | Низкое | Низкая | Линейный сотрудник / L1 | 4–8 ч |
| 2 — Средний | Ошибка функциональности, группа пользователей | Среднее | Средняя | Профильный специалист / L2 | 1–2 ч |
| 3 — Высокий | Критический инцидент, бизнес-процессы нарушены | Высокое | Высокая | Senior-инженер / SRE | 15–30 мин |
| 4 — Критический | Полная недоступность сервиса | Критическое | Максимальная | Менеджер инцидентов | Немедленно |
Шаги 5–8: назначение ответственных и автоматизация
Шаг 5. Назначить конкретных ответственных для каждого уровня матрицы — конкретные роли, а не отделы целиком.
Хотите сменить профессию или повысить квалификацию?
Федеральный проект «Активные меры содействия занятости» даёт возможность пройти обучение бесплатно за счёт государства
- Программы от ведущих вузов России — от 2 месяцев
- Удостоверение или диплом установленного образца
- Центр карьеры: 7 500+ вакансий, помощь с трудоустройством
Шаг 6. Установить пороговые значения и SLA: сколько времени отведено на решение до автоматической эскалации.
Шаг 7. Настроить автоматические уведомления в ITSM-платформе — Opsgenie или Jira Service Management. Правила должны срабатывать без ручного вмешательства.
Шаг 8. Регулярно проводить аудит графика дежурств — пробелы в покрытии ведут к пропускам инцидентов. Принцип Google SRE: правила эскалации — это рекомендации, не жёсткие регламенты. Их адаптируют под реальные ситуации.
Примеры матрицы эскалации
Шаблон из Таблицы 2 — универсальная основа. В конкретных контекстах цепочки ответственности выглядят иначе. Два наиболее распространённых сценария: IT-команда и контакт-центр.
Матрица эскалации для IT-команды
Критический инцидент (Severity 1, полная недоступность сервиса): дежурный инженер получает оповещение → не устраняет за 15 минут → передаёт SRE → SRE не справляется → подключается менеджер инцидентов → при масштабе на всю организацию — топ-менеджмент.
Severity 3 (незначительный сбой, один пользователь) junior-разработчик закрывает самостоятельно. Уровень серьёзности определяет глубину цепочки и скорость реакции в рамках управления инцидентами.
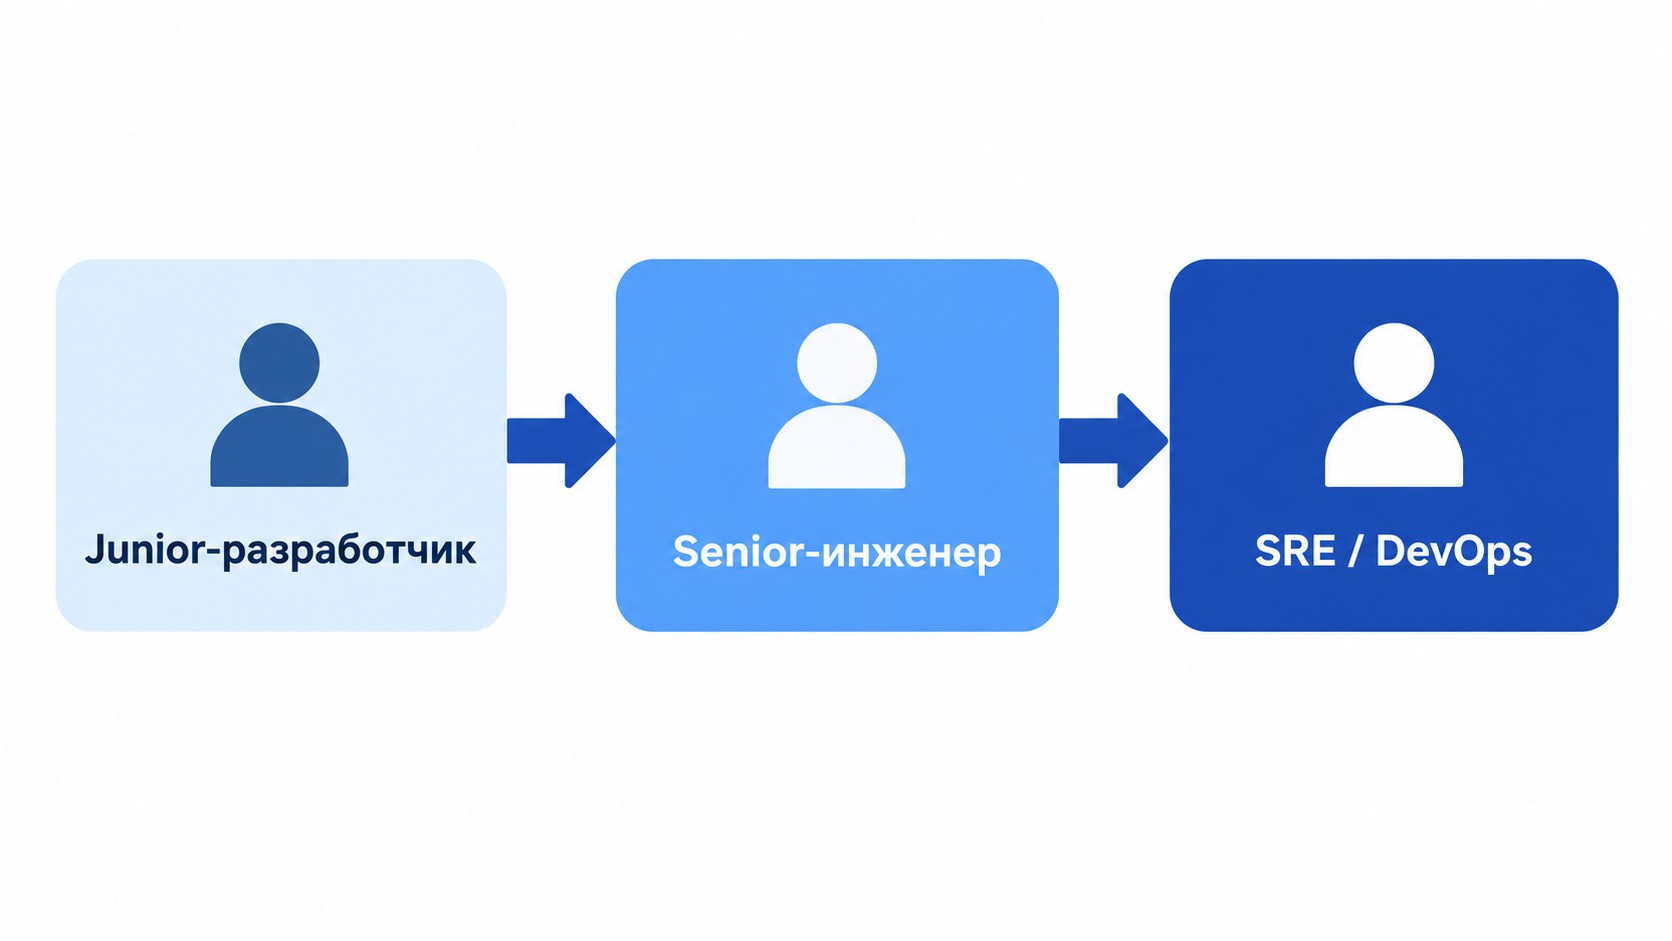
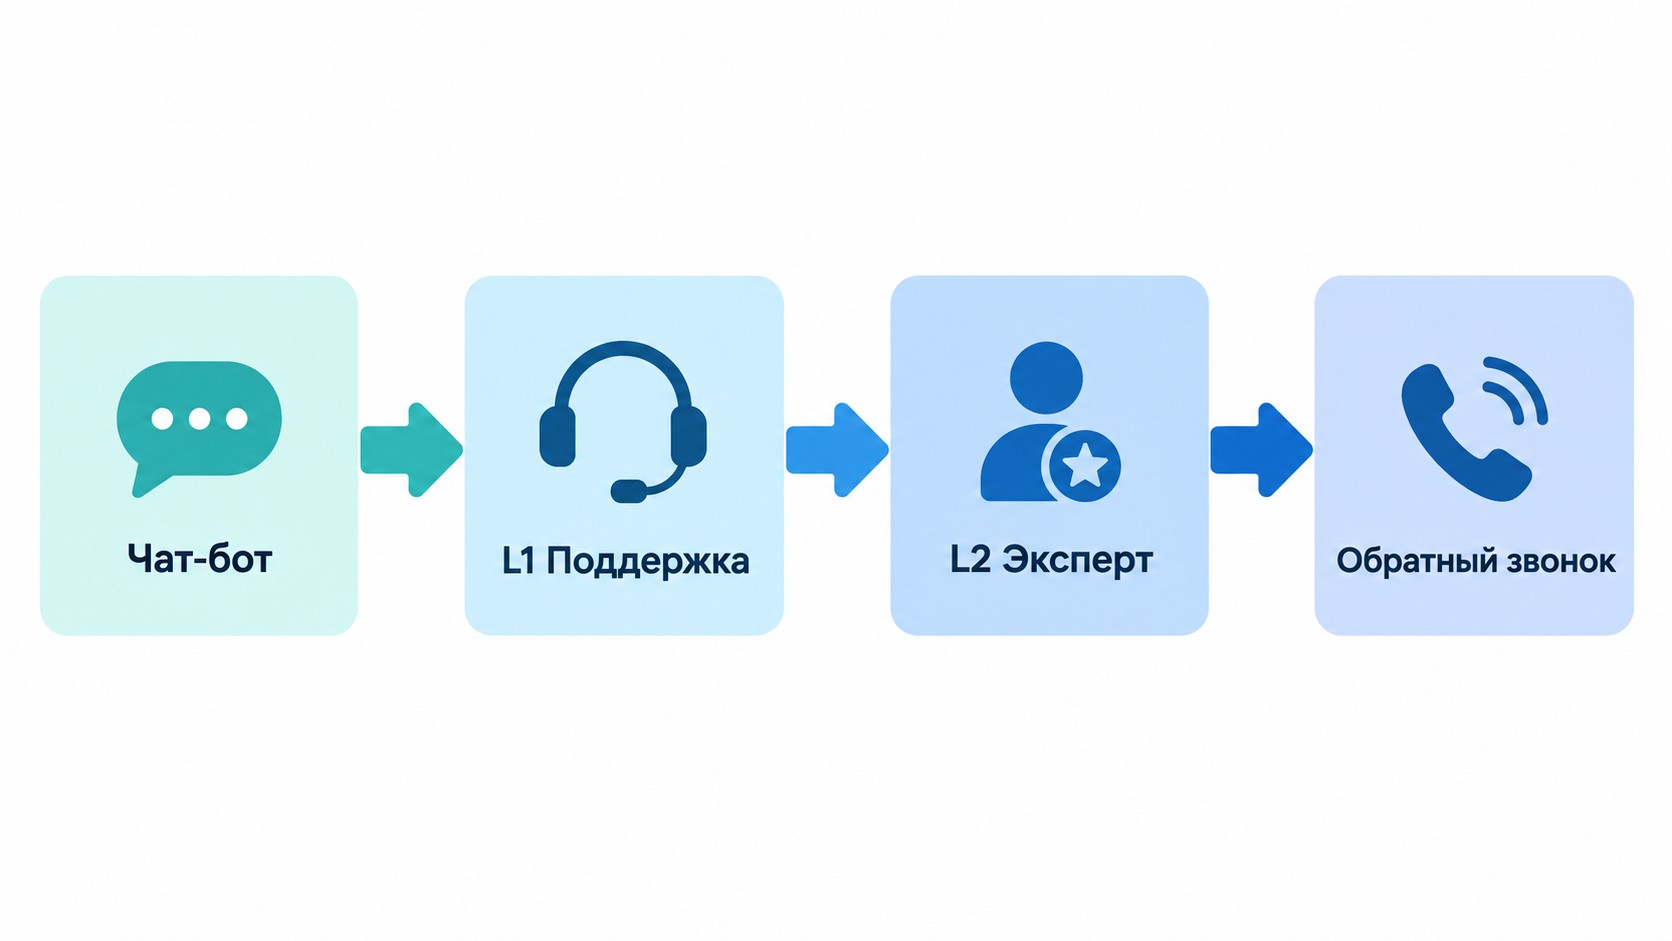
Матрица эскалации для контакт-центра
Обращение принимает чат-бот — первичная маршрутизация по категории запроса. Не решил → оператор первой линии (L1). L1 не справился или запрос требует экспертизы → эскалация обращения к квалифицированному специалисту (L2). Если клиент недоступен в момент перевода — назначается обратный звонок.
Тёплый перевод: L1 остаётся на линии и представляет клиента L2. Холодный — переадресация в очередь без сопровождения. Ключевая метрика эффективности: показатель решения при первом обращении (First Contact Resolution, FCR) — чем выше, тем лучше выстроена работа с эскалациями.
Как оценить эффективность матрицы эскалации
Два ключевых показателя: среднее время восстановления после инцидента (Mean Time To Repair, MTTR) и время простоя. Чёткая цепочка ответственности убирает задержки на поиск нужного специалиста — MTTR снижается.
FCR отражает качество маршрутизации на первой линии: если L1 или чат-бот решает проблему без передачи, это экономит ресурсы и повышает удовлетворённость клиента.
Для визуальной оценки матрицы используют цветовую схему: зелёный — показатели в норме, жёлтый — принимаются меры, есть отклонения, красный — метрики вышли за пределы SLA и требуются улучшения.
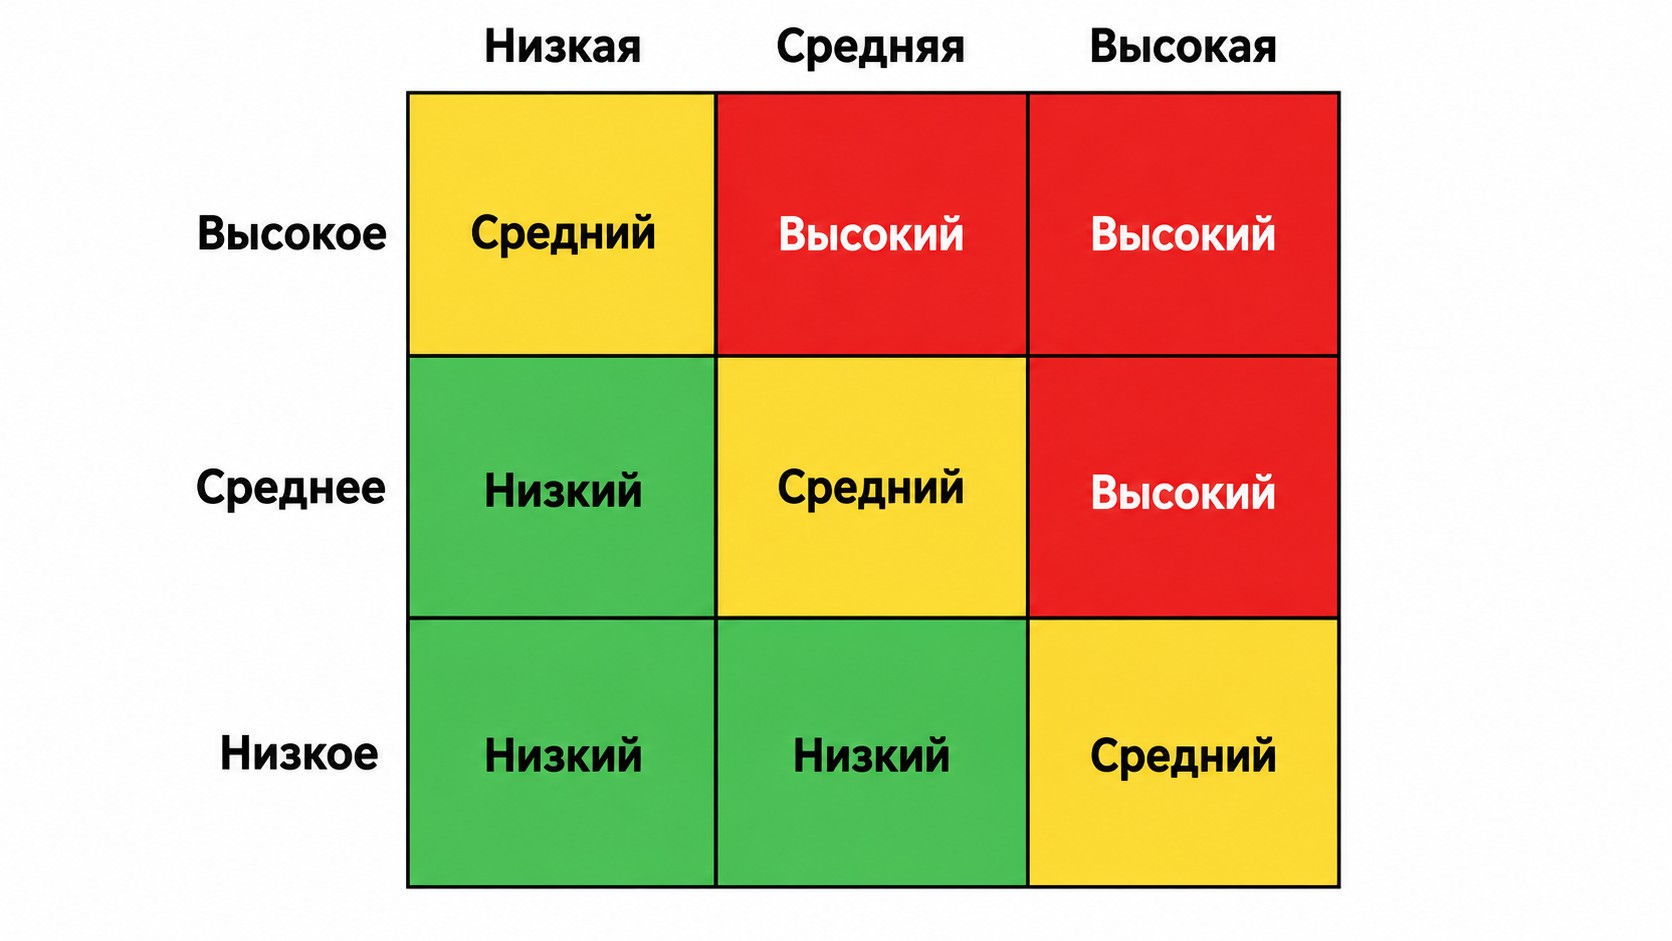
Три скрытых риска неправильного применения: выгорание дежурных инженеров при избыточной нагрузке, усталость от оповещений (реальные инциденты теряются в потоке алертов) и неверная классификация уровней — когда Severity 1 обрабатывается как Severity 3 и теряет критически важное время. Регулярный аудит матрицы — единственный инструмент их устранения.
Часто задаваемые вопросы
Что такое матрица эскалации простыми словами?
Инструмент управления, фиксирующий три вещи: какие проблемы существуют, кто за них отвечает и в каком порядке подключаются специалисты, если текущий исполнитель не справляется. По форме — таблица, где на пересечении осей сложности и влияния задаётся ответственный и срок реакции.
Чем матрица эскалации отличается от правил эскалации?
Матрица — визуальный документ: таблица с уровнями, ответственными и сроками. Правила эскалации — набор инструкций внутри неё, определяющих «как» и «когда» передавать инцидент. Матрица отвечает на вопрос «кому», правила — «при каких условиях». Без правил матрица остаётся статичным документом без механизма запуска.
Как составить матрицу эскалации с нуля?
Восемь шагов: определить типичные риски → оценить их влияние → оценить сложность устранения → распределить по уровням (низкий / средний / высокий / критический) → назначить ответственных → установить SLA → настроить автоматические уведомления в ITSM-системе → провести аудит графика дежурств и обновить матрицу при изменениях в команде или технологиях.
Какие бывают виды эскалации?
Три вида: иерархическая (по должности — junior → senior → руководитель), функциональная (по специализации — передача профильному специалисту независимо от уровня) и автоматическая (по таймеру — платформа сама эскалирует, если оповещение не подтверждено в срок). IT-команды, как правило, комбинируют все три вида в одной матрице.
Что значит эскалировать проблему или обращение?
Передать нерешённую задачу вышестоящему сотруднику или профильному специалисту — когда текущий исполнитель не справился самостоятельно или превышено допустимое время реакции по SLA. Эскалация — не признак некомпетентности: это штатный механизм управления инцидентами, предусмотренный матрицей заранее.
Как матрица эскалации используется в IT и DevOps?
Дежурный инженер получает оповещение и пытается устранить инцидент. Не удаётся в отведённое время — эскалирует старшему инженеру или SRE. Уровень серьёзности от Severity 1 (критический) до Severity 3 (незначительный) задаёт скорость реакции и глубину цепочки уведомлений. Автоматизация через Opsgenie или Jira Service Management убирает человеческий фактор при пропуске оповещения.
Какие ошибки чаще всего встречаются при работе с матрицей эскалации?
Три распространённые ошибки: неверная классификация рисков по уровням (Severity 1 обрабатывается как Severity 3), отсутствие чёткого разделения ответственности между ролями, пропуск регулярного аудита графика дежурств. Дополнительная ошибка — создание жёстких регламентов вместо гибких рекомендаций: Google SRE намеренно трактует правила эскалации как адаптируемые под реальные ситуации ориентиры.
По каким метрикам оценивают эффективность матрицы эскалации?
Ключевые показатели: MTTR — среднее время восстановления после инцидента (чем ниже, тем эффективнее матрица), FCR — доля обращений, решённых при первом контакте (актуально для контакт-центров), время реакции дежурного инженера на оповещение. Рост любого из этих показателей — сигнал пересмотреть структуру матрицы или обновить правила эскалации.
Подайте заявку —
забронируйте место в группе
45 000 мест на 2026 год. Бесплатное обучение по федеральному проекту «Активные меры содействия занятости»
- Онлайн
- От 2 месяцев
- Бесплатно
- Диплом