Что такое подзапросы в SQL (вложенные запросы): виды, примеры и когда применять
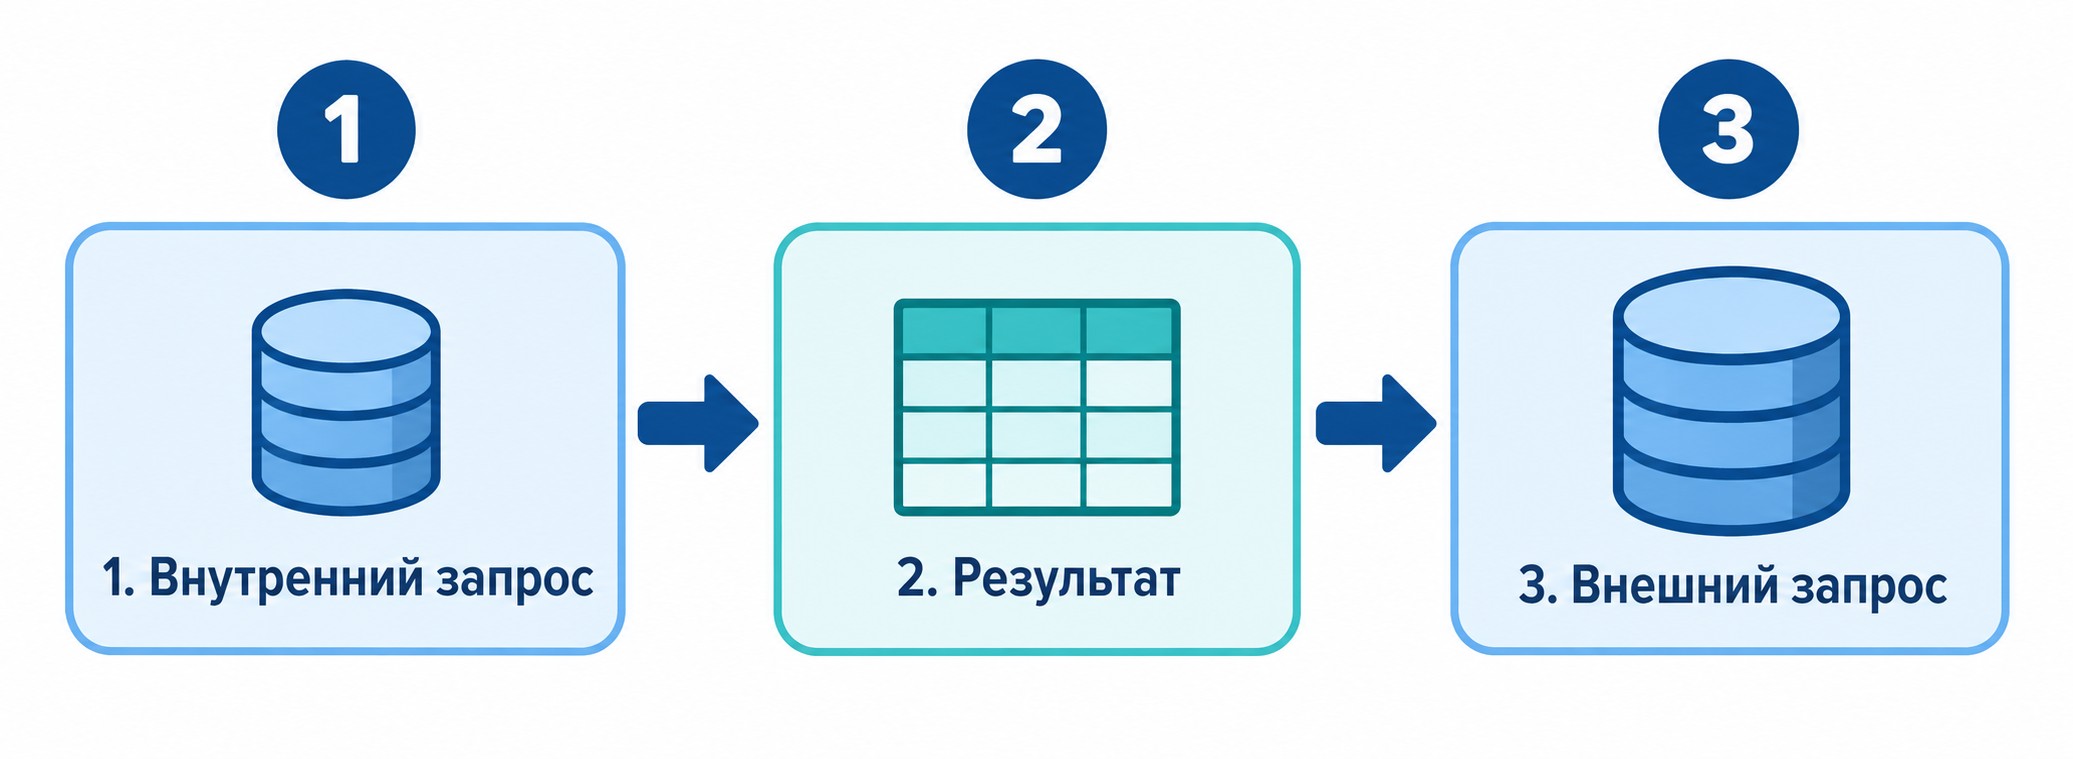
Подзапрос (вложенный запрос, subquery) — оператор SELECT, вложенный в тело другого SQL-оператора. СУБД (система управления базами данных) выполняет внутренний запрос первым и передаёт результат внешнему. Один показательный пример — выборка сотрудников с зарплатой выше средней по компании:
SELECT name, salary
Учитесь бесплатно за счёт государства
Экономия до 100 000 ₽ на любой программе
FROM employees
WHERE salary > (SELECT AVG(salary) FROM employees);
Подзапросы в SQL решают три типовых задачи: фильтрация по агрегату, проверка существования записей и сравнение с вычисленным значением. Далее — виды и классификация, операторы IN/EXISTS/ANY/ALL, коррелированные подзапросы, сравнение с CTE и JOIN, типичные ошибки и практические задачи.
Подзапрос в SQL — что это такое и как работает
Подзапрос подчиняется правилам обычного SELECT: у него есть список столбцов, источник данных и условие фильтрации. Внешний оператор (SELECT, UPDATE, DELETE) использует результат внутреннего как константу, набор строк или виртуальную таблицу. СУБД считает внутренний запрос первым — как черновик, — и только потом строит итоговую выборку.
SELECT product_name
FROM products
WHERE price > (SELECT AVG(price) FROM products);
Внутренний и внешний запрос — порядок выполнения СУБД
Любой вложенный запрос в SQL состоит из двух уровней: внутренний (inner query) и внешний (outer query). Порядок выполнения зависит от типа подзапроса.
- Простой подзапрос: СУБД выполняет внутренний запрос один раз, получает результат и подставляет его в внешний оператор.
- Коррелированный подзапрос: внутренний запрос ссылается на строки внешнего, поэтому запускается отдельно для каждой его строки.
Если подзапрос можно запустить самостоятельно и получить осмысленный результат — он простой. Если нет — коррелированный.
Виды подзапросов в SQL — классификация
Подзапросы классифицируют по двум критериям: по форме результата (скалярный или табличный) и по способу выполнения (простой или коррелированный). Критерии независимы — любой тип может сочетаться с любым способом выполнения.
| Простой |
Коррелированный |
|
|---|---|---|
| Скалярный (1×1) | WHERE price > (SELECT AVG(price) FROM products) — вычисляется один раз | SELECT name, (SELECT dept FROM depts WHERE id = e.dept_id) FROM employees e — для каждой строки |
| Табличный (набор строк) | WHERE id IN (SELECT id FROM orders WHERE status=’new’) — вычисляется один раз | WHERE EXISTS (SELECT 1 FROM orders o WHERE o.client_id = c.id) — для каждой строки |
По результату — скалярный и табличный подзапрос
Скалярный подзапрос возвращает ровно одну строку и один столбец — единственное значение. Чаще всего использует агрегатные функции: AVG, MAX, MIN, SUM, COUNT. Если внутренний SELECT вернёт более одной строки — СУБД выдаст ошибку времени выполнения.
Табличный подзапрос возвращает набор строк. Внешний оператор обрабатывает этот набор через IN, ANY, ALL или использует его как виртуальную таблицу в FROM или JOIN.
— Скалярный: WHERE с агрегатом
SELECT name FROM products
WHERE price > (SELECT AVG(price) FROM products);
— Табличный: WHERE с IN
SELECT name FROM clients
WHERE id IN (SELECT client_id FROM orders WHERE status = ‘paid’);
По способу выполнения — простой и коррелированный
Простой подзапрос не зависит от внешнего запроса. Его можно запустить отдельно и получить тот же результат — СУБД выполняет его ровно один раз.
Коррелированный подзапрос ссылается на столбцы внешнего запроса и не может работать независимо. СУБД запускает его заново для каждой строки внешнего оператора — это принципиально меняет производительность на больших таблицах.
Подзапросы в WHERE, SELECT и HAVING
Подзапросы в SQL размещаются в трёх ключевых клаузах: WHERE — основное место для скалярного фильтра; SELECT — для вычисляемого столбца в каждой строке; HAVING — для фильтрации групп после GROUP BY.
SQL — базовый инструмент аналитика данных. Если вы развиваете навыки в этой сфере, в рамках нацпроекта «Кадры» можно бесплатно пройти программу «Специалист по аналитике и базам данных в информационных системах» онлайн, с нуля и без отрыва от работы. Подробности — в каталоге доступных программ.
Скалярный подзапрос в WHERE — сравнение с агрегатом
Самый распространённый случай: запрос в запросе возвращает одно число, внешний оператор сравнивает с ним каждую строку. Подзапрос работает как константа — вычисляется один раз для всей выборки.
— Товары дороже средней цены
SELECT name, price
FROM products
WHERE price > (SELECT AVG(price) FROM products);
— Товары с минимальным остатком на складе
SELECT name, stock_qty
FROM products
WHERE stock_qty = (SELECT MIN(stock_qty) FROM products);
СУБД считает AVG или MIN один раз, а затем фильтрует строки внешнего запроса по этому значению.
Подзапрос в SELECT как вычисляемый столбец
Скалярный подзапрос в SELECT добавляет вычисляемый столбец к каждой строке результата. Пример — отклонение зарплаты сотрудника от средней по компании:
SELECT name, salary,
salary — (SELECT AVG(salary) FROM employees) AS diff_from_avg
FROM employees;
Если подзапрос вернёт более одной строки — СУБД выдаст ошибку. Гарантируйте единственное значение через агрегат или LIMIT 1. Когда select внутри select ссылается на столбцы внешней таблицы — это уже коррелированный подзапрос, и он выполняется для каждой строки отдельно.
Подзапрос в HAVING — фильтрация групп после GROUP BY
HAVING фильтрует группы после агрегирования. Подзапрос вычисляется один раз и выступает порогом сравнения:
SELECT category, AVG(price) AS avg_price
FROM products
GROUP BY category
HAVING AVG(price) > (SELECT AVG(price) FROM products);
Ключевое отличие от WHERE: WHERE работает до агрегирования — со строками, HAVING — после, с группами.
Операторы IN, EXISTS, ANY и ALL для табличных подзапросов
Когда табличный подзапрос возвращает набор строк, внешний оператор работает с ним через четыре группы операторов: IN (вхождение в множество), EXISTS (проверка существования), ANY/SOME (сравнение с любым элементом), ALL (сравнение со всеми элементами).
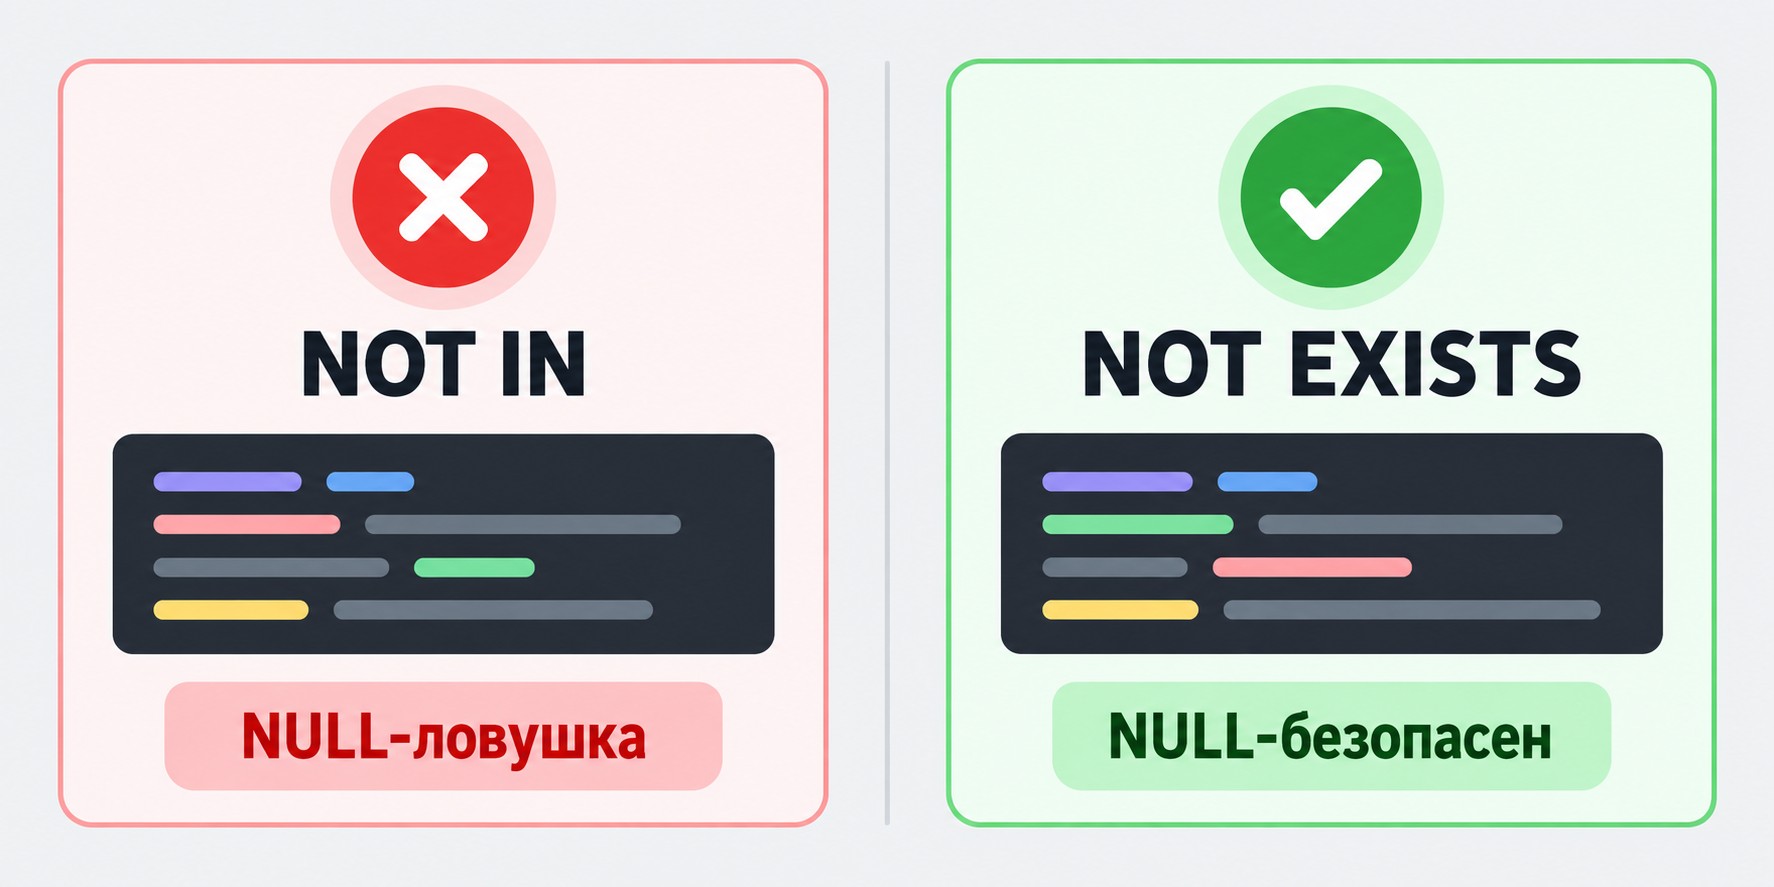
IN и NOT IN — проверка вхождения и ловушка NULL
IN проверяет, входит ли значение в набор из подзапроса:
SELECT name FROM clients
WHERE id IN (SELECT client_id FROM orders);
NOT IN скрывает коварную ловушку: если в подзапросе есть хотя бы одно значение NULL, ни одна строка не пройдёт фильтр. Механика — SQL разворачивает NOT IN в AND-цепочку сравнений, а любое сравнение с NULL даёт UNKNOWN (не FALSE и не TRUE):
5 NOT IN (1, 2, NULL)
→ 5 ≠ 1 AND 5 ≠ 2 AND 5 ≠ NULL
→ TRUE AND TRUE AND UNKNOWN
→ UNKNOWN → строка отбрасывается
Решение: добавить WHERE column IS NOT NULL в подзапрос или заменить NOT IN на NOT EXISTS.
EXISTS и NOT EXISTS — проверка существования строки
EXISTS возвращает TRUE, если подзапрос вернул хотя бы одну строку. Содержимое строки не важно — поэтому принято писать SELECT 1:
SELECT name FROM clients c
WHERE EXISTS (SELECT 1 FROM orders o WHERE o.client_id = c.id);
Ранний выход: EXISTS останавливается на первом совпадении и не сканирует таблицу до конца — это делает его эффективнее IN на больших внутренних таблицах. NOT EXISTS корректно обрабатывает NULL и является надёжной альтернативой NOT IN.
Когда IN удобнее: небольшой фиксированный набор значений, где СУБД применяет хеш-оптимизацию.
ANY, SOME и ALL — сравнение с набором значений
SOME — официальный синоним ANY по стандарту SQL; оба оператора работают абсолютно одинаково, хотя SOME встречается редко. Полезные эквивалентности:
- > ANY (подзапрос) ≡ > MIN(подзапрос)
- > ALL (подзапрос) ≡ > MAX(подзапрос)
Ловушка ALL с пустым подзапросом: если внутренний SELECT не вернул ни одной строки, условие > ALL (…) истинно для всех строк внешнего запроса — поведение неочевидное и требует внимания.
Коррелированные подзапросы в SQL — как работают
Коррелированный подзапрос ссылается на столбцы внешнего запроса — без него он не имеет смысла и не может выполниться самостоятельно. Классический пример: сотрудники с зарплатой выше средней по своему отделу.
SELECT name, salary, department_id
FROM employees e
WHERE salary > (
SELECT AVG(salary)
FROM employees
WHERE department_id = e.department_id
);
Механика работы — цикл: для каждой строки внешнего SELECT СУБД запускает внутренний SELECT заново, подставляя текущее значение e.department_id.
Почему коррелированный подзапрос выполняется медленнее
Сложность — O(n × m): если внешняя таблица содержит 100 000 строк, внутренний подзапрос запустится 100 000 раз. На больших таблицах без индекса это критично для производительности.
PostgreSQL 12+ и MySQL 8+ умеют автоматически оптимизировать часть таких запросов, но не все случаи. Диагностика — команда EXPLAIN (в PostgreSQL — EXPLAIN ANALYZE): строка Nested Loop с большим числом итераций означает коррелированный подзапрос без индекса.
Оптимизация — переписать в JOIN с предвычисленным агрегатом
Паттерн оптимизации: вынести агрегат в подзапрос во FROM, чтобы он считался один раз для всех групп, а не для каждой строки.
— ❌ Коррелированный: AVG считается для каждой строки
SELECT name, salary
Хотите сменить профессию или повысить квалификацию?
Федеральный проект «Активные меры содействия занятости» даёт возможность пройти обучение бесплатно за счёт государства
- Программы от ведущих вузов России — от 2 месяцев
- Удостоверение или диплом установленного образца
- Центр карьеры: 7 500+ вакансий, помощь с трудоустройством
FROM employees e
WHERE salary > (
SELECT AVG(salary) FROM employees
WHERE department_id = e.department_id
);
— ✅ JOIN с предвычисленным агрегатом: AVG считается один раз
SELECT e.name, e.salary
FROM employees e
JOIN (
SELECT department_id, AVG(salary) AS avg_sal
FROM employees
GROUP BY department_id
) dept_avg ON e.department_id = dept_avg.department_id
WHERE e.salary > dept_avg.avg_sal;
После переписывания проверьте результат через EXPLAIN — число итераций должно сократиться.
Подзапрос, CTE или JOIN — что выбрать
CTE (Common Table Expression, обобщённое табличное выражение) объявляется через WITH и позволяет дать подзапросу имя — как именованный шаг с встроенной документацией. Поддерживается в PostgreSQL и MySQL 8+. Расширенный вариант WITH RECURSIVE позволяет строить иерархические запросы — конкуренты его практически не рассматривают.
| Критерий |
Подзапрос |
CTE (WITH) |
JOIN |
|---|---|---|---|
| Читаемость | Средняя при 1 уровне | Высокая при 2+ уровнях | Высокая для соединений |
| Повторное использование | Нет | Да — объявить один раз | Нет |
| Производительность | Зависит от типа | Зависит от СУБД | Обычно быстрее |
| NULL-безопасность | Риск с NOT IN | Нейтральна | Зависит от типа JOIN |
| Когда выбрать | Разовый фильтр WHERE | 2+ уровней вложенности; командный код | Обогащение строк данными |
Практическое правило: начните с JOIN для соединений таблиц → добавьте подзапрос для агрегатной фильтрации в WHERE → переходите на CTE при вложенности два уровня и глубже.
— ❌ Трёхуровневая вложенность — трудно читать
SELECT * FROM orders
WHERE client_id IN (
SELECT id FROM clients
WHERE city_id IN (
SELECT id FROM cities WHERE region = ‘Сибирь’
)
);
— ✅ CTE — каждый шаг назван
WITH siberian_cities AS (
SELECT id FROM cities WHERE region = ‘Сибирь’
),
siberian_clients AS (
SELECT id FROM clients WHERE city_id IN (SELECT id FROM siberian_cities)
)
SELECT * FROM orders
WHERE client_id IN (SELECT id FROM siberian_clients);
Типичные ошибки при работе с подзапросами SQL
Ошибка 1: NOT IN + NULL → пустой результат. Если подзапрос возвращает хотя бы одно NULL-значение, NOT IN возвращает UNKNOWN для каждой строки. Решение: добавить WHERE column IS NOT NULL в подзапрос или заменить на NOT EXISTS.
Ошибка 2: скалярный подзапрос вернул более одной строки. СУБД выдаёт ошибку времени выполнения. Решение: использовать агрегатную функцию MAX или MIN, либо добавить LIMIT 1.
Ошибка 3: избыточная вложенность — три уровня и глубже. Код становится нечитаемым и сложным для отладки. Решение: переписать в CTE с именованными шагами — пример выше в разделе про CTE.
Ошибка 4: коррелированный подзапрос без индекса на большой таблице. Производительность резко падает. Решение: запустить EXPLAIN, найти Nested Loop, переписать в JOIN с предвычисленным агрегатом.
Практические задачи с подзапросами SQL
Задача 1. Товары без ни одного заказа — NOT EXISTS надёжнее NOT IN при возможных NULL:
SELECT name FROM products p
WHERE NOT EXISTS (SELECT 1 FROM order_items oi WHERE oi.product_id = p.id);
Задача 2. Лучший по зарплате в каждом отделе — коррелированный подзапрос или оконная функция RANK():
— Через коррелированный подзапрос
SELECT name, salary, department_id
FROM employees e
WHERE salary = (
SELECT MAX(salary) FROM employees WHERE department_id = e.department_id
);
— Альтернатива — оконная функция
SELECT name, salary, department_id FROM (
SELECT name, salary, department_id,
RANK() OVER (PARTITION BY department_id ORDER BY salary DESC) AS rnk
FROM employees
) ranked
WHERE rnk = 1;
Задача 3. Поставщики, поставляющие деталь №1 И деталь №2 — два рабочих варианта:
— Через IN-подзапрос
SELECT supplier_id FROM supplies WHERE part_id = 1
AND supplier_id IN (SELECT supplier_id FROM supplies WHERE part_id = 2);
— Через самосоединение (self-join)
SELECT s1.supplier_id
FROM supplies s1
JOIN supplies s2 ON s1.supplier_id = s2.supplier_id
WHERE s1.part_id = 1 AND s2.part_id = 2;
Задача 4. Зарплата + отклонение от средней — скалярный подзапрос в SELECT:
SELECT name, salary,
salary — (SELECT AVG(salary) FROM employees) AS deviation
FROM employees
ORDER BY deviation DESC;
Часто задаваемые вопросы
Чем подзапрос отличается от JOIN?
Подзапрос — вложенный SELECT, возвращающий значение или таблицу для внешнего оператора. JOIN соединяет таблицы горизонтально. JOIN — основная операция реляционной алгебры, оптимизируется СУБД лучше всего. Подзапрос удобнее для фильтрации по агрегату и проверки EXISTS; JOIN — для обогащения строк данными из другой таблицы.
Почему NOT IN не работает, если в подзапросе есть NULL?
Любое сравнение с NULL в SQL даёт UNKNOWN. NOT IN разворачивается в AND-цепочку: 5 NOT IN (1, 2, NULL) = UNKNOWN → строка не проходит фильтр. Решение: добавьте WHERE column IS NOT NULL в подзапрос или замените NOT IN на NOT EXISTS.
Когда использовать CTE вместо подзапроса?
CTE оправдан когда: 1) подзапрос нужен в нескольких местах запроса; 2) вложенность более двух уровней; 3) запрос читает команда — именованные шаги работают как комментарии. Для одноразового фильтра WHERE id IN (SELECT …) подзапрос компактнее.
Можно ли использовать подзапрос в UPDATE и DELETE?
Да. В UPDATE подзапрос задаёт условие: WHERE category_id IN (SELECT id FROM …). В DELETE: WHERE NOT EXISTS (…). Осторожно с NOT IN в DELETE — NULL-ловушка здесь особенно опасна: можно удалить больше строк, чем планировалось.
В чём разница между EXISTS и IN?
EXISTS останавливается на первом совпадении (ранний выход) — эффективнее при большой внутренней таблице. IN загружает всё множество; удобен для небольшого набора значений с хеш-оптимизацией. NOT EXISTS всегда надёжнее NOT IN при возможных NULL.
Что такое скалярный подзапрос?
Возвращает ровно одно значение — одну строку и один столбец. Используется в WHERE, SELECT, HAVING. При возврате более одной строки СУБД выдаёт ошибку. Гарантируйте единственное значение через агрегаты (MAX, MIN, AVG) или LIMIT 1.
Чем коррелированный подзапрос отличается от простого?
Простой выполняется один раз и не зависит от внешнего запроса. Коррелированный ссылается на его столбцы и выполняется для каждой строки — цикл со сложностью O(n×m). Часто переписывается в JOIN с предвычисленным агрегатом для ускорения.
Как диагностировать медленный подзапрос?
Используйте EXPLAIN (в PostgreSQL — EXPLAIN ANALYZE). Nested Loop с большим числом итераций — признак коррелированного подзапроса без индекса. Простой подзапрос проверьте изолированно: запустите внутренний SELECT отдельно и оцените результат и скорость выполнения.
Что такое самосоединение и зачем оно нужно?
Самосоединение (self-join) — JOIN таблицы с её собственной копией через псевдонимы. Используется для сравнения строк одной таблицы: например, поставщики, одновременно поставляющие деталь №1 и №2. Задача решается и подзапросом с IN, и самосоединением — оба варианта корректны.
Когда не стоит использовать подзапрос?
Избегайте: 1) коррелированных без индексов на больших таблицах — переписывайте в JOIN; 2) вложенности три уровня и глубже — используйте CTE; 3) NOT IN с возможным NULL — заменяйте NOT EXISTS; 4) скалярного в SELECT без гарантии единственной строки в результате.
Подайте заявку —
забронируйте место в группе
45 000 мест на 2026 год. Бесплатное обучение по федеральному проекту «Активные меры содействия занятости»
- Онлайн
- От 2 месяцев
- Бесплатно
- Диплом