UNION и UNION ALL в SQL: в чём разница и когда использовать каждый оператор
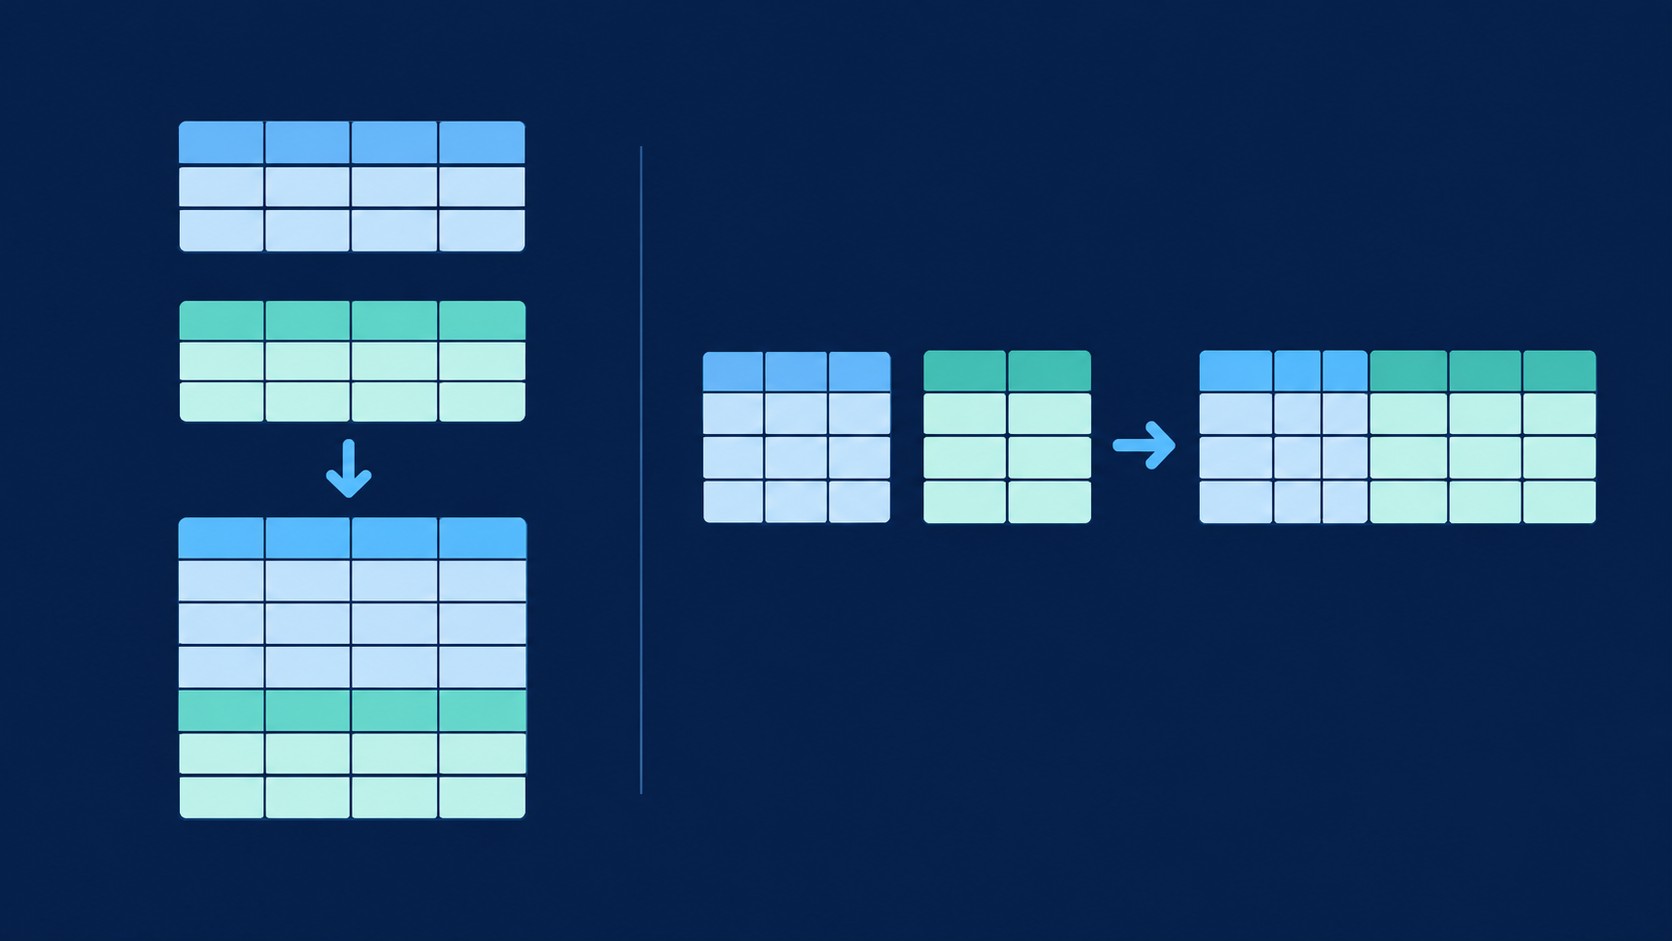
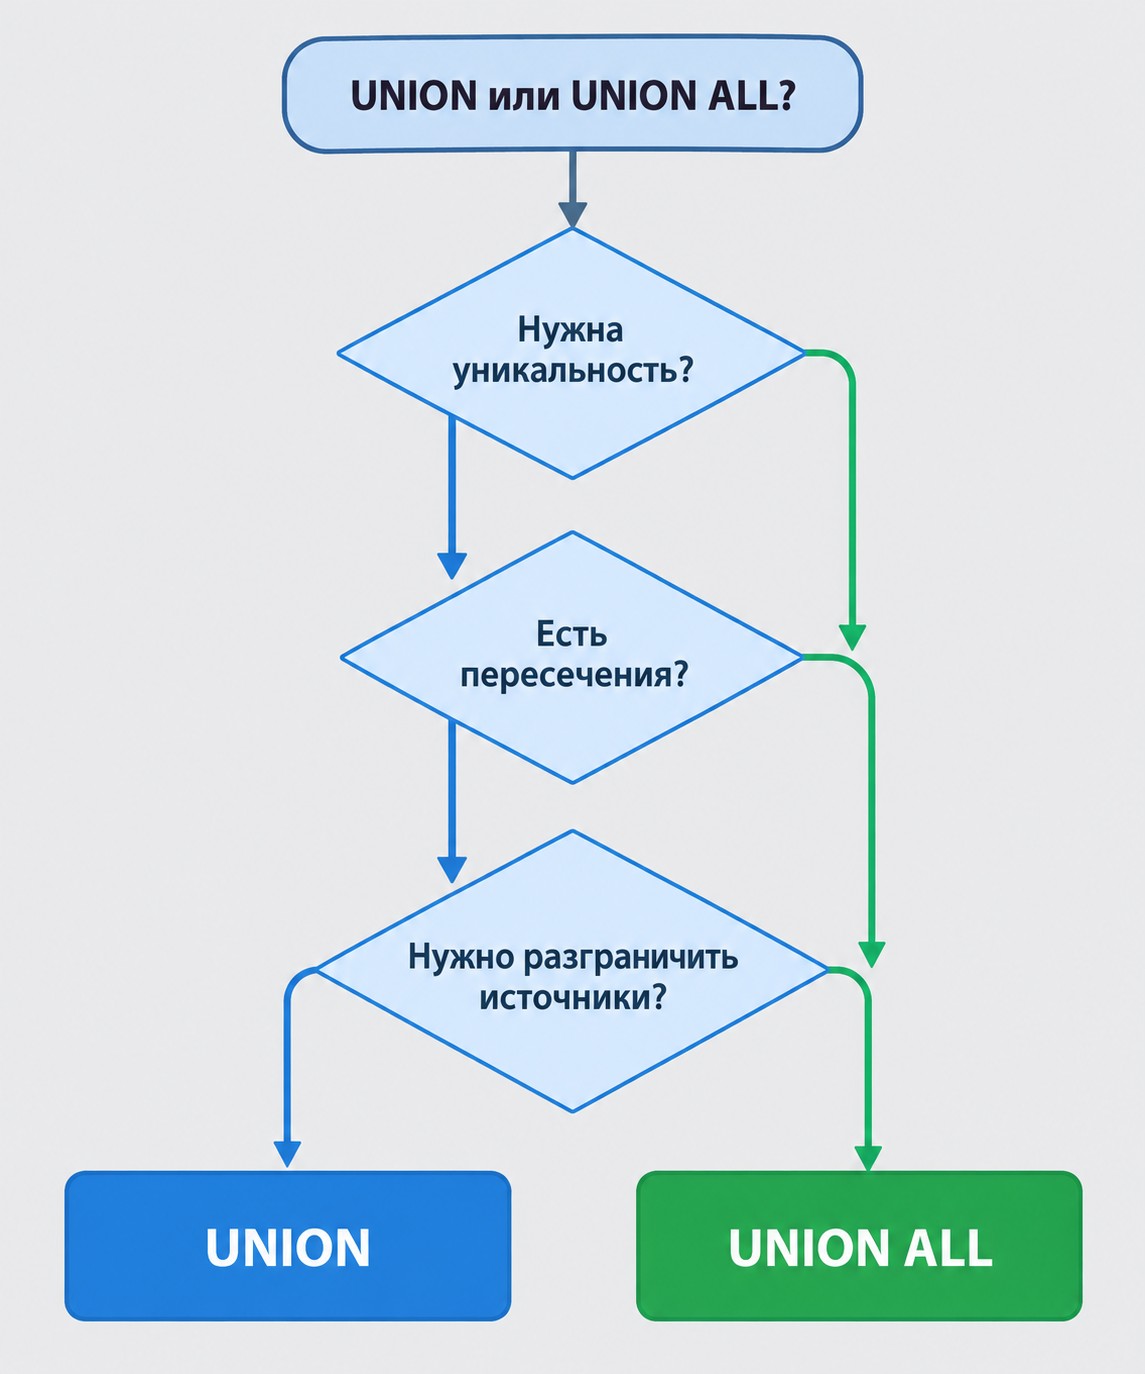
Оба оператора объединяют результаты двух и более SELECT вертикально — строки второго запроса добавляются под строки первого. Разница одна: UNION в SQL удаляет полностью одинаковые строки, UNION ALL сохраняет их все. По скорости UNION ALL выигрывает — ему не нужно проверять повторы. Использовать UNION ALL стоит по умолчанию, переходить на UNION — только когда нужен уникальный результат: список email-адресов, кодов, справочников. При объединении событий, заказов или архивных данных UNION опасен: он молча удаляет строки, случайно совпавшие по всем полям.
Три ключевых параметра в сравнении:
Учитесь бесплатно за счёт государства
Экономия до 100 000 ₽ на любой программе
- Дедупликация — UNION удаляет дубли, UNION ALL сохраняет все строки.
- Скорость — UNION ALL быстрее за счёт отсутствия операции поиска повторов.
- Риск потери данных — UNION при объединении событий может удалить нужные строки.
Оба оператора работают во всех мейнстримных СУБД — различия только в поведении дедупликации и деталях приведения типов.
Что такое UNION в SQL
UNION — set-оператор стандарта SQL-92, который объединяет результаты двух и более SELECT вертикально. Строки второго запроса добавляются под строки первого — не рядом, как в JOIN, а именно снизу. Это вертикальное объединение: число столбцов не меняется, прибавляются только строки. По умолчанию оператор UNION проверяет каждую строку результирующей таблицы на уникальность и удаляет полностью идентичные. Поддерживается во всех мейнстримных СУБД: PostgreSQL, MySQL, MS SQL Server, ClickHouse.
Синтаксис и обязательные условия
SELECT column1, column2 FROM table_a
UNION [ALL]
SELECT column1, column2 FROM table_b;
Ключевое слово ALL — флаг отключения дедупликации. Без него UNION работает в режиме удаления дублей. Два обязательных условия:
- Одинаковое число столбцов в каждом SELECT — нарушение приводит к ошибке выполнения.
- Совместимые типы данных на одинаковых позициях — объединить NVARCHAR и INT без явного приведения типов не получится.
Имена столбцов в результирующей таблице берутся из первого SELECT. Алиасы второго запроса игнорируются. ORDER BY в конце цепочки ориентируется на имена из первого SELECT.
Что такое UNION ALL в SQL
UNION ALL — вариант оператора UNION без дедупликации. Простое конкатенирование: результат первого SELECT плюс строки второго без какого-либо сравнения. Именно поэтому UNION ALL работает быстрее — дорогостоящая операция поиска повторяющихся строк полностью пропускается.
Когда применять UNION ALL:
- объединение заказов за разные периоды из отдельных таблиц;
- архив вместе с текущими данными в одной выборке;
- события или записи из нескольких шардов.
Когда UNION ALL не подходит: если нужен уникальный список — email, страны, коды товаров — применяется UNION. Повторяющиеся строки в справочнике искажают агрегацию и фильтрацию. В остальных случаях UNION ALL — оптимальный выбор.
UNION vs UNION ALL: главные отличия
Одно слово ALL меняет и поведение, и производительность запроса. Сводная таблица по шести параметрам:
| Параметр |
UNION |
UNION ALL |
|---|---|---|
| Дедупликация | Да — удаляет полностью идентичные строки | Нет — сохраняет все строки |
| Производительность | Ниже | Выше |
| Механизм | Сортировка или хеш-таблица | Простое конкатенирование |
| Дополнительная память | Да | Нет |
| Риск потери строк | Да, при объединении событий | Нет |
| Рекомендация | Только при явной нужде в уникальности | По умолчанию в production |
UNION ALL — выбор по умолчанию. Переключаться на UNION стоит только тогда, когда уникальность строк принципиальна для задачи.
Научиться объединять запросы, читать планы выполнения и строить аналитические витрины можно по программе «Специалист по аналитике и базам данных в информационных системах» — 72 часа, бесплатно в рамках нацпроекта «Кадры». Подробнее — в каталоге программ.
Дедупликация: как UNION удаляет строки
UNION сравнивает строки целиком — по всем столбцам одновременно, не по одному полю. Важное следствие: если в двух строках одинаковый email, но разный source — это не дубликаты, UNION их не удалит. Схлопываются только полностью идентичные строки.
Особый случай — NULL. В стандартном SQL условие NULL = NULL возвращает FALSE. Но при дедупликации UNION использует иное правило: две строки с NULL в одинаковых позициях считаются дубликатами. Запрос SELECT NULL UNION SELECT NULL вернёт одну строку. Это поведение отличается от привычного NULL-сравнения и нередко удивляет на практике.
Производительность: почему UNION медленнее
Чтобы найти и удалить дубли, СУБД выполняет дополнительную операцию: сортировку результирующего набора или построение хеш-таблицы. Оба варианта требуют дополнительной памяти и процессорного времени, а при большом объёме данных — создают временные файлы на диске.
Проверить план выполнения запроса помогает EXPLAIN и EXPLAIN ANALYZE в PostgreSQL. При UNION в плане выполнения будет виден шаг Sort или HashAggregate. При UNION ALL этого шага нет.
На небольших таблицах разница незаметна. На миллионах строк — критична. Правило: по умолчанию UNION ALL; переключаться на UNION только при явной нужде в уникальном результате.
Риск потери данных: когда UNION удаляет нужные строки
Типичная ошибка — применить UNION «на всякий случай» при объединении событий. Представим: пользователь кликнул на баннер с десктопа и с мобильного устройства, оба события записаны с одинаковыми полями — user_id, event_type, timestamp, amount. UNION молча удалит одно из них, и аналитика зафиксирует один клик вместо двух.
Решение — UNION ALL плюс колонка-источник:
SELECT user_id, event_type, ‘web’ AS source FROM web_events
UNION ALL
SELECT user_id, event_type, ‘mobile’ AS source FROM mobile_events;
При работе с событиями, заказами и логами — всегда UNION ALL.
UNION и JOIN: горизонтальное против вертикального объединения
JOIN и UNION решают принципиально разные задачи. JOIN — горизонтальное объединение: добавляет столбцы справа по условию ON. Оператор UNION — вертикальное: добавляет строки снизу. Простая аналогия: JOIN «приклеивает» колонки сбоку, UNION «подкладывает» строки снизу.
JOIN требует условия ON и связи между таблицами по ключу. Оператор UNION в SQL требует совместимой структуры: одинакового числа столбцов и совместимых типов данных — связи между таблицами не нужно.
Это разные инструменты для разных задач: JOIN обогащает строки новыми столбцами, UNION наращивает выборку новыми строками. Пример: обогатить таблицу customers атрибутами профиля через JOIN — и добавить к выборке клиентов из другого региона через UNION ALL — типичный паттерн при работе с разбитыми или шардированными таблицами.
Практические примеры с UNION и UNION ALL
Три уровня примеров: базовый (отличие в результате), с ORDER BY и LIMIT, продвинутый с общим табличным выражением (CTE, Common Table Expression). Каждый уровень — рабочий код для реальных задач.
Базовые сценарии
Уникальный список email — когда нужно объединить адреса из двух таблиц без дублей:
SELECT email FROM users
UNION
SELECT email FROM subscribers;
Архив плюс текущие заказы — дедупликация здесь вредна, важны все строки:
SELECT order_id, amount FROM orders_2024
UNION ALL
SELECT order_id, amount FROM orders_2025;
Клиенты с разными тарифами из одной таблицы — UNION ALL склеивает выборки с разными условиями WHERE:
SELECT customer_id, rate FROM contracts WHERE rate > 0.15
UNION ALL
SELECT customer_id, rate FROM contracts WHERE rate <= 0.05;
На одном наборе данных UNION вернёт меньше строк, чем UNION ALL — разница именно в дедупликации.
ORDER BY и LIMIT при UNION
ORDER BY в конце запроса применяется ко всему объединённому результату, а не к одной ветке. Аналогично работает LIMIT. Это стандартное поведение во всех СУБД.
Чтобы отсортировать или ограничить только одну ветку — оберни её в подзапрос:
SELECT * FROM (
SELECT order_id, amount FROM orders WHERE status = ‘paid’
Хотите сменить профессию или повысить квалификацию?
Федеральный проект «Активные меры содействия занятости» даёт возможность пройти обучение бесплатно за счёт государства
- Программы от ведущих вузов России — от 2 месяцев
- Удостоверение или диплом установленного образца
- Центр карьеры: 7 500+ вакансий, помощь с трудоустройством
ORDER BY amount DESC
LIMIT 5
) AS top_paid
UNION ALL
SELECT order_id, amount FROM returns;
Без подзапроса ORDER BY применится к итоговому набору строк или вызовет ошибку синтаксиса — в зависимости от СУБД.
CTE и колонка-источник: паттерны для реальных задач
CTE + UNION ALL — читаемый паттерн для построения витрин данных:
WITH all_orders AS (
SELECT order_id, amount, ‘online’ AS source FROM online_orders
UNION ALL
SELECT order_id, amount, ‘offline’ AS source FROM offline_orders
)
SELECT source, SUM(amount) AS total
FROM all_orders
GROUP BY source;
Колонка source показывает происхождение строки — незаменима при отладке, миграциях и аудите данных. CTE разделяет логику сбора и логику обработки: сначала собираешь через UNION ALL, потом применяешь агрегацию, фильтрацию, сортировку. Это удобнее длинной цепочки вложенных подзапросов и проще расширять при добавлении новых источников.
UNION в PostgreSQL, MySQL, MS SQL Server и ClickHouse
Логика оператора UNION одинакова во всех СУБД — различия в деталях приведения типов данных и диагностики запросов.
PostgreSQL строго проверяет типы: если в одной ветке amount numeric, а в другой amount text, запрос вернёт ошибку. Решение — явный CAST:
SELECT amount::text FROM invoices
UNION ALL
SELECT description FROM notes;
EXPLAIN ANALYZE покажет разницу планов выполнения между UNION и UNION ALL.
MySQL выполняет мягкое неявное приведение совместимых типов — числа и строки могут объединяться без ошибки, но результат способен оказаться неожиданным. ORDER BY внутри одной ветки требует обёртки в подзапрос; начиная с версии 8.1 MySQL следует стандарту SQL-92.
MS SQL Server (T-SQL) работает по стандарту SQL: типы IDENTITY, NVARCHAR, MONEY совместимы только с аналогичными. Синтаксис UNION не отличается от стандартного.
ClickHouse — аналитическая система управления базами данных (СУБД): UNION ALL здесь основной паттерн для объединения потоков событий. Дедупликацию после объединения делают через DISTINCT или агрегацию.
Общий совет для всех СУБД: явный CAST надёжнее неявного приведения — поведение предсказуемо и не зависит от версии базы данных.
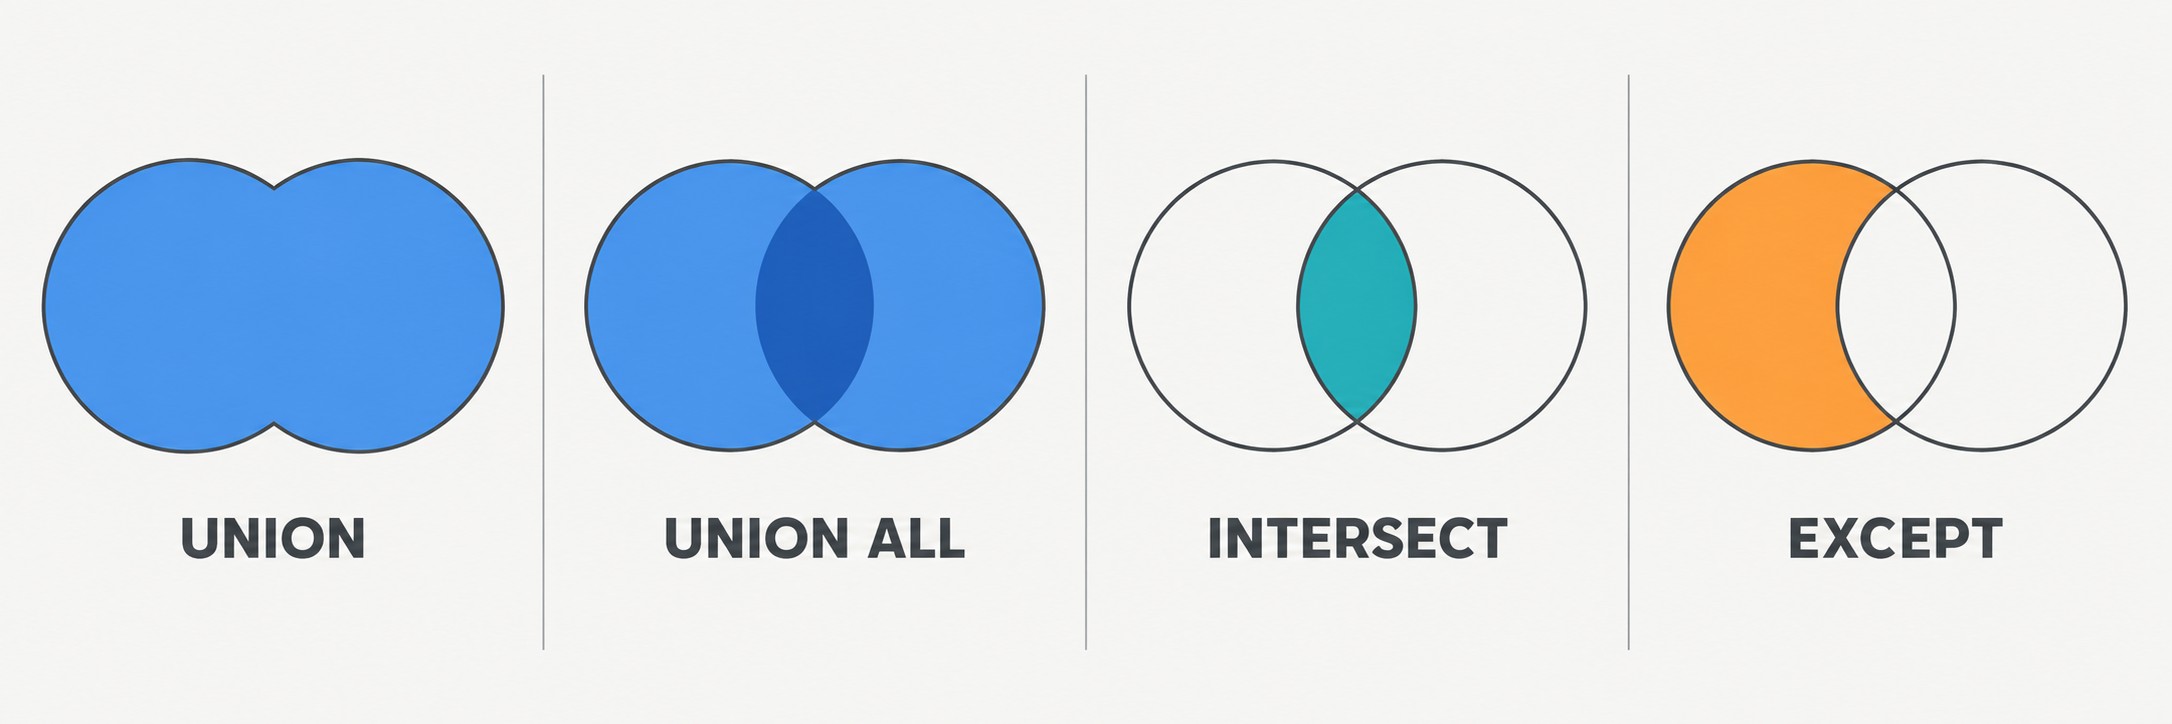
INTERSECT и EXCEPT: другие set-операторы SQL
UNION — не единственный set-оператор в SQL. Рядом с ним работают INTERSECT и EXCEPT.
INTERSECT возвращает только те строки первого SELECT, которые есть и во втором — пересечение множеств (A ∩ B). Применение: найти клиентов, которые одновременно числятся и в старом, и в новом справочнике.
EXCEPT возвращает строки первого SELECT, которых нет во втором — разность множеств (A − B). Применение: клиенты без ни одного заказа, товары без движения на складе.
Все три оператора — UNION, INTERSECT, EXCEPT — требуют одинаковой структуры столбцов: одинакового числа и совместимых типов данных.
Типичные ошибки при использовании UNION
Шесть ошибок, с которыми сталкиваются чаще всего.
- Разное число столбцов — СУБД вернёт ошибку выполнения. Число столбцов в каждом SELECT должно совпадать.
- Несовместимые типы данных на одинаковых позициях — NVARCHAR и INT без явного приведения дадут ошибку в PostgreSQL и MS SQL Server.
- UNION при объединении событий — молча удаляет строки с идентичными полями; заменить на UNION ALL.
- Ожидание дедупликации по одной колонке — UNION удаляет только полностью идентичные строки; для дедупликации по конкретному полю использовать DISTINCT или GROUP BY после объединения.
- ORDER BY в середине цепочки — сортировка возможна только один раз в конце всего выражения; для ветки — подзапрос.
- Несовпадающий порядок столбцов — если в первом SELECT (id, name), а во втором (name, id), данные попадут не в те колонки; ошибки выполнения не будет, но результат окажется семантически некорректным.
Большинство этих ошибок исчезают, если взять за правило использовать UNION ALL по умолчанию и явно прописывать CAST для приведения типов данных.
Часто задаваемые вопросы
В чём главная разница между UNION и UNION ALL в SQL?
UNION объединяет результаты SELECT вертикально и удаляет полностью одинаковые строки по всем столбцам. UNION ALL делает то же, но сохраняет все строки без дедупликации. UNION ALL работает быстрее — база данных просто конкатенирует результирующие наборы без поиска повторов.
Когда использовать UNION, а когда UNION ALL?
UNION — когда нужен уникальный список: email-адреса, страны, коды товаров, записи справочников. UNION ALL — когда важно не потерять строки: события, заказы, логи, архивные данные. Правило: начинай с UNION ALL; переходи на UNION только при явной нужде в уникальности.
Почему UNION медленнее UNION ALL?
UNION выполняет дополнительную операцию дедупликации — сортировку или построение хеш-таблицы. Оба варианта тратят память и CPU, при большом объёме данных создают временные файлы на диске. На небольших таблицах разница незаметна, на миллионах строк — существенна.
Как применить ORDER BY к одной ветке UNION?
ORDER BY в конце запроса применяется ко всему объединённому результату. Чтобы отсортировать только одну ветку — оберни её в подзапрос: SELECT * FROM (SELECT … ORDER BY … LIMIT N) AS sub UNION ALL SELECT …. Без подзапроса сортировка одной ветки невозможна.
Как NULL ведёт себя в UNION?
В стандартном SQL условие NULL = NULL возвращает FALSE. Но при дедупликации в UNION две строки с NULL в одинаковых позициях считаются дубликатами и схлопываются в одну. В UNION ALL оба NULL-значения сохраняются без изменений.
Можно ли объединять более двух запросов через UNION?
Да, UNION выстраивается цепочкой: A UNION B UNION C. Для читаемости сложных цепочек удобнее CTE: сначала собираешь все данные через UNION ALL, потом применяешь агрегацию, фильтрацию, сортировку. Это разделяет логику сбора и анализа данных и упрощает расширение запроса.
Чем UNION отличается от JOIN?
JOIN — горизонтальное объединение: добавляет столбцы по условию ON. Оператор UNION — вертикальное: добавляет строки снизу. JOIN требует связи между таблицами; UNION — одинаковой структуры столбцов. Это разные операции для разных задач.
Чем UNION ALL + DISTINCT отличается от UNION?
По смыслу UNION эквивалентен UNION ALL + DISTINCT по всем столбцам. Но явная конструкция через CTE даёт больше контроля: можно дедуплицировать только по одному полю, добавить колонку-источник или применить дополнительную фильтрацию перед выборкой уникальных значений.
Как добавить колонку-источник при UNION ALL?
Добавь литеральное значение в каждую ветку: SELECT email, ‘users’ AS source FROM users UNION ALL SELECT email, ‘leads’ AS source FROM leads. Колонка source показывает происхождение строки — незаменима при отладке, миграциях и построении витрин данных.
Работает ли UNION одинаково в PostgreSQL, MySQL и MS SQL Server?
Логика одинакова: UNION удаляет дубли, UNION ALL сохраняет все строки. Различия в деталях: PostgreSQL строго проверяет типы и требует явного CAST; MySQL может выполнить неявное приведение с непредсказуемым результатом; MS SQL Server (T-SQL) следует стандарту SQL-92.
Подайте заявку —
забронируйте место в группе
45 000 мест на 2026 год. Бесплатное обучение по федеральному проекту «Активные меры содействия занятости»
- Онлайн
- От 2 месяцев
- Бесплатно
- Диплом