Что такое индексы в PostgreSQL: типы, создание и принцип работы
Индекс в PostgreSQL — структура данных, которая ускоряет поиск строк без полного перебора таблицы. Вместо последовательного просмотра всех записей планировщик получает TID (tuple identifier, идентификатор кортежа) — указатель на точный адрес строки в куче данных. PostgreSQL поддерживает шесть типов индексов: B-tree, Hash, GiST, SP-GiST, GIN и BRIN — каждый оптимален для своего класса задач. Индексы ускоряют выборку, но создают накладные расходы при записи: INSERT, UPDATE и DELETE обновляют не только таблицу, но и каждый её индекс. Планировщик выбирает метод доступа автоматически, на основе статистики и оценки стоимости.
Что такое индекс в PostgreSQL
Без индекса PostgreSQL выполняет последовательное сканирование (sequential scan): читает каждую строку таблицы подряд. При миллионах записей это медленно. Индекс работает как каталог библиотеки: вместо обхода всех полок читатель сразу получает номер стеллажа и полки — и берёт нужную книгу напрямую.
Учитесь бесплатно за счёт государства
Экономия до 100 000 ₽ на любой программе
Технически индекс хранит TID — пару «номер блока + позиция строки внутри блока». По этому указателю PostgreSQL обращается к нужному блоку heap, минуя остальные. Накладные расходы неизбежны: при каждом INSERT, UPDATE и DELETE база перестраивает все индексы затронутой таблицы.
Исключение — механизм HOT (Heap-Only Tuples, обновление только в куче): если UPDATE затрагивает исключительно неиндексированные столбцы, PostgreSQL не перестраивает индекс, ограничиваясь новой версией строки в том же блоке heap. Это снижает накладные расходы при частых обновлениях.
Как PostgreSQL использует индекс при поиске
Когда планировщик получает запрос, он оценивает стоимость всех доступных методов сканирования. При высокой селективности — то есть когда условие отфильтровывает мало строк — индексный путь дешевле. Классический пример:
— Без индекса — sequential scan всей таблицы
SELECT * FROM book WHERE year = 1985;
— С индексом на year — планировщик идёт через B-tree, получает TID и читает нужные строки
CREATE INDEX ON book(year);
SELECT * FROM book WHERE year = 1985;
При низкой селективности (например, status = ‘active’ у 80% строк) планировщик предпочтёт sequential scan: случайный доступ через индекс обходится дороже последовательного чтения всего heap.
Шесть типов индексов PostgreSQL
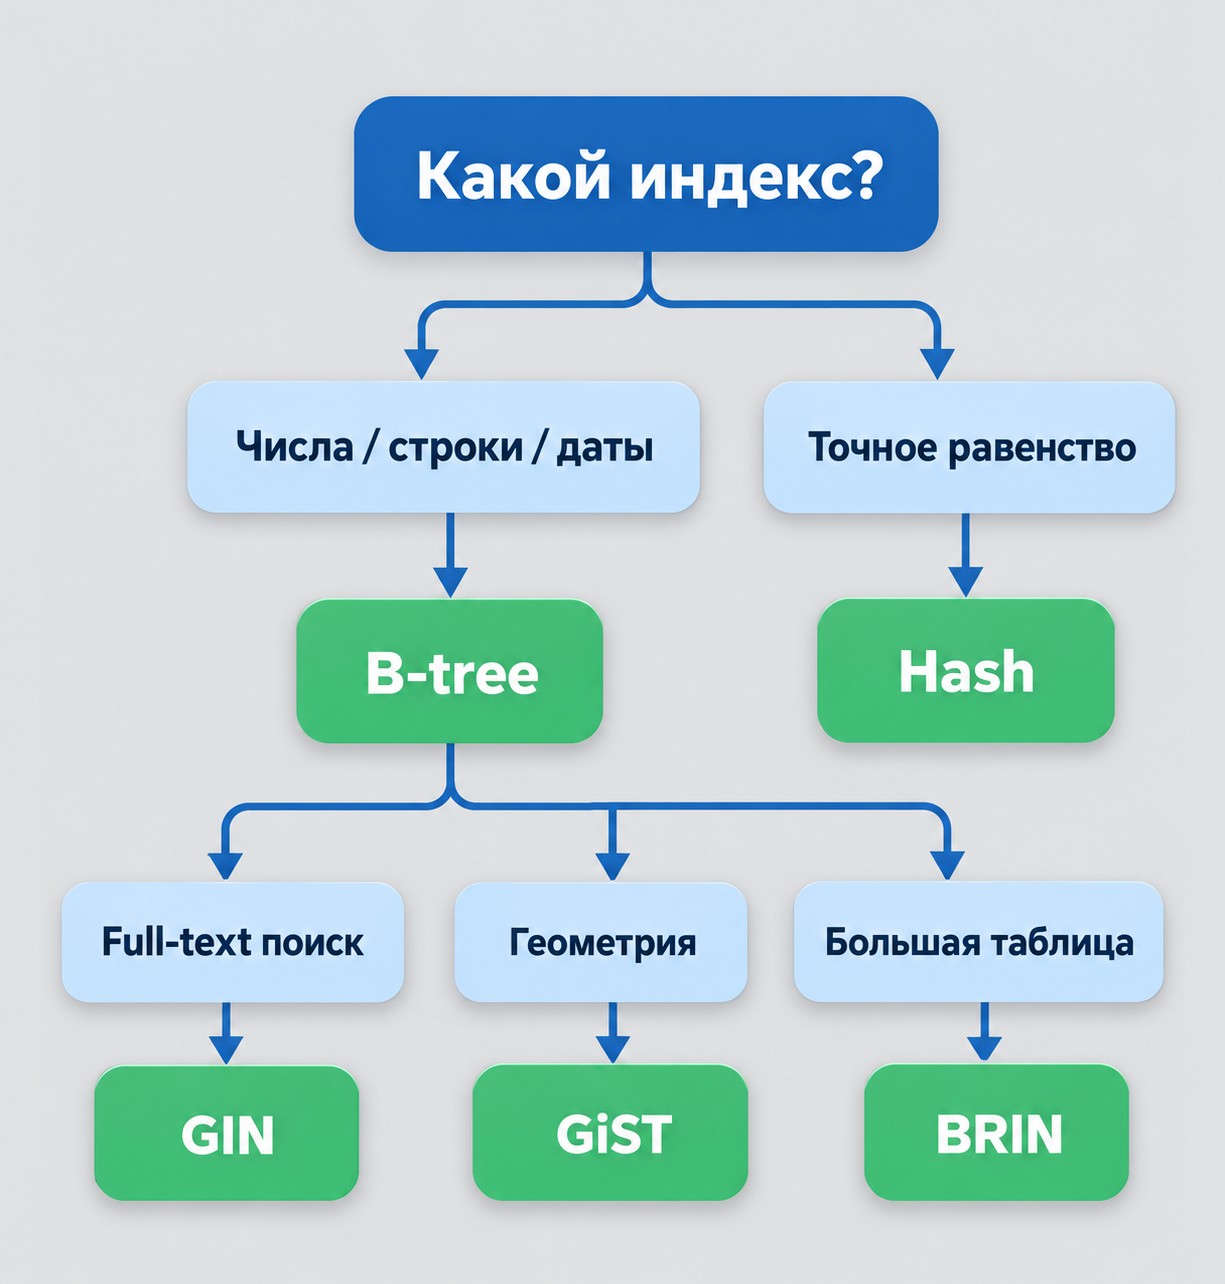
PostgreSQL реализует шесть методов доступа — каждый рассчитан на определённый класс данных и операторов. Ни один не универсален полностью: B-tree подходит для большинства задач, специализированные типы дают выигрыш там, где B-tree не работает.
| Тип |
Лучше всего для |
Основные операторы |
Пример |
|---|---|---|---|
| B-tree | числа, строки, даты | =, <, >, BETWEEN, LIKE ‘px%’ | CREATE INDEX ON t(col) |
| Hash | точное равенство | = | CREATE INDEX ON t USING hash(col) |
| GiST | геометрия, PostGIS, FTS | &&, @>, <-> | CREATE INDEX ON t USING gist(geom) |
| SP-GiST | IP-адреса, непересекающиеся данные | =, <, > | CREATE INDEX ON t USING spgist(col) |
| GIN | JSONB, массивы, полнотекстовый поиск | @>, ?, @@, && | CREATE INDEX ON t USING gin(col) |
| BRIN | большие таблицы, временны́е ряды | =, <, > | CREATE INDEX ON t USING brin(col) |
B-tree — универсальный индекс по умолчанию
B-дерево (B-tree) создаётся без явного USING — это метод по умолчанию. Основан на бинарном поиске: каждый узел дерева делит диапазон значений пополам, поиск за O(log n). Поддерживает любые упорядочиваемые типы: числа, строки, даты, временны́е метки.
Покрывает операторы =, <>, <, >, <=, >=, BETWEEN, LIKE ‘prefix%’, ORDER BY. Поддерживает UNIQUE-ограничения, NULLS FIRST/LAST и составные индексы.
CREATE INDEX idx_orders_customer ON orders(customer_id);
CREATE UNIQUE INDEX idx_users_email ON users(email);
Для большинства OLTP-приложений B-tree достаточно — не нужно искать другой тип без явной необходимости.
Hash, GiST, SP-GiST и BRIN: специализированные методы
Hash — только оператор =, диапазоны и сортировку не поддерживает. До PostgreSQL 10 Hash-индексы не записывались в WAL (Write-Ahead Log, журнал опережающей записи) и при сбое повреждались. С PG10 WAL-поддержка добавлена, но Hash применяется редко: B-tree покрывает те же запросы и предоставляет больше возможностей.
GiST (Generalized Search Tree, обобщённое дерево поиска) — основан на R-дереве. Идеален для геометрических данных и PostGIS. При полнотекстовом поиске медленнее GIN.
SP-GiST — несбалансированные деревья для непересекающихся данных: IP-адреса, телефонные коды, геометрические объекты без пересечений.
BRIN (Block Range INdex) — хранит минимум и максимум значений в диапазоне блоков. Очень компактный. Эффективен для больших таблиц с физически упорядоченными данными: временны́е ряды и журналы событий с монотонно возрастающими датами.
Создание индексов: синтаксис CREATE INDEX
Базовый синтаксис — указываем таблицу и столбец. B-tree по умолчанию:
CREATE INDEX name ON table(column);
Для выбора конкретного типа — директива USING:
CREATE INDEX ON orders USING hash(status);
CREATE INDEX ON articles USING gin(to_tsvector(‘russian’, content));
Работа с базами данных — навык, востребованный в аналитике, разработке и администрировании. В рамках федерального проекта «Активные меры содействия занятости» можно освоить эту область с нуля: смотрите каталог программ обучения — за счёт нацпроекта «Кадры».
Базовый, уникальный и функциональный индексы
Три основных варианта при создании индекса в PostgreSQL:
- Базовый: CREATE INDEX idx_book_year ON book(year); — ускоряет фильтрацию и сортировку по столбцу.
- Уникальный: CREATE UNIQUE INDEX idx_users_email ON users(email); — запрещает дублирующиеся значения, аналог UNIQUE-ограничения с явным именем.
- Функциональный (индекс по выражению): строится на результате вычисления, а не на значении столбца напрямую.
— Поиск без учёта регистра
CREATE INDEX ON users(lower(email));
SELECT * FROM users WHERE lower(email) = ‘user@example.com’;
Функциональный индекс работает только тогда, когда условие в WHERE использует ровно то же выражение, что и индекс. Применяется для поиска с приведением типов, date_trunc() и других вычислений.
Составной и частичный индексы
Составной индекс охватывает несколько столбцов:
CREATE INDEX ON orders(customer_id, order_date);
Действует правило крайнего левого префикса (leftmost prefix rule): индекс (a, b) ускоряет запросы по a или (a, b), но игнорируется при фильтрации только по b. Порядок столбцов критически важен — ставьте вперёд те, по которым фильтруют чаще.
Частичный индекс строится с предикатом WHERE и охватывает только нужные строки:
CREATE INDEX ON orders(status) WHERE status = ‘pending’;
Если 90% заказов имеют status = ‘completed’ и редко запрашиваются, индексировать их нет смысла. Частичный индекс значительно меньше полного, быстрее строится и обновляется — эффективен при сильно неравномерном распределении значений.
Покрывающий индекс (INCLUDE) и CONCURRENTLY
Покрывающий индекс появился в PostgreSQL 11. Ключевое слово INCLUDE добавляет столбцы в индекс без включения в ключ сортировки:
CREATE INDEX ON orders(customer_id) INCLUDE (status, amount);
Планировщик читает status и amount прямо из индекса, не обращаясь к heap — это Index Only Scan. Условие работы: карта видимости (visibility map) должна быть актуальной. Если в EXPLAIN ANALYZE Heap Fetches > 0 — запустите VACUUM.
CONCURRENTLY — построение без блокировки записи:
CREATE INDEX CONCURRENTLY idx_name ON orders(customer_id);
Устанавливает мягкую блокировку SHARE UPDATE EXCLUSIVE: INSERT, UPDATE и DELETE продолжают работать. Строится дольше — два прохода по таблице. Риск: при конкурентных транзакциях индекс может остаться в состоянии INVALID — проверяйте через pg_index и пересоздавайте при необходимости.
Как работают индексы: TID и типы сканирования
TID (tuple identifier, идентификатор кортежа) — пара «номер блока + позиция строки внутри блока». Именно это хранит индекс для каждого проиндексированного значения. Когда планировщик выбирает индексный путь, он получает TID и напрямую читает нужный блок из heap — вместо последовательного перебора всей таблицы.
| Тип сканирования |
Когда применяется |
Доступ к heap |
|---|---|---|
| Index Scan | высокая селективность | да, по одному TID |
| Bitmap Index Scan | средняя селективность | да, страницами |
| Sequential Scan | низкая селективность / малая таблица | весь heap подряд |
| Index Only Scan | покрывающий индекс + актуальная visibility map | нет |
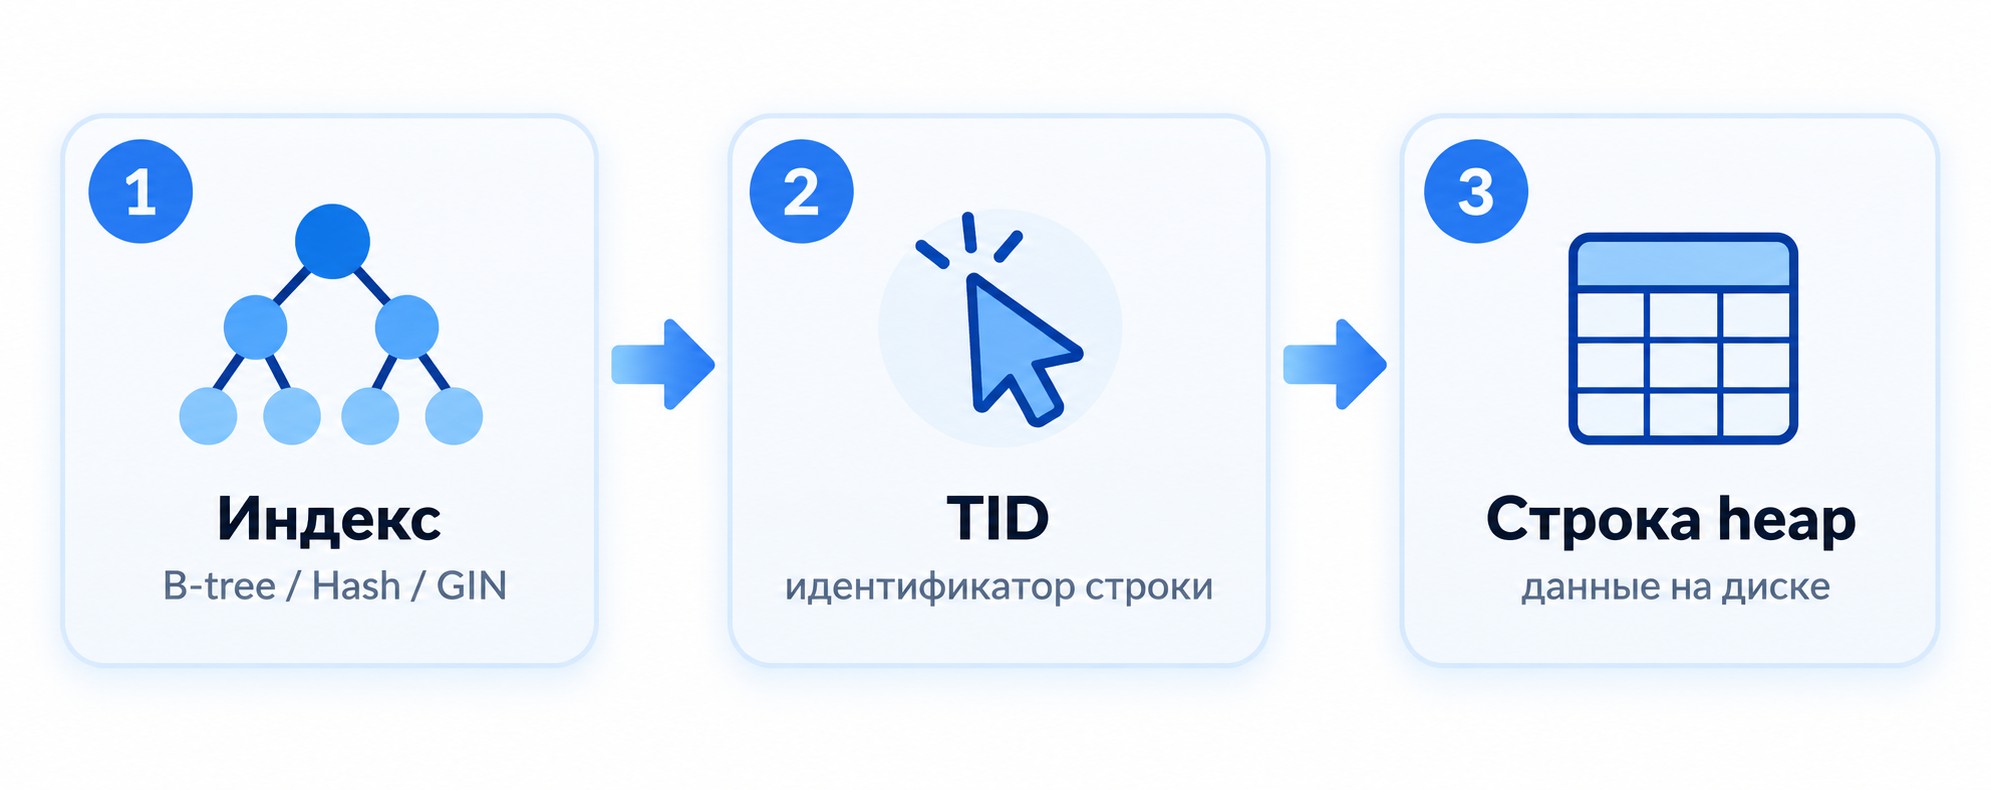
Index Scan, Bitmap, Sequential и Index Only Scan
Index Scan — высокая селективность: планировщик берёт TID из индекса и поочерёдно обращается к строкам в heap. При большом числе случайных обращений к heap производительность снижается.
Bitmap Index Scan — средняя селективность: PostgreSQL сначала строит битовую карту TID-ов из индекса, затем читает heap страницами в порядке возрастания адресов. Снижает количество случайных операций ввода-вывода по сравнению с обычным Index Scan.
Sequential Scan — последовательное чтение всего heap. Быстрее случайного доступа через индекс при низкой селективности или на малых таблицах. Планировщик выбирает его автоматически при соответствующей оценке стоимости.
Index Only Scan — никаких обращений к heap: все нужные данные уже в покрывающем индексе. Heap Fetches = 0 в EXPLAIN ANALYZE подтверждает чистую работу. Если Heap Fetches велики — карта видимости устарела, запустите VACUUM.
Оптимизатор, HOT и WAL
Оптимизатор запросов сравнивает стоимость всех доступных методов сканирования с учётом статистики таблицы, числа строк и распределения значений. Если status = ‘active’ у 80% строк, индекс по этому столбцу будет проигнорирован — sequential scan дешевле.
Механизм HOT снижает overhead записи: UPDATE неиндексированных столбцов не перестраивает индекс. PostgreSQL добавляет новую версию строки в тот же блок heap и связывает её с предыдущей через цепочку указателей.
WAL обеспечивает устойчивость к сбоям. Hash-индексы до PostgreSQL 10 не включались в журнал опережающей записи, что при аварийном завершении приводило к повреждению. С PG10 они полностью безопасны и участвуют в crash recovery наравне с другими типами.
GIN-индексы: полнотекстовый поиск, JSONB и массивы
GIN (Generalized Inverted Index, обобщённый инвертированный индекс) — специализированный тип для составных типов данных. В отличие от B-tree, который хранит одно значение на строку, GIN хранит отдельную запись для каждого элемента составного типа: токена в тексте, ключа в JSON или элемента массива. Три главных применения: полнотекстовый поиск (tsvector), JSONB и массивы.
fastupdate — оптимизация записи: база накапливает изменения в pending list и применяет их пакетно, снижая стоимость частых обновлений. При необходимости немедленной актуализации индекса отключается: WITH (fastupdate = off).
GIN для полнотекстового поиска
CREATE INDEX ON articles USING gin(to_tsvector(‘russian’, content));
Поиск — оператором @@:
Хотите сменить профессию или повысить квалификацию?
Федеральный проект «Активные меры содействия занятости» даёт возможность пройти обучение бесплатно за счёт государства
- Программы от ведущих вузов России — от 2 месяцев
- Удостоверение или диплом установленного образца
- Центр карьеры: 7 500+ вакансий, помощь с трудоустройством
SELECT * FROM articles
WHERE to_tsvector(‘russian’, content) @@ to_tsquery(‘russian’, ‘индекс’);
Функция to_tsvector() обязательна: она нормализует текст в набор лексем. Альтернатива — хранить tsvector в отдельном столбце и индексировать его напрямую, что ускоряет запись.
GIN против GiST для полнотекстового поиска: GIN быстрее ищет, GiST быстрее строится и занимает меньше места. Для большинства задач с tsvector и tsquery выбирают GIN.
GIN для JSONB и массивов
JSONB:
CREATE INDEX ON assets USING gin(metadata);
SELECT * FROM assets WHERE metadata @> ‘{«type»: «server»}’;
Поддерживает @> (содержит), ? (ключ существует), ?&, ?|. Позволяет искать по любому ключу внутри JSON-документа без указания конкретного пути.
Массивы:
CREATE INDEX ON posts USING gin(tags);
SELECT * FROM posts WHERE tags && ‘{postgresql,index}’;
Операторы: && (пересечение), <@ (подмножество), @> (надмножество). GIN строится медленнее B-tree, но поиск по элементам составных типов — принципиально быстрее полного перебора.
Диагностика и управление индексами в PostgreSQL
Работа с индексами делится на три уровня: просмотр (что создано и как используется), проверка (применяет ли планировщик индекс на практике), перестройка и удаление (устранение bloat и лишних индексов). Системные представления PostgreSQL — основной инструмент для всех трёх задач.
Просмотр индексов: pg_indexes и psql
Системное представление pg_indexes показывает имена и DDL всех индексов таблицы:
SELECT indexname, indexdef
FROM pg_indexes
WHERE tablename = ‘orders’;
В psql команда \d+ orders выводит полную схему таблицы вместе с индексами. Для статистики использования — pg_stat_user_indexes:
SELECT indexrelname, idx_scan
FROM pg_stat_user_indexes
WHERE relname = ‘orders’;
idx_scan = 0 после длительной эксплуатации — планировщик не задействует индекс. Кандидат на удаление.
EXPLAIN ANALYZE — проверка использования индекса
Единственный надёжный способ убедиться, что планировщик применяет индекс:
EXPLAIN (ANALYZE, COSTS OFF, BUFFERS ON)
SELECT * FROM orders WHERE customer_id = 42;
Что читать в выводе:
- «Index Scan using idx_orders_customer» — индекс применяется.
- «Seq Scan» — индекс проигнорирован или отсутствует.
- Heap Fetches = 0 — Index Only Scan работает чисто, visibility map актуальна.
- Heap Fetches > 0 при покрывающем индексе — карта видимости устарела, запустите VACUUM.
REINDEX и DROP INDEX: перестройка и удаление
Bloat — накопление мёртвых страниц после интенсивных UPDATE и DELETE: индекс разбухает, производительность падает.
REINDEX INDEX idx_orders_customer;
— PG12+ без блокировки чтения:
REINDEX INDEX CONCURRENTLY idx_orders_customer;
INVALID-индексы — результат неудачного CREATE INDEX CONCURRENTLY. Находим и пересоздаём:
SELECT indexrelid::regclass FROM pg_index WHERE NOT indisvalid;
DROP INDEX без блокировки DML-операций:
DROP INDEX CONCURRENTLY idx_orders_customer;
Удалять стоит при idx_scan = 0, дублировании другого индекса или избыточной нагрузке на запись.
Кластерные индексы в PostgreSQL: разбор заблуждения
В SQL Server и MySQL (InnoDB) кластерный индекс — постоянное свойство таблицы: строки физически хранятся в порядке ключа. В PostgreSQL такого понятия нет. Таблица — это heap: строки размещаются в порядке вставки, без гарантий физического упорядочивания.
Команда CLUSTER выполняет разовую физическую переупорядочивание строк по индексу:
CLUSTER orders USING idx_orders_date;
После выполнения строки таблицы переписываются на диск в порядке индекса — это ускоряет диапазонные запросы по дате. Но порядок не сохраняется: новые INSERT и UPDATE добавляют строки в произвольные блоки heap. Для поддержания порядка CLUSTER нужно периодически запускать вручную.
«Некластерные» индексы в PostgreSQL — все обычные CREATE INDEX. Они вторичные (secondary) по определению: индекс и данные хранятся раздельно, обращение к строке всегда происходит через TID.
Когда индексы снижают производительность
Каждый индекс обновляется при каждой операции записи. Десять индексов на таблице означают десять дополнительных структур при каждом INSERT, UPDATE и DELETE. Четыре ситуации, когда индекс лишний:
- Малые таблицы. Sequential scan быстрее случайного доступа через индекс. Оптимизатор сам выберет SeqScan.
- Низкая кардинальность. Столбец с двумя-тремя значениями (флаг, статус) не даст нужной селективности.
- Столбец вне WHERE, JOIN и ORDER BY. Если столбец не участвует в условиях, индекс никогда не задействуется.
- Массовая загрузка данных. При batch-INSERT временно удалите индексы, загрузите данные, затем перестройте через REINDEX — быстрее, чем обновлять индекс после каждой строки.
Bloat возникает при интенсивных UPDATE и DELETE: мёртвые страницы накапливаются, индекс разбухает. Решение — REINDEX или настройка autovacuum. После каждого CREATE INDEX CONCURRENTLY проверяйте наличие INVALID-индексов через pg_index.
Часто задаваемые вопросы
Какой индекс создаётся в PostgreSQL по умолчанию?
B-tree — применяется без явного USING. Поддерживает любые упорядочиваемые типы данных: числа, строки, даты. Покрывает операторы =, <, >, BETWEEN, LIKE с префиксом, ORDER BY и UNIQUE-ограничения. Для большинства OLTP-приложений B-tree достаточно — не нужно выбирать другой тип без явной причины.
Чем GIN отличается от GiST для полнотекстового поиска?
GIN быстрее при поиске — оптимален, если запросов значительно больше, чем обновлений. GiST быстрее строится и занимает меньше места, но уступает GIN по скорости поиска. Для задач полнотекстового поиска с tsvector и tsquery выбирают GIN. GiST предпочтителен для геометрических данных и PostGIS.
Что такое кластерный индекс в PostgreSQL?
В PostgreSQL постоянного кластерного индекса не существует — в отличие от SQL Server или MySQL. Команда CLUSTER физически переупорядочивает строки таблицы по индексу один раз, но новые INSERT не сохраняют порядок автоматически. Это разовая административная операция, а не постоянное свойство таблицы.
Почему оптимизатор игнорирует индекс и выбирает Seq Scan?
Планировщик выбирает sequential scan при низкой селективности: условие фильтрует большую долю строк (например, status = ‘active’ у 70% записей). Seq Scan предпочтительнее и на малых таблицах: последовательное чтение быстрее случайного доступа. Для диагностики — EXPLAIN ANALYZE.
Как создать индекс без блокировки записи?
Используйте CREATE INDEX CONCURRENTLY. Устанавливает блокировку SHARE UPDATE EXCLUSIVE — разрешает INSERT, UPDATE и DELETE во время построения. Строится дольше (два прохода по таблице). Риск: при конкурентных транзакциях индекс может остаться в состоянии INVALID — проверяйте через pg_index и пересоздавайте при необходимости.
Когда применять частичный индекс?
При сильно неравномерном распределении значений. Если 90% заказов имеют status = ‘completed’ и редко запрашиваются, индексировать их нет смысла: CREATE INDEX ON orders(status) WHERE status = ‘pending’. Частичный индекс значительно меньше полного и быстрее обновляется.
Что такое bloat индексов и как с ним бороться?
Bloat — накопление «мёртвых» страниц в индексе после интенсивных UPDATE и DELETE. Размер индекса растёт, производительность падает. Устраняется командой REINDEX INDEX idx_name или REINDEX INDEX CONCURRENTLY (PostgreSQL 12+, без блокировки чтения). Регулярный autovacuum снижает накопление bloat в фоне.
Как проверить, использует ли PostgreSQL индекс?
Выполните EXPLAIN (ANALYZE, COSTS OFF) SELECT …. Строка «Index Scan using idx_name» подтверждает применение; «Seq Scan» — индекс не задействован. Heap Fetches = 0 означает чистый Index Only Scan для покрывающего индекса. Если Heap Fetches велики — запустите VACUUM для обновления карты видимости.
Зачем нужен INCLUDE в CREATE INDEX?
INCLUDE (col1, col2) (PostgreSQL 11+) добавляет столбцы в индекс без включения в ключ сортировки. Это даёт Index Only Scan: PostgreSQL читает данные из индекса, не обращаясь к heap. Результат — Heap Fetches = 0 в EXPLAIN ANALYZE. INCLUDE-столбцы не влияют на порядок сортировки — в отличие от составного ключа.
Как найти и удалить неиспользуемые индексы?
Проверьте: SELECT indexrelname, idx_scan FROM pg_stat_user_indexes WHERE relname = ‘table’. Если idx_scan = 0 после длительного периода работы — планировщик не задействует индекс. Удалите без блокировки: DROP INDEX CONCURRENTLY idx_name. Убедитесь предварительно, что индекс не поддерживает UNIQUE-ограничение.
Подайте заявку —
забронируйте место в группе
45 000 мест на 2026 год. Бесплатное обучение по федеральному проекту «Активные меры содействия занятости»
- Онлайн
- От 2 месяцев
- Бесплатно
- Диплом