Мониторинг ИТ-инфраструктуры: что это такое, как работает и зачем нужен бизнесу
Мониторинг ИТ-инфраструктуры — непрерывный процесс сбора, обработки и анализа метрик серверов, сетей, виртуальных машин, баз данных и облачных сервисов. Цель — обеспечить бесперебойную работу цифровой среды и реагировать на отклонения прежде, чем они обернутся инцидентом, затрагивающим пользователей.
Любая компания, где работает хотя бы один корпоративный сервер, де-факто ведёт ИТ-бизнес. При этом минута незапланированного простоя обходится крупной организации в 350 000–600 000 рублей — без учёта репутационного урона. В статье разберём, из чего состоит система мониторинга инфраструктуры, какие метрики и инструменты применять, как выстроен принцип работы современных платформ и с чего начать внедрение.
Учитесь бесплатно за счёт государства
Экономия до 100 000 ₽ на любой программе
Что такое мониторинг ИТ-инфраструктуры
Мониторинг ИТ-инфраструктуры — трёхуровневый процесс: сбор сырых данных с оборудования (фундаментальный уровень), анализ состояния программных сервисов и интерпретация метрик через дашборды и алерты. Объекты контроля охватывают весь стек: физические серверы, сетевые устройства, виртуальные машины, базы данных, API-шлюзы и облачные среды.
Данные поступают в двух режимах. Мониторинг в реальном времени фиксирует отклонения немедленно — критично для сервисов с SLA выше 99,9%. Периодический опрос применяется там, где посекундная точность избыточна, но общий план состояния инфраструктуры важен для планирования и отчётности. Телеметрия передаётся через стандартные протоколы: SNMP (протокол управления сетью), ICMP, SSH, WMI и IPMI.
Мониторинг и наблюдаемость — в чём разница
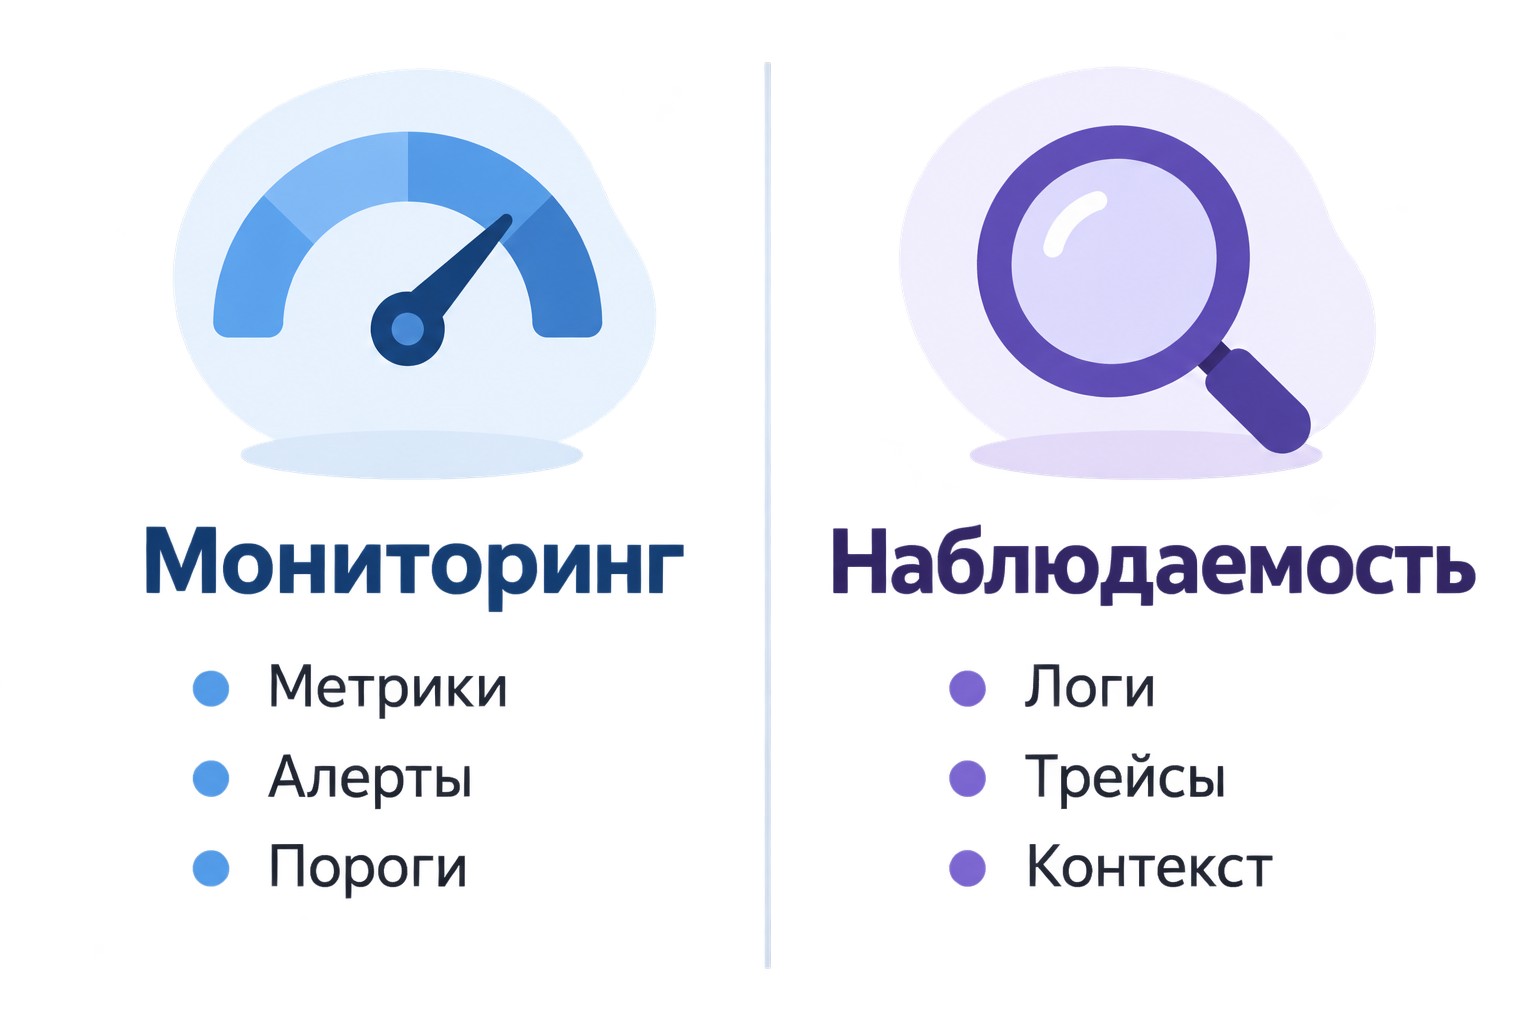
Мониторинг отвечает на вопрос «что сломалось?» — фиксирует отклонение метрики от порогового значения и генерирует алерт. Наблюдаемость (Observability) — более широкое свойство системы: она позволяет понять «почему это произошло». Три столпа наблюдаемости — метрики, логи и трассировки — дают инженеру полный контекст инцидента для анализа первопричин. Мониторинг ИТ-сервисов входит в наблюдаемость как базовый уровень, но не заменяет её целиком.
Зачем бизнесу нужен мониторинг ИТ-инфраструктуры
Без выстроенной системы мониторинга компания управляет инфраструктурой вслепую. Четыре главных бизнес-риска:
- Незапланированные простои. Сервис недоступен несколько минут — теряются транзакции, пользователи и партнёры.
- Нарушение SLA (соглашения об уровне обслуживания). Штрафные санкции и потеря контрактов.
- Пропущенные инциденты. Деградация производительности остаётся незамеченной неделями, пока не становится критичной.
- Репутационные потери. Публичный сбой на высоконагруженной платформе быстро становится новостью.
Системы мониторинга и управления ИТ-инфраструктурой переводят команду из реактивного режима («тушение пожаров») в проактивный: проблемы устраняются до того, как пользователи их замечают.
Ключевые потребители мониторинга — NOC (сетевой операционный центр), SRE-команды (проектирование надёжности сайта, Site Reliability Engineering), DevOps и SOC. NOC следит за доступностью, SRE — за надёжностью, SOC использует данные мониторинга для выявления угроз безопасности.
Финансовые последствия незапланированных простоев
Стоимость простоя для крупного бизнеса — 350 000–600 000 рублей в минуту, для e-commerce в пиковые периоды счёт идёт на миллионы. Показательный пример: сеть из 4 000 касс, у которой задержка транзакций превысила 300 мс, получит алерт в Telegram через несколько секунд — операторы успевают среагировать до остановки обслуживания. Отсутствие мониторинга в такой ситуации напрямую превращается в прямые финансовые потери без возможности быстрой локализации причины.
Типы мониторинга ИТ-инфраструктуры
Системы мониторинга ИТ охватывают несколько уровней стека — от физического оборудования до пользовательских сценариев. Конкретный тип определяется тем, что именно нужно контролировать.
| Тип |
Объекты контроля |
Инструменты / протоколы |
|---|---|---|
| Серверный | CPU, RAM, диск, процессы ОС | Zabbix-агент, SNMP, IPMI |
| Сетевой | Маршрутизаторы, коммутаторы, пропускная способность | SNMP, ICMP, NetFlow |
| Облачный | Kubernetes-кластеры, контейнеры, автомасштабирование | Prometheus, CloudWatch |
| Безопасность | Логи доступа, аномальные события | SIEM (управление событиями ИБ) |
| APM | Транзакции, latency API, трассировки | Jaeger, Elastic APM |
| Бизнес-активность | Конверсия, число заказов, RPM | BI-инструменты, Grafana |
На практике типы не исключают друг друга — в большинстве корпоративных сред они работают параллельно, а данные агрегируются в единую платформу.
Ключевые метрики мониторинга ИТ-инфраструктуры
Метрики — основа любого мониторинга. Без чёткого набора показателей невозможно задать пороговые значения и настроить осмысленные алерты. Четыре базовые группы:
- Доступность (uptime). Цель — 99,99%+ для критичных сервисов. Даже показатель 99,9% означает 8,7 часа недоступности в год.
- Задержка (latency). Инженерный стандарт — p95 и p99: 95-й и 99-й процентиль времени ответа. Задержка эндпоинта /login более 500 мс на протяжении 5 минут — типичный триггер алерта.
- Процент ошибок (error rate). Доля HTTP 5xx, таймаутов и отказов к общему числу запросов.
- Загрузка ресурсов. CPU, RAM, дисковый ввод-вывод и сетевые интерфейсы — базовые показатели здоровья инфраструктуры.
Ключевой операционный KPI — MTTR (среднее время восстановления после сбоя, Mean Time To Restore). Чем ниже MTTR, тем эффективнее работает система мониторинга. AIOps-платформы сокращают его с часов до минут за счёт автоматической корреляции событий и определения первопричин.
Хотите освоить работу с системами мониторинга и защиты ИТ-инфраструктуры? В рамках нацпроекта «Кадры» для этого доступна программа «Кибербезопасность: администрирование и мониторинг средств защиты информации» — бесплатно, онлайн, с нуля. Смотрите полный каталог программ обучения.
Популярные инструменты мониторинга ИТ-инфраструктуры
Выбор инструментов зависит от трёх переменных: масштаб среды, зрелость DevOps-команды и бюджет. Ниже — разбор четырёх наиболее распространённых платформ, каждая из которых закрывает свою нишу.
Zabbix — универсальная платформа мониторинга
Zabbix — открытая платформа (open-source) для мониторинга on-premise инфраструктуры. Поддерживает агентскую схему (установка программы-агента на хост) и безагентную — через SNMP, IPMI и WMI. В актуальной версии Zabbix 7 появились расширенные возможности авто-дискавери (автоматическое обнаружение новых узлов сети), триггеры с уровнями серьёзности — от информационного до катастрофического — и готовые шаблоны для популярных вендоров.
Ограничение: при тысячах узлов требуется тщательная настройка базы данных и прокси-нод, иначе производительность ядра деградирует. Интеграция с Grafana компенсирует ограниченные визуализационные возможности нативного интерфейса. Подробнее об архитектуре и конфигурации — в книге Брайана ван Тондера (Brian van Tonder) «Zabbix 7. Мониторинг ИТ-инфраструктуры» издательства Packt Publishing, см. раздел ниже.
Prometheus и Grafana — стек для облачных сред
Prometheus — система мониторинга с pull-моделью: она сама опрашивает целевые эндпоинты, а не ждёт push-метрик. Встроенный язык запросов PromQL позволяет строить сложные выражения для агрегации и фильтрации данных. Нативная интеграция с Kubernetes и экспортёры для сотен сервисов делают Prometheus де-факто стандартом для облачных сред. Для долгосрочного хранения метрик подключают Thanos или Cortex — они реализуют горизонтальную федерацию нескольких инсталляций.
Grafana выступает универсальным слоем визуализации: подключается к Prometheus, Zabbix, InfluxDB и поддерживает ролевые дашборды. SRE видит live-графики по latency, CTO — недельную сводку по SLA, маркетолог — данные конверсии.
Nagios — классический open-source мониторинг
Nagios — один из старейших инструментов с обширной экосистемой плагинов для проверки HTTP, SMTP, FTP и других протоколов. Поддерживает как агентскую, так и безагентную схемы. Ограничения: устаревший интерфейс и сложность масштабирования при росте инфраструктуры — большинство команд добавляют Grafana поверх для визуализации метрик.
| Платформа |
Модель сбора |
Сильная сторона |
Применение |
|---|---|---|---|
| Zabbix | Агент + SNMP | Универсальность, on-premise | Корпоративная ИТ-инфраструктура |
| Prometheus | Pull (HTTP) | Cloud-native, PromQL | Kubernetes, микросервисы |
| Grafana | — (визуализация) | Единый источник для дашбордов | Отчётность для всей команды |
| Nagios | Агент + плагины | Зрелая экосистема плагинов | Классический мониторинг сервисов |
Российские системы мониторинга ИТ-инфраструктуры
На фоне курса на импортозамещение спрос на отечественные системы мониторинга ИТ заметно вырос в 2024–2025 годах. На рынке присутствуют четыре платформы с разными архитектурными подходами и целевыми нишами.
КМУТ — аппаратно-программный комплекс
КМУТ — российский аппаратно-программный комплекс (ПАК) для мониторинга качества услуг связи и состояния ИТ-инфраструктуры. В основе — зондовая архитектура: специализированные зонды размещаются в географически распределённых точках сети и передают данные в центральную систему. Поддерживает UML-модели и широкие API-интеграции с внешними платформами.
Ключевое преимущество КМУТ — метрологически-валидированные результаты измерений с юридической значимостью. Это критично для операторов связи, обязанных документировать качество услуг перед регулятором.
ПАК wiSLA, Пульт и Artimate
ПАК wiSLA — единственная российская система мониторинга со статусом «утверждённого типа средства измерений» по реестру Росстандарта. Поддерживает гибридное развёртывание и работает в режиме 24/7 с высокой метрологической точностью.
«Пульт» построен на базе Zabbix и расширен enterprise-функциями: модуль отчётности, преднастроенные шаблоны для типовых сред, оптимизированная производительность. Подходит организациям, которым нужна поддержка и локализация без самостоятельного сопровождения open-source-решения.
Artimate — AIOps-платформа: автоматически коррелирует события из разных источников, снижает информационный шум алертов на 95%, обеспечивает SLA до 99,9999% и интегрируется с популярными системами мониторинга.
Хотите сменить профессию или повысить квалификацию?
Федеральный проект «Активные меры содействия занятости» даёт возможность пройти обучение бесплатно за счёт государства
- Программы от ведущих вузов России — от 2 месяцев
- Удостоверение или диплом установленного образца
- Центр карьеры: 7 500+ вакансий, помощь с трудоустройством
Как устроена система мониторинга: принцип работы
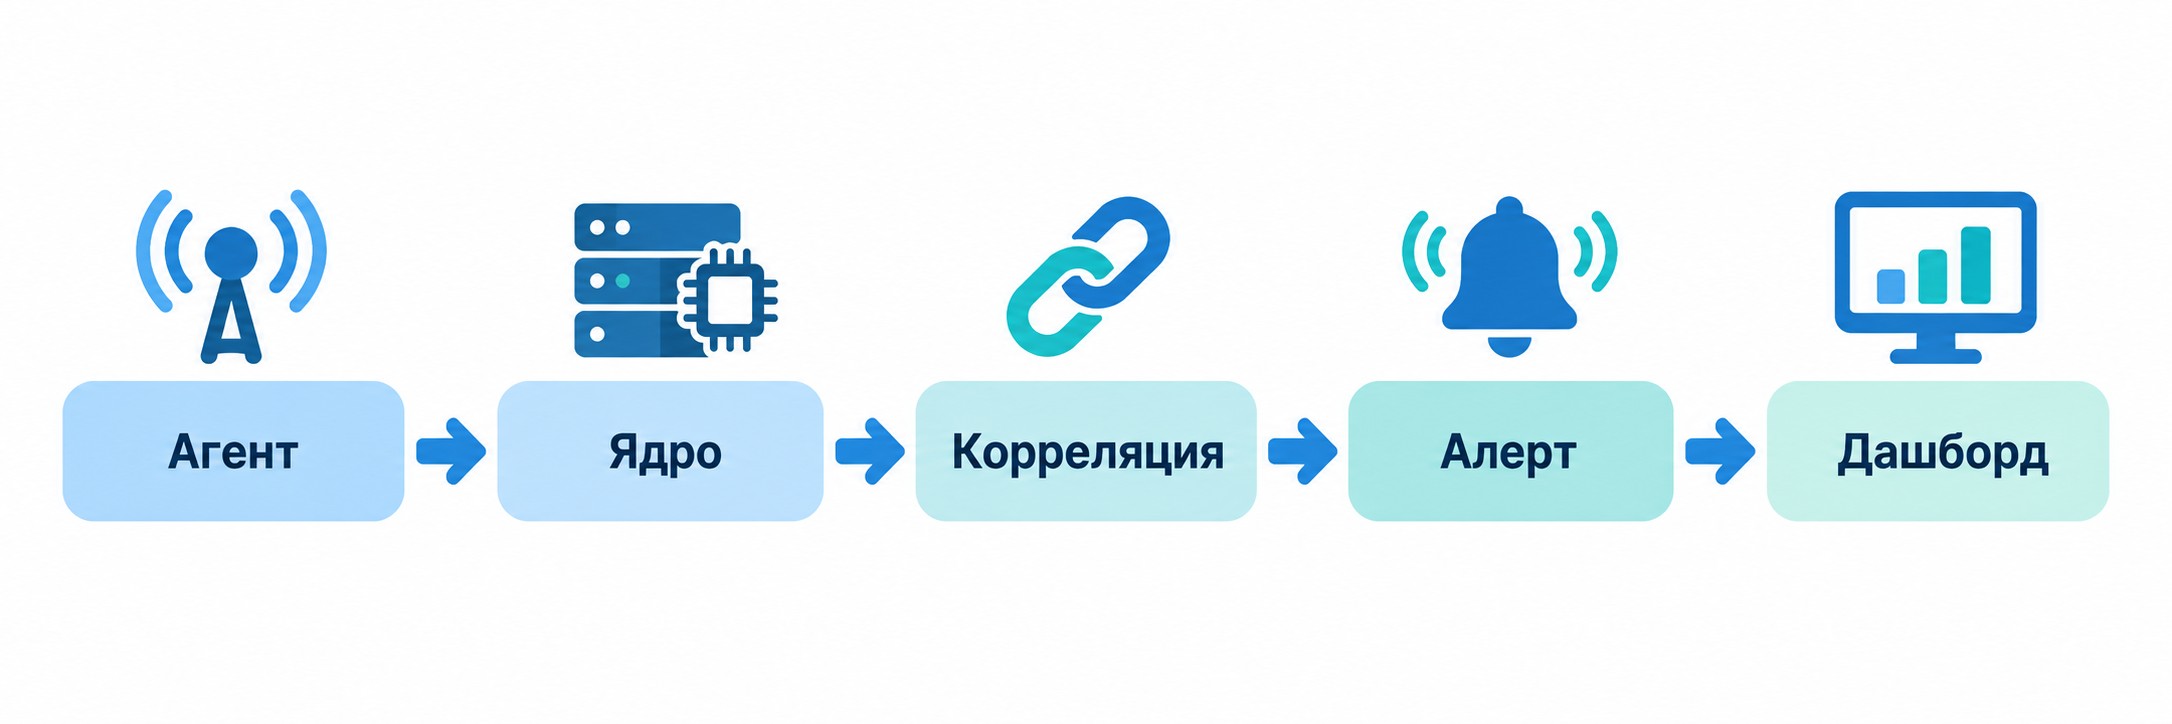
Типовая архитектура системы мониторинга ИТ-оборудования включает пять уровней. Агенты или зонды собирают метрики и передают в ядро — приёмник данных. Ядро записывает метрики в базу данных временных рядов (TSDB). Движок корреляции анализирует потоки событий и выявляет аномалии. При превышении пороговых значений формируется алерт с уровнем серьёзности (warning или critical) и маршрутизируется в нужный канал: Telegram, Slack, ServiceNow или PagerDuty. Дашборд обеспечивает визуализацию метрик в реальном времени с ролевым доступом — SRE видит live-графики, CTO получает еженедельный SLA-отчёт.
Агентский и безагентный сбор данных
Агентский мониторинг предполагает установку программного агента на каждый хост. Агент собирает расширенные данные — метрики ОС, состояние приложений, журналы — и кэширует их локально при кратковременной потере связи с сервером.
Безагентный подход работает через SSH, SNMP или WMI без установки дополнительного программного обеспечения. Это удобно для сетевых устройств — маршрутизаторов и коммутаторов, — где установка агента невозможна. SNMP в версиях v1, v2c и v3 де-факто стандарт опроса сетевого оборудования. На практике агентский и безагентный мониторинг чаще всего совмещают в одной инсталляции: агенты — на серверах, SNMP — на сетевых устройствах.
AIOps — интеллектуальный мониторинг следующего уровня
Гибридные облака использует 86% крупных предприятий — и это создаёт принципиальную проблему: слишком много разнородных движущихся частей в одной среде. Классический мониторинг ИТ-инфраструктуры при этом генерирует тысячи алертов в сутки, большинство из которых — дубли или несущественные события. Итог — усталость от оповещений: инженеры начинают игнорировать уведомления, и реальный инцидент остаётся незамеченным.
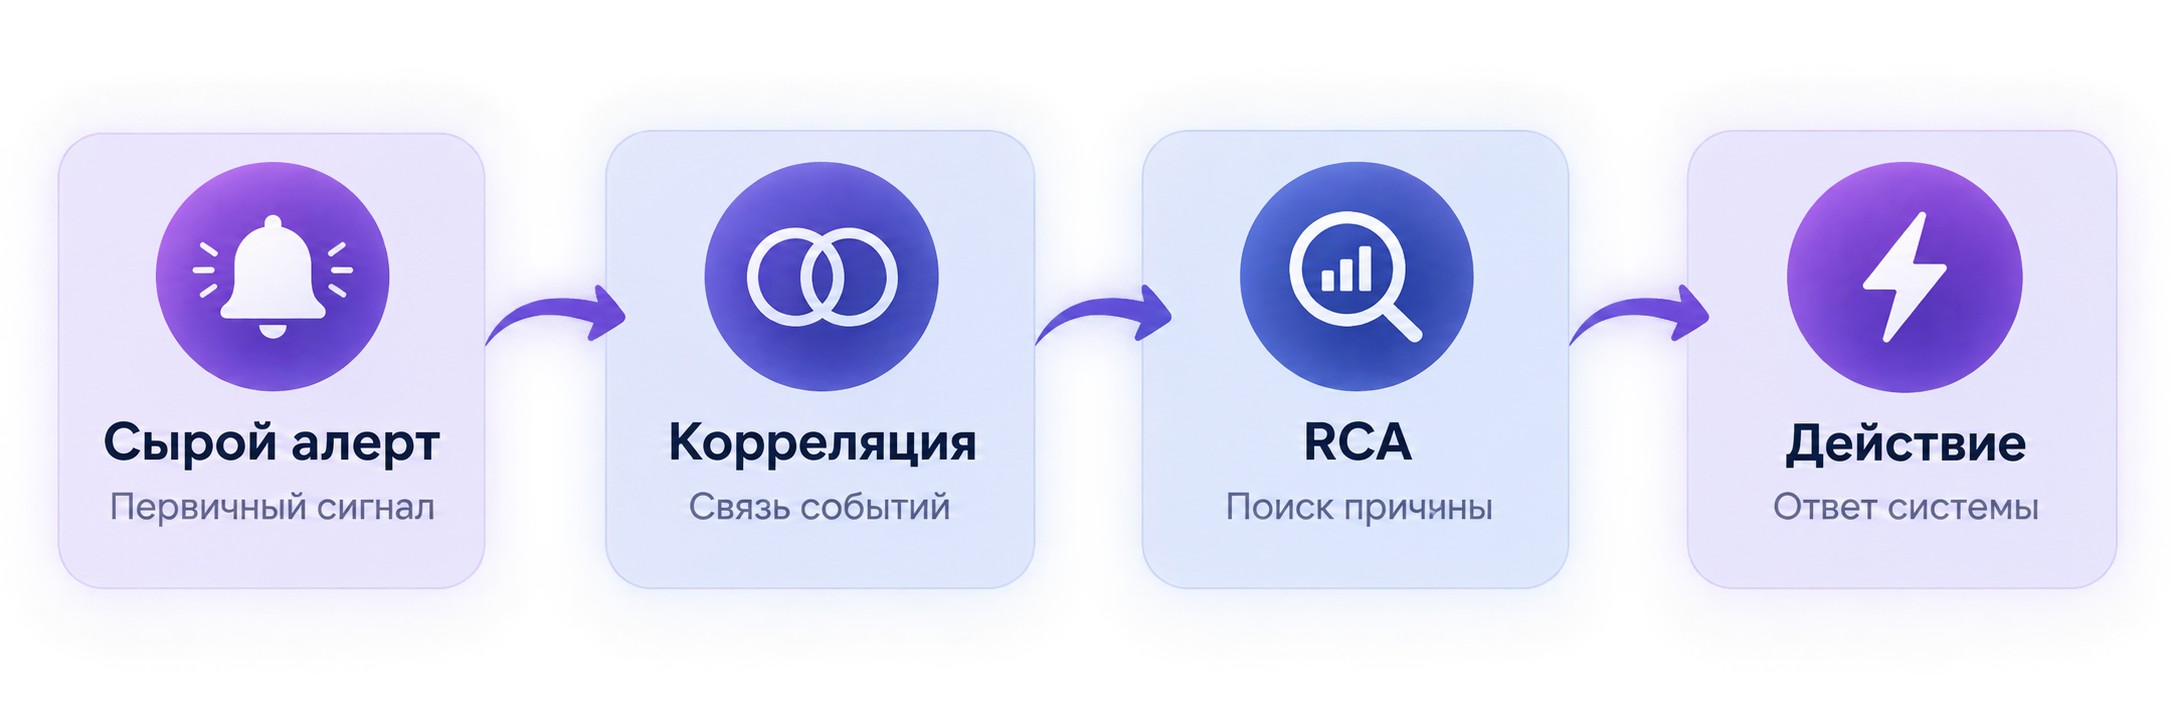
AIOps (управление ИТ-операциями с применением ИИ и машинного обучения, Artificial Intelligence for IT Operations) устраняет эту проблему. Платформа анализирует потоки событий, автоматически коррелирует связанные алерты в один инцидент, определяет первопричину (Root Cause Analysis, RCA) и инициирует автоматическое реагирование.
Алгоритмы прогнозирования — ARIMA и Prophet — выявляют тренды деградации задолго до критического порога: например, рост заполненности диска с линейной экстраполяцией на два дня вперёд. Российская реализация AIOps — платформа Artimate: корреляция событий, автоматический RCA, интеграция с популярными системами мониторинга. Числовые результаты внедрения: снижение шума алертов на 95%, сокращение MTTR с часов до минут, целевой uptime — 99,9999%.
Как внедрить мониторинг ИТ-инфраструктуры: пошаговый план
Внедрение системы мониторинга ИТ-инфраструктуры проходит в пять последовательных шагов.
Шаг 1. Определить приоритетные бизнес-процессы и ИТ-узлы, от которых они зависят. Начинать стоит с наиболее критичных сервисов, а не пытаться покрыть весь стек сразу.
Шаг 2. Выбрать инструмент по матрице «масштаб × зрелость команды × бюджет»: Zabbix — для on-premise, Prometheus — для облака, российские ПАК — при требованиях импортозамещения.
Шаг 3. Настроить метрики, пороговые значения и каналы алертинга с чёткой эскалационной цепочкой и уровнями серьёзности.
Шаг 4. Организовать центр мониторинга: закрепить роли NOC/SRE, выстроить смены и процедуры эскалации инцидентов.
Шаг 5. Регулярно оценивать эффективность — MTTR, долю ложных срабатываний, охват автоматических алертов. При масштабировании подключить CMDB (базу данных управления конфигурациями, Configuration Management Database) для авторегистрации новых объектов без ручной настройки каждого узла.
Zabbix 7 — где изучить и как скачать материалы
Книга «Zabbix 7. Мониторинг ИТ-инфраструктуры» Брайана ван Тондера (Brian van Tonder) издана Packt Publishing и охватывает установку, конфигурацию, шаблоны и масштабирование платформы. Легальные форматы — PDF, ebook и печатная версия — доступны на официальном сайте издательства и платформе O’Reilly. Официальная документация Zabbix 7 бесплатно размещена на docs.zabbix.com — актуальный справочник по всем версиям платформы с примерами конфигураций. Скачивать книгу с неофициальных ресурсов не стоит: нелегальные копии зачастую содержат устаревший контент или нарушают авторские права.
Часто задаваемые вопросы
Что такое мониторинг ИТ-инфраструктуры?
Мониторинг ИТ-инфраструктуры — непрерывный процесс сбора, обработки и анализа метрик серверов, сетей, виртуальных машин, баз данных, приложений и облачных сервисов. Система отслеживает работоспособность среды в реальном времени и генерирует алерты при отклонениях — до того, как инцидент затронет пользователей.
Чем мониторинг отличается от наблюдаемости?
Мониторинг фиксирует «что сломалось» — отклонение метрики от порогового значения. Наблюдаемость отвечает на вопрос «почему это произошло» и объединяет метрики, логи и трассировки. Наблюдаемость шире мониторинга: она основа для анализа первопричин (RCA) и предиктивной диагностики.
Какие инструменты мониторинга наиболее распространены?
Чаще всего применяют Zabbix (универсальный, on-premise, агентский и безагентный), Prometheus (cloud-native, pull-модель, PromQL) и Grafana (визуализация поверх любых источников данных). В России востребованы КМУТ, wiSLA, «Пульт» (на базе Zabbix) и AIOps-платформа Artimate.
Что такое AIOps и зачем он нужен?
AIOps объединяет ИИ, машинное обучение и автоматизацию для управления ИТ-операциями. Платформа анализирует миллионы событий, коррелирует алерты, определяет первопричины и прогнозирует сбои. Результат: снижение шума оповещений на 95%, MTTR сокращается с часов до минут, uptime достигает 99,9999%.
Какие метрики наиболее важны в мониторинге ИТ?
Четыре базовые группы: доступность (uptime — цель 99,99%+), задержка (latency, p95/p99), процент ошибок (error rate) и загрузка ресурсов (CPU, RAM, диск, сеть). MTTR — ключевой KPI всей системы мониторинга. Пороговые значения пересматриваются при каждом существенном изменении инфраструктуры.
Как снизить Alert Fatigue?
Alert Fatigue (усталость от оповещений) возникает при избытке несущественных алертов. Решения: дедупликация и группировка событий в один инцидент, настройка уровней серьёзности (warning/critical), подавление повторяющихся уведомлений, использование AIOps-корреляции — Artimate снижает шум на 95%. Качественный алертинг предполагает маршрутизацию через Telegram, Slack или PagerDuty с чёткой цепочкой эскалации.
Чем Prometheus отличается от Zabbix?
Zabbix — универсальная on-premise платформа с агентской и безагентной схемами, сильная в мониторинге серверов и сетевого оборудования через SNMP. Prometheus ориентирован на cloud-native среды: pull-модель, PromQL, нативная интеграция с Kubernetes. Grafana используется как слой визуализации для обоих. Выбор определяется типом инфраструктуры и компетенциями команды.
Где легально скачать книгу по Zabbix 7?
Книга «Zabbix 7. Мониторинг ИТ-инфраструктуры» Брайана ван Тондера (Brian van Tonder) издана Packt Publishing. Легальные форматы — PDF, ebook, печатная версия — доступны на packtpub.com и O’Reilly. Официальная документация Zabbix 7 бесплатно размещена на docs.zabbix.com — актуальный справочник по установке, конфигурации и шаблонам.
Что такое КМУТ в мониторинге ИТ?
КМУТ — российский аппаратно-программный комплекс для мониторинга качества услуг связи и состояния ИТ-инфраструктуры. Использует зондовую архитектуру, поддерживает UML и широкие API-интеграции. Ключевое преимущество — метрологически-валидированные результаты измерений, юридически значимые для операторов связи.
Как масштабировать систему мониторинга при росте инфраструктуры?
Стандартные подходы: стандартизированные шаблоны вместо ручной настройки каждого узла, интеграция с CMDB для авторегистрации новых объектов, сегментация через прокси-ноды (Zabbix) или федерация через Thanos/Cortex (Prometheus). AIOps-корреляция позволяет управлять тысячами алертов без пропорционального роста команды.
Подайте заявку —
забронируйте место в группе
45 000 мест на 2026 год. Бесплатное обучение по федеральному проекту «Активные меры содействия занятости»
- Онлайн
- От 2 месяцев
- Бесплатно
- Диплом