Топ-10 книг по анализу данных: от статистики без формул до Python и Big Data
Для старта подойдут «Голая статистика» Чарльза Уилана — статистика без единой формулы — и «Data Science. Наука о данных с нуля» Джоэла Граса с базовыми алгоритмами на Python. Для практической работы — «Python и анализ данных» Уэса Маккинни, создателя библиотеки Pandas. Ниже — полная подборка из 10 позиций с уровнями, кейсами и дорожной картой чтения.
Книги дают то, чего не дают курсы: концептуальную базу, не привязанную к версиям инструментов. Понимание причинно-следственных связей не устаревает при смене Python 3.9 на 3.12. Подборка охватывает статистику, Python-экосистему, науку о данных (data science), большие данные (Big Data), визуализацию и причинность — чтобы читатель любого уровня нашёл точку входа. В конце — навигационная таблица и дорожная карта для джунов, мидлов и сеньоров.
Учитесь бесплатно за счёт государства
Экономия до 100 000 ₽ на любой программе
Быстрое сравнение: все позиции подборки
Уровни: ⭐ — начинающий, ⭐⭐ — средний, ⭐⭐⭐ — продвинутый. Колонка «Без математики» означает: книга написана без формул и уравнений.
| # |
Название |
Уровень |
Инструменты |
Без математики |
Кому |
|---|---|---|---|---|---|
| 1 | Курс «Специалист по аналитике» — АМСЗ | ⭐ | SQL, BI | — | Работающим специалистам |
| 2 | «Голая статистика» — Уилан | ⭐ | — | ✓ | Джун |
| 3 | «Статистика для всех» — Бослаф | ⭐ | — | ✓ | Джун |
| 4 | «Статистика и котики» — Савельев | ⭐ | — | ✓ | Джун |
| 5 | «Data Science с нуля» — Грас | ⭐⭐ | Python | частично | Джун с Python |
| 6 | «Python и анализ данных» — Маккинни | ⭐⭐ | NumPy, Pandas, Matplotlib | — | Мидл |
| 7 | «Данные: визуализируй…» — Нафлик | ⭐⭐ | — | ✓ | Мидл, PM |
| 8 | «Все лгут» — Стивенс-Давидовиц | ⭐⭐ | — | ✓ | Мидл |
| 9 | «Почему. Руководство…» — Клейнберг | ⭐⭐⭐ | Байесовские сети | — | Сеньор |
| 10 | «Искусство статистики» — Шпигельхалтер | ⭐⭐ | PPDAC | частично | Мидл, Сеньор |
По каким критериям отбирались книги
Чтобы попасть в список лучших книг по анализу данных, позиция должна была соответствовать четырём условиям. Первое: книга упомянута минимум у двух из трёх ведущих EdTech-платформ — Skillbox, Skillfactory или Яндекс Практикум. Второе: содержит конкретный кейс или практические задания, а не только теорию. Третье: актуальна в 2026 году — либо вышло обновлённое издание, либо концепции не устаревают при смене версий инструментов. Четвёртое: покрывает ключевые навыки аналитика данных — понимание данных (data literacy), Python, причинность, визуализация данных.
№1. Курс «Специалист по аналитике и базам данных в информационных системах» — АМСЗ
Единственная позиция в подборке с официальным документом — удостоверением о повышении квалификации государственного образца. Курс реализует Томский государственный университет в рамках нацпроекта «Кадры». Участие полностью бесплатно: финансирование государственное.
Программа рассчитана на 72 часа в онлайн-формате, занятия 1–2 раза в неделю — без отрыва от работы. Зарплата выпускников — от 70 000 ₽. Старт потока — июль 2026. Посмотреть программу и занять место можно в каталоге программ АМСЗ.
Дифференциатор: книги дают знания, курс — и знания, и подтверждение квалификации. Кому подходит: работающим специалистам без базы в анализе данных, которые хотят войти в профессию с документом.
№2. «Голая статистика» — Чарльз Уилан
Лучшая книга по анализу данных для тех, кто боится цифр. Без единой формулы — только примеры из политики, маркетинга и науки. Уилан объясняет корреляцию, центральную предельную теорему, регрессию и теорию вероятностей через бытовые истории.
Кейс из книги: загадка Монти Холла. Математика доказывает, что менять первоначальный выбор двери выгоднее — вероятность вырастает с 1/3 до 2/3. Интуиция сопротивляется, статистика настаивает. Это и есть её ценность: она противоречит ощущениям и именно поэтому полезна. Читать вместе с: «Статистика для всех» Бослаф — там те же концепции с практическими методами.
№3. «Статистика для всех» — Сара Бослаф
Следующий шаг после Уилана — методы, которые Бослаф объясняет без требования математического образования. Книга охватывает темы, редкие в стандартных вводных курсах: опосредованное измерение, дисперсионный анализ, множественная регрессия.
Кейс: как полицейский оценивает состояние опьянения без анализа крови — через косвенные показатели. Классический пример статистического вывода по наблюдениям вместо прямого измерения. Методы: t-тест, хи-квадрат, регрессионный анализ, корреляция. Следующий шаг: «Python и анализ данных» Маккинни — реализовать то же самое в коде.
№4. «Статистика и котики» — Владимир Савельев
Единственная оригинальная русскоязычная книга в подборке. Савельев объясняет дисперсию и стандартное отклонение через юмор и — да, котиков. Академизм намеренно сведён к нулю, визуализация данных сопровождает каждую концепцию.
Темы: t-критерий Стьюдента, U-критерий Манна-Уитни, стандартное отклонение. Кому особенно подойдёт: студентам без математической базы и всем, кто открыл аннотацию к «серьёзным» учебникам и закрыл вкладку. После Савельева «страшные» статистические термины перестают пугать.
№5. «Data Science. Наука о данных с нуля» — Джоэл Грас
Для тех, кто хочет понять машинное обучение изнутри, а не просто вызывать fit() и predict(). Грас реализует алгоритмы без готовых библиотек — с нуля, с объяснением математики за каждым шагом. Требует базового Python.
Кейс: спам-фильтр на теореме Байеса собирается с нуля, без sklearn. Это не академическое упражнение — именно такие навыки нужны при отладке модели в реальном проекте. Методы: логистическая регрессия, деревья решений, кластеризация, обработка естественного языка (NLP), нейросети, этика данных. Читать после: «Python и анализ данных» Маккинни — практическая экосистема для тех, кто уже понял алгоритмы.
№6. «Python и анализ данных» — Уэс Маккинни
Книгу написал создатель Pandas — и это меняет уровень детализации. Маккинни объясняет не «как пользоваться инструментом», а «как он устроен». Второе издание переписано под Python 3.x и остаётся актуальным в 2026 году.
Кейс: подсчёт часовых поясов в JSON-файле через DataFrame и value_counts() занимает 2 строки вместо функции с циклами на чистом Python. Инструменты: NumPy (векторные операции), Pandas (работа с таблицами данных), Matplotlib (графики), IPython (интерактивная среда). Уровень ⭐⭐ — нужен базовый Python, глубокий опыт не обязателен.
№7. «Данные: визуализируй, расскажи, используй» — Коул Нассбаумер Нафлик
Предыдущие книги учат считать и программировать. Нафлик учит убеждать. Визуализация данных — это не красивые графики, а инструмент принятия решений.
Кейс: ИТ-отдел перегрузил слайд данными по заявкам. Нафлик показывает, как та же информация превращается в линейный график с одним призывом: «Просим одобрить двух сотрудников». Данные не изменились — изменился сторителлинг с данными. Шесть уроков: контекст → правильная визуализация → устранение лишнего → управление вниманием → дизайн → история. Подходит аналитикам, менеджерам продуктов и руководителям, которые регулярно защищают результаты перед аудиторией.
№8. «Все лгут. Поисковики, Big Data и Интернет знают о вас всё» — Сет Стивенс-Давидовиц
Книга на стыке поведенческой аналитики и социологии — редкий жанр в русскоязычном EdTech. Стивенс-Давидовиц (NYT, WSJ, Wired) показывает: большие данные обнаруживают паттерны, невидимые традиционным опросам.
Кейс: карта расизма США по поисковым запросам предсказала электоральную базу Трампа за год до выборов, хотя официальные социологические опросы этого не фиксировали. Вывод: люди лгут социологам, но не поисковикам. Навыки после книги: прогнозирование по Big Data, выявление закономерностей, критическое отношение к опросным данным. Дополнение: «Как лгать при помощи статистики» Даррелла Хаффа.
Хотите сменить профессию или повысить квалификацию?
Федеральный проект «Активные меры содействия занятости» даёт возможность пройти обучение бесплатно за счёт государства
- Программы от ведущих вузов России — от 2 месяцев
- Удостоверение или диплом установленного образца
- Центр карьеры: 7 500+ вакансий, помощь с трудоустройством
№9. «Почему. Руководство по поиску причин и принятию решений» — Саманта Клейнберг
Одна из немногих книг о причинности — и при этом доступная. Клейнберг разбирает главную ловушку аналитика: путать корреляцию с причинно-следственными связями.
Кейс: дело Салли Кларк. Эксперт перемножил вероятность двух смертей младенцев как независимые события — хотя они зависимые. Ошибка стоила невиновной женщине трёх лет тюрьмы. Методы: байесовские сети, контролируемые эксперименты, четыре вида причинности. Читать до: «Голая статистика» Уилана — как подготовительный шаг. Уровень ⭐⭐⭐ — требует понимания базовой статистики.
№10. «Искусство статистики» — Дэвид Шпигельхалтер
Профессор Кембриджа показывает статистику не как набор формул, а как инструмент решения реальных задач. Ключевой результат чтения — развитие понимания данных (data literacy): навыка критически работать с любой цифрой.
Кейс: дело «Доктора Смерть» — Гарольд Шипман убил более 200 пациентов. Статистический анализ избыточной смертности мог выявить его на 10–15 лет раньше, если бы проводился регулярно. Метод книги — цикл PPDAC: Проблема → План → Данные → Анализ → Выводы (Problem → Plan → Data → Analysis → Conclusions). Системное мышление через статистику.
Как выбрать книгу по анализу данных под свою задачу
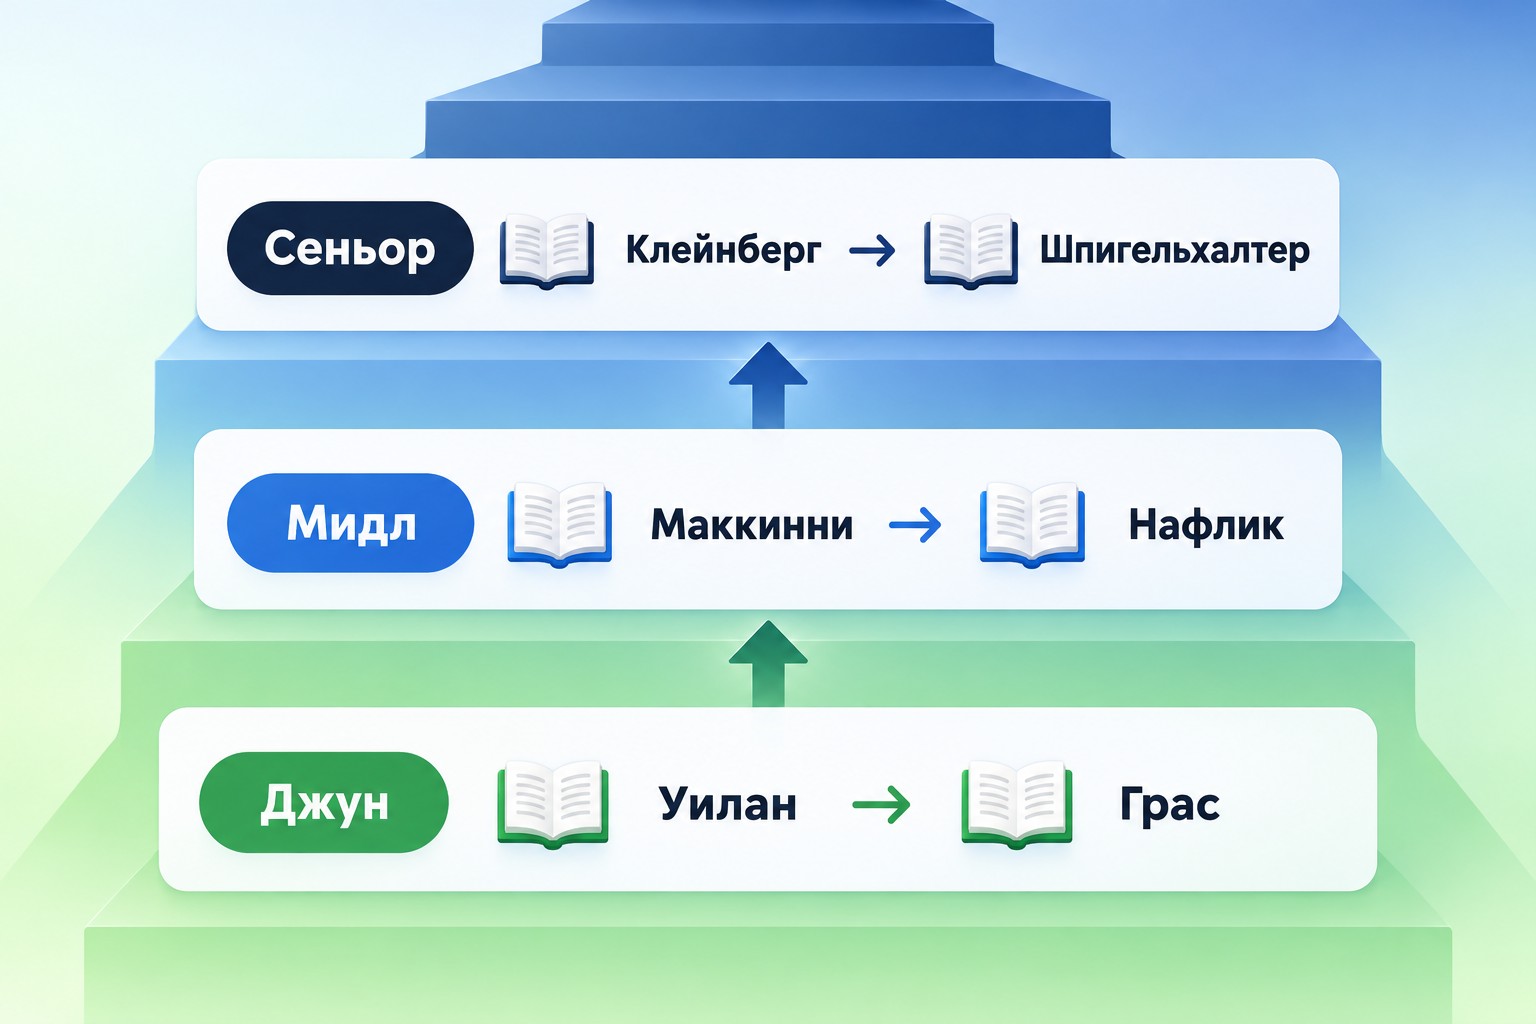
Три вопроса помогут определиться: (1) Какой ваш уровень прямо сейчас? (2) Нужна ли практика с кодом? (3) Комфортно ли работать с формулами? Дорожная карта: джун-аналитик начинает с «Голой статистики» (Уилан) → «Data Science с нуля» (Грас) — от интуитивного понимания статистики к алгоритмам. Мидл: «Python и анализ данных» (Маккинни) + «Данные: визуализируй, расскажи, используй» (Нафлик) — инструменты и презентация результатов. Сеньор-аналитику закрывают пробелы «Почему. Руководство…» (Клейнберг) и «Искусство статистики» (Шпигельхалтер).
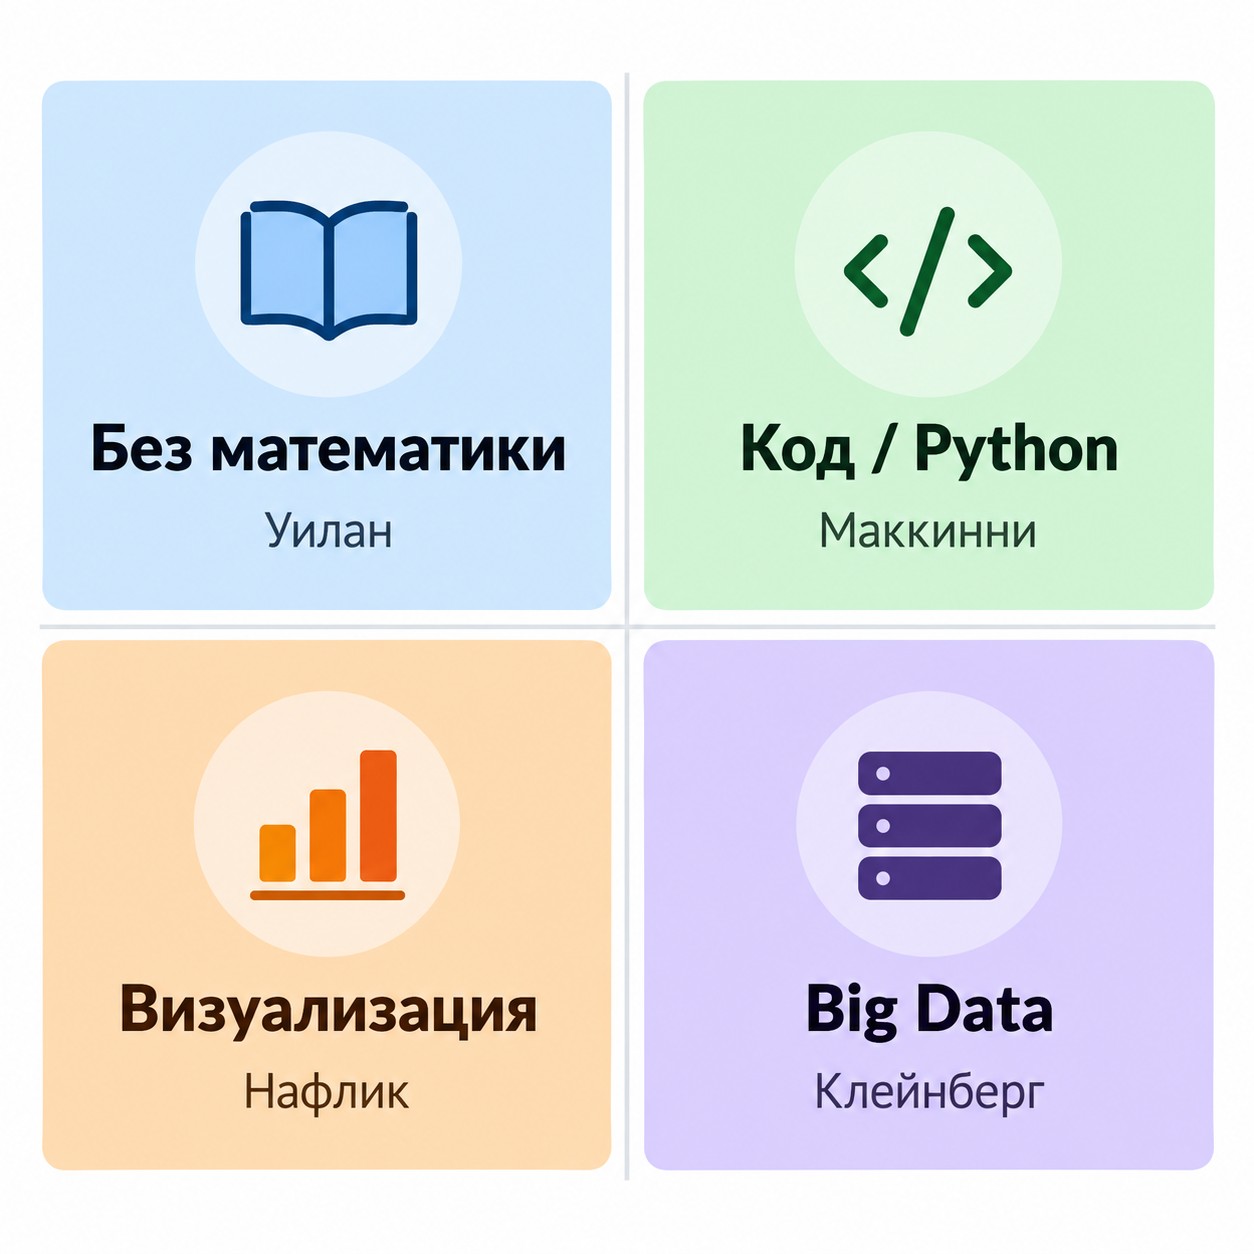
Матрица «Цель → Книга» в четырёх ячейках: понять статистику без страха — Уилан или Савельев; освоить Python для анализа данных — Маккинни плюс Грас; Big Data и поведение — Стивенс-Давидовиц; причинность и принятие решений — Клейнберг. Лучшие книги по анализу данных не конкурируют — они дополняют друг друга. Читать параллельно с практикой эффективнее, чем последовательно проходить одну за другой.
Часто задаваемые вопросы
С какой книги начать изучение анализа данных полному новичку?
«Голая статистика» Чарльза Уилана — корреляция, вероятность и регрессия без единой формулы, через бытовые примеры. Для русскоязычной подачи с юмором — «Статистика и котики» Владимира Савельева. Обе рассчитаны на читателя без математического образования.
Какую книгу по Python выбрать для анализа данных?
«Python и анализ данных» Уэса Маккинни — написана создателем библиотеки Pandas. Охватывает NumPy, Pandas, Matplotlib и IPython с практическими заданиями. Требует базового Python. Читайте параллельно с «Data Science с нуля» Граса — для понимания алгоритмов изнутри.
Нужна ли математика для чтения книг по анализу данных?
Нет — если начинать с «Голой статистики» (Уилан) или «Статистики и котиков» (Савельев): ни формул, ни уравнений. Для «Data Science с нуля» (Грас) и «Почему. Руководство…» (Клейнберг) хватит уровня школьной математики.
Есть ли книги по анализу данных на русском языке?
Оригинальная русскоязычная — «Статистика и котики» Владимира Савельева. Переведены на русский: «Голая статистика» (Уилан), «Python и анализ данных» (Маккинни), «Все лгут» (Стивенс-Давидовиц), «Data Science с нуля» (Грас).
В каком порядке читать книги по анализу данных?
Рекомендуем: 1) «Голая статистика» — понять статистику; 2) «Data Science с нуля» — базовые алгоритмы; 3) «Python и анализ данных» — практическая экосистема; 4) «Почему. Руководство…» — причинность и принятие решений. Это маршрут джун → мидл.
Чем отличается анализ данных от data science?
Наука о данных (data science) — более широкая дисциплина: включает машинное обучение, нейросети, обработку естественного языка (NLP). Анализ данных фокусируется на статистике, очистке, визуализации и интерпретации. Большинство книг подборки органично переводят от одного направления к другому.
Какие книги по анализу данных актуальны в 2026 году?
«Python и анализ данных» обновлён под Python 3.x. «Data Science с нуля» охватывает свежие тренды. «Искусство статистики» (Шпигельхалтер) и «Почему. Руководство…» (Клейнберг) — фундаментальные концепции, не устаревающие при смене версий инструментов.
Можно ли обойтись без книг и сразу пройти курс?
Да — курс «Специалист по аналитике и базам данных в информационных системах» по нацпроекту «Кадры» бесплатен и выдаёт официальное удостоверение о повышении квалификации. Книги стоит читать параллельно: они дают концептуальную глубину, которую курс сжимает в 72 часа.
Есть ли книги по визуализации данных?
«Данные: визуализируй, расскажи, используй» Коул Нассбаумер Нафлик — лучшая книга по сторителлингу с данными в этой подборке. Шесть уроков превращения цифр в убедительную историю с призывом к действию. Подходит аналитикам, менеджерам продуктов и всем, кто регулярно защищает результаты перед аудиторией.
Что читать аналитику данных для перехода на уровень мидл?
Три книги закрывают ключевые пробелы: «Python и анализ данных» (Маккинни) — инструменты; «Данные: визуализируй, расскажи, используй» (Нафлик) — презентация результатов; «Почему. Руководство…» (Клейнберг) — понимание причинности без типичных ошибок в рассуждениях.
Подайте заявку —
забронируйте место в группе
45 000 мест на 2026 год. Бесплатное обучение по федеральному проекту «Активные меры содействия занятости»
- Онлайн
- От 2 месяцев
- Бесплатно
- Диплом