Что такое управление проблемами в ITIL: процесс, этапы и польза для бизнеса
Управление проблемами в ITIL — практика выявления корневых причин ИТ-инцидентов и управления обходными путями, чтобы инциденты не повторялись. В ITIL 4 (IT Infrastructure Library от Axelos) «проблема» — это отдельная сущность: причина одного или нескольких инцидентов, а не сам инцидент. По оценкам аналитиков Gartner, час незапланированного простоя ИТ-систем обходится компании более чем в $300 000 — именно поэтому управление проблемами даёт наивысший возврат инвестиций среди всех практик ITIL. Ниже разберём шесть этапов жизненного цикла проблемы, инструменты анализа корневых причин, структуру базы KEDB и связь практики с остальными процессами сервис-менеджмента.
Что такое управление проблемами в ITIL
Официальная цель практики в ITIL 4 — снижение вероятности инцидентов и их влияния путём выявления фактических и потенциальных причин. Библиотека ITIL издаётся Axelos — организацией, которая сопровождает стандарт более 30 лет. Текущая версия, ITIL 4, заменила процессный подход на практики и встроила их в ценностную цепочку сервиса.
Учитесь бесплатно за счёт государства
Экономия до 100 000 ₽ на любой программе
Управление проблемами — не разовая акция после крупного сбоя, а постоянный кросс-командный процесс: в нём участвуют ИТ-операции, безопасность и разработка. Существует два подхода: реактивный — расследование после случившегося инцидента, и проактивный — выявление потенциальных проблем до того, как они спровоцируют сбой. Около двух третей ИТ-организаций занимаются управлением проблем, но на практике чаще ограничиваются разбором только крупных инцидентов, оставляя систематическую работу на потом.
Проблема, инцидент и запрос на обслуживание: три разных понятия
Инцидент — незапланированное прерывание ИТ-услуги или снижение её качества. Проблема — причина, стоящая за одним или несколькими инцидентами; это отдельная сущность с собственным жизненным циклом. До выхода ITIL V3 в 2007 году инциденты и запросы на обслуживание не разграничивались. Сегодня запрос на обслуживание — официальное обращение пользователя: сброс пароля, установка программного обеспечения, подключение нового сотрудника.
| Параметр |
Управление инцидентами |
Управление проблемами |
|---|---|---|
| Цель | Восстановить сервис | Устранить корневую причину |
| Горизонт | Минуты — часы | Дни — недели |
| Команда | Дежурная смена поддержки | Аналитики, разработчики, ИТ-безопасность |
| Аналогия | Тушение пожара | Расследование причины возгорания |
| Результат | Сервис восстановлен | Причина устранена или задокументирована |
Жизненный цикл проблемы по ITIL: шесть этапов
Жизненный цикл проблемы нелинеен: запись переходит между состояниями по мере поступления новых данных. Один и тот же объект может вернуться на этап диагностики, если первоначальная гипотеза о корневой причине не подтвердилась.
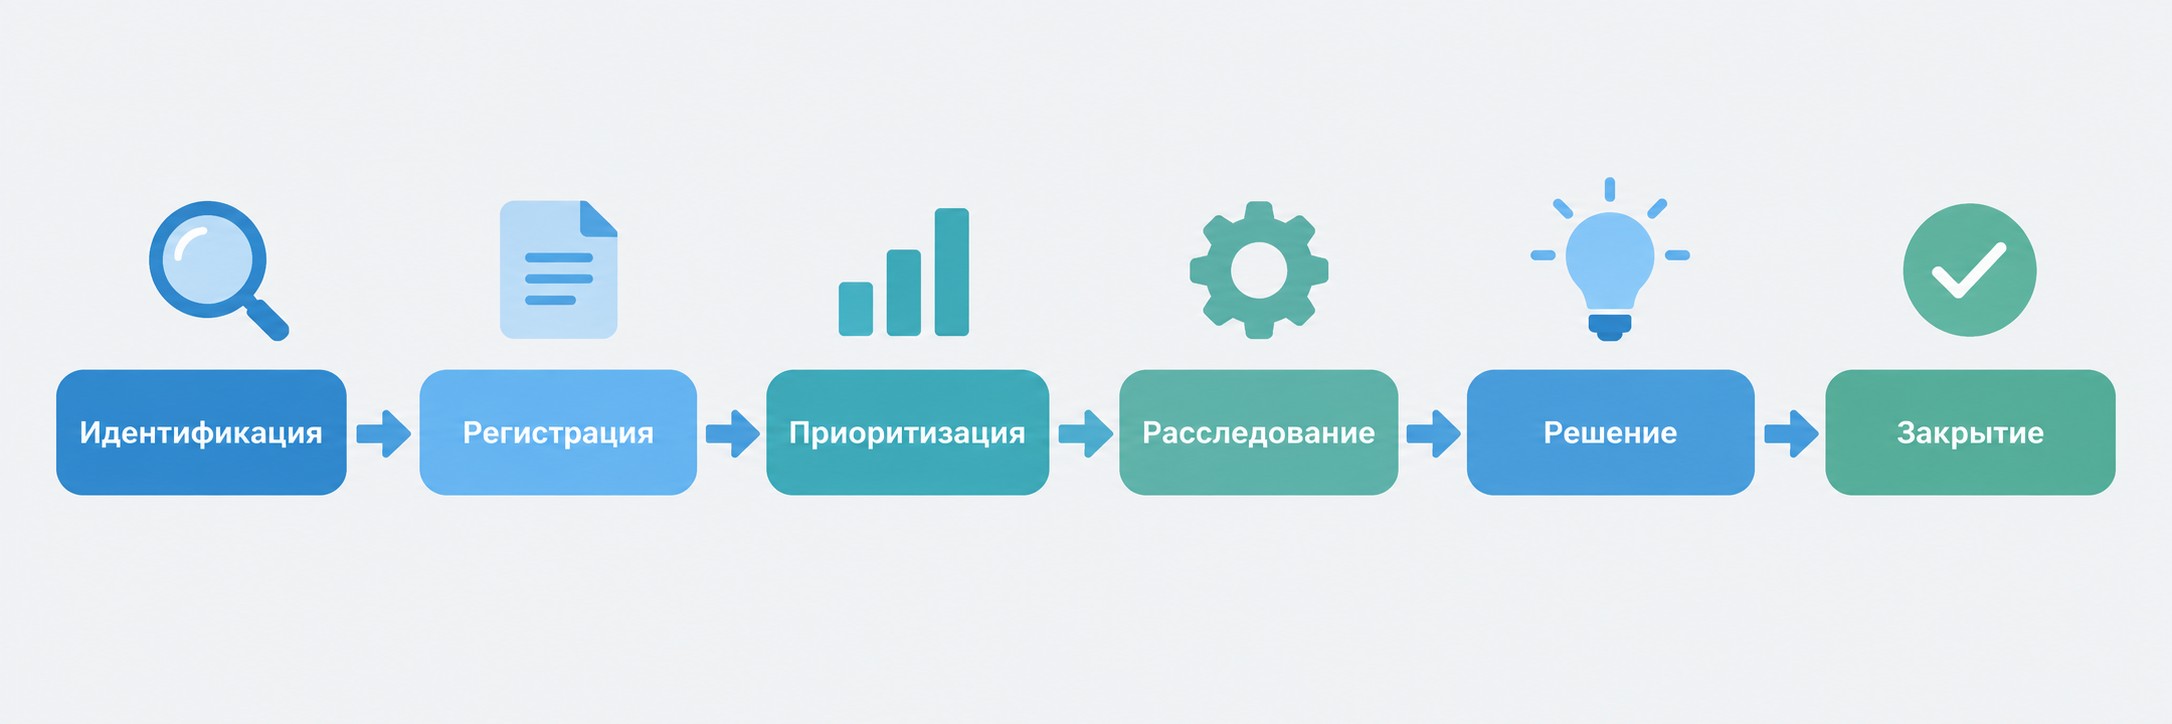
Два подпроцесса составляют основу цикла. Контроль проблем ведёт запись от идентификации к статусу «известная ошибка». Контроль ошибок управляет ею дальше: формирует запрос на изменение (RFC) или фиксирует открытый статус при отсутствии решения.
Три возможных исхода процесса управления проблемой
Жизненный цикл завершается одним из трёх сценариев. Исходы не взаимоисключающие: обходной путь может существовать параллельно ожиданию исправления через управление изменениями.
| Исход |
Описание |
Следующий шаг |
|---|---|---|
| RFC | Корневая причина найдена, нужно изменение инфраструктуры | Передача в управление изменениями |
| Известная ошибка + обходной путь (workaround) | Причина найдена, исправление отложено | Запись в KEDB, мониторинг |
| Открытая проблема | Причина не установлена | Запись в бэклог, расследование продолжается |
Обходной путь — временная мера: снижает влияние проблемы на бизнес, но не устраняет корневую причину.
Как расследовать причины: анализ корневых причин
Анализ корневых причин (RCA, Root Cause Analysis) исходит из принципа: за любым инцидентом стоит совокупность способствующих факторов, а не одна-единственная точка отказа. Искать «виноватого» значит упустить системные уязвимости. Именно поэтому ITIL 4 рекомендует проводить разборы инцидентов без поиска виновных (blameless postmortem): специалисты описывают события честно, без страха наказания — это повышает качество расследования.
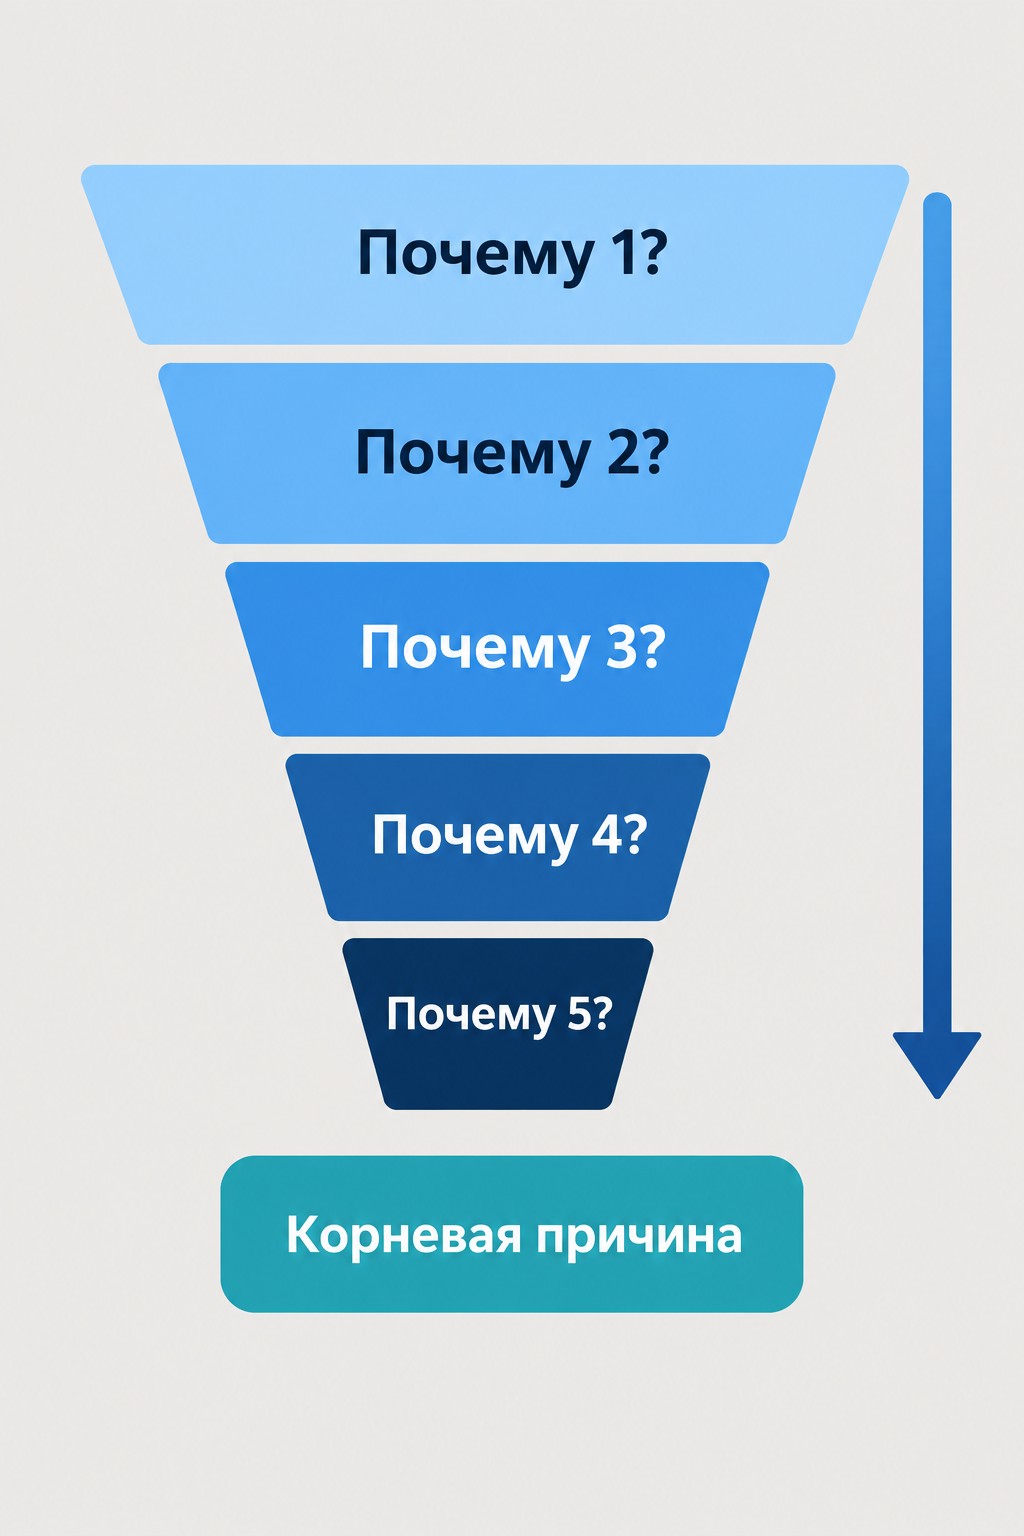
Основные инструменты RCA: метод пяти «почему», диаграмма Исикавы (причинно-следственная диаграмма «рыбьей кости») для многофакторных инцидентов и анализ временной шкалы событий. Выбор инструмента зависит от сложности: простой сбой разбирают через пять «почему», а инциденты с несколькими ветками причин требуют диаграммы Исикавы.
Для тех, кто хочет освоить работу с ITSM-практиками системно, в рамках нацпроекта «Кадры» доступна программа «Специалист по информационным системам: от организации до сопровождения ИТ-проектов» — 144 часа, бесплатно. Выпускники находят работу с доходом от 100 000 ₽. Подробности — в каталоге программ обучения.
Метод пяти «почему» — наследие производственной системы Toyota
Метод разработал Тайити Оно — создатель производственной системы Toyota. Принцип прост: пять последовательных вопросов «Почему?» снимают слои симптомов и добираются до корневой причины.
Пример: сервер упал в 03:00. Почему? — Переполнен диск. Почему? — Логи не ротировались. Почему? — Срок настройки ротации пропущен. Почему? — Задача не вошла в спринт. Почему? — Отсутствовал процесс приоритизации технического долга. Корневая причина — не «сбой программного обеспечения», а системная проблема планирования.
Для инцидентов с несколькими источниками отказов диаграмма Исикавы позволяет одновременно отобразить несколько ветвей причин и найти точки их пересечения.
Известная ошибка и база данных KEDB
Известная ошибка (Known Error) — проблема с задокументированной корневой причиной и определённым обходным путём. Это официальный статус в ITIL 4: как только диагностика завершена, запись переходит из реестра проблем в базу данных известных ошибок — KEDB (Known Error Database, база данных известных ошибок).
Структура записи в KEDB включает четыре обязательных поля: описание инцидента, установленная причина, обходной путь и статус устранения. База доступна всем группам поддержки — это позволяет сократить время реагирования при повторяющихся инцидентах: специалист первой линии сразу видит готовое решение, не начиная расследование заново.
С архитектурной точки зрения известные ошибки составляют технический долг организации. Устранять их нужно через управление изменениями там, где это практически возможно. Если исправление откладывается, KEDB фиксирует повторяющиеся инциденты и помогает оценить реальную стоимость накопленного долга.
Что даёт управление проблемами бизнесу и ИТ-команде
Хотите сменить профессию или повысить квалификацию?
Федеральный проект «Активные меры содействия занятости» даёт возможность пройти обучение бесплатно за счёт государства
- Программы от ведущих вузов России — от 2 месяцев
- Удостоверение или диплом установленного образца
- Центр карьеры: 7 500+ вакансий, помощь с трудоустройством
По оценкам аналитиков Gartner, час незапланированного простоя ИТ-систем обходится компании более чем в $300 000. Управление проблемами ITIL позволяет сократить частоту таких простоев — а значит, напрямую влияет на финансовые показатели.
Команда перестаёт тратить ресурсы на «тушение пожаров» и переключается на создание ценности. Число крупных инцидентов снижается, вместе с ним падают незапланированные трудозатраты и стоимость ИТ-услуг. Клиенты и бизнес-подразделения получают более стабильный сервис: повторные инциденты, которые раньше воспринимались как норма, исчезают из привычного фона. Это напрямую улучшает показатели соглашений об уровне обслуживания (SLA) и восстанавливает доверие к ИТ-отделу.
Управление проблемами в экосистеме практик ITIL
Управление проблемами ITIL не работает изолированно — эффективная практика требует интеграции с несколькими смежными процессами сервис-менеджмента.
| Практика ITIL |
Роль в управлении проблемами |
|---|---|
| Управление изменениями | Реализует RFC-исправления, сформированные контролем ошибок |
| Управление знаниями | Наполняет и ведёт KEDB, ускоряет реагирование при повторных инцидентах |
| Управление конфигурациями | Предоставляет данные о зависимостях и влиянии для диагностики |
| Управление доступностью | Получает аналитику о причинах простоев для расчёта SLA |
| Управление инцидентами | Служит источником данных для идентификации проблем |
При крупных инцидентах управление проблемами становится отправной точкой расследования: координирует кросс-командную работу и обеспечивает непрерывность ИТ-услуг в долгосрочной перспективе.
Что должна уметь ITSM-система для управления проблемами
Программный инструмент для управления проблемами должен закрывать четыре базовых требования: поддерживать отдельную очередь аналитиков (не смешивать с работой по инцидентам), собирать статистику по повторяющимся инцидентам, позволять кастомизировать формы записей о проблемах и связывать проблемы с инцидентами, RFC и релизами.
Система должна отслеживать полную цепочку: инцидент → проблема → RFC → выпуск исправления. Jira Service Management — один из распространённых инструментов: позволяет связывать инциденты с проблемами, хранить результаты анализа корневых причин и вести постфактум-разбор прямо в карточке проблемы.
Часто задаваемые вопросы
Чем ITSM отличается от ITIL — простыми словами?
ITSM (IT Service Management, управление ИТ-услугами) — подход к управлению ИТ как сервисом для бизнеса. ITIL (IT Infrastructure Library, Axelos) — библиотека лучших практик ITSM, существующая более 30 лет. ITIL 4 — текущая версия с 34 практиками, включая управление проблемами.
Чем реактивное управление проблемами отличается от проактивного?
Реактивное — расследование причин уже случившихся инцидентов. Проактивное — поиск потенциальных проблем до того, как они спровоцируют сбой. Эффективная практика сочетает оба подхода, отдавая приоритет проактивному выявлению.
Какие практики входят в ITIL 4?
ITIL 4 включает 34 практики: управление инцидентами, управление проблемами, управление изменениями, управление знаниями, управление запросами на обслуживание, управление конфигурациями, управление доступностью и другие. Все они образуют единую систему сервис-менеджмента.
В чём разница между ITIL V3 и ITIL 4?
ITIL V3 (2007) строился на процессном подходе и пяти томах. ITIL 4 заменил «процессы» на «практики» и встроил их в ценностную цепочку сервиса. Управление проблемами в ITIL 4 теснее связано с гибкими методологиями разработки (agile) и DevOps (практиками непрерывной интеграции и эксплуатации).
Что такое обходной путь (workaround) в ITIL?
Обходной путь — временная мера, снижающая влияние проблемы, но не устраняющая корневую причину. Применяется, пока организация ожидает внедрения полноценного исправления через управление изменениями. Фиксируется в KEDB вместе с записью об известной ошибке.
Как управление проблемами влияет на SLA?
Снижение числа повторных инцидентов напрямую улучшает показатели SLA. Управление проблемами поставляет аналитику для управления уровнем обслуживания: чем меньше незапланированных простоев — тем выше доступность и надёжнее соблюдение соглашений.
Можно ли закрыть проблему без нахождения корневой причины?
Да. Если причина не установлена, проблема регистрируется как «открытая» — статус фиксируется в бэклоге, информация доступна всем группам поддержки. Расследование продолжается при поступлении новых данных об инцидентах.
Кто в ИТ-компании отвечает за управление проблемами?
Как правило, выделяется отдельная команда аналитиков — не те специалисты, которые разбирают инциденты в режиме реального времени. Разделение ролей позволяет сосредоточиться на глубоком расследовании без давления срока восстановления сервиса.
Подайте заявку —
забронируйте место в группе
45 000 мест на 2026 год. Бесплатное обучение по федеральному проекту «Активные меры содействия занятости»
- Онлайн
- От 2 месяцев
- Бесплатно
- Диплом