Что такое индексы в MySQL: виды, назначение и практическое применение
Индекс в MySQL — структура данных, которая хранит отсортированные копии значений столбцов и указатели на физическое расположение строк. Работает как предметный указатель в книге: вместо того чтобы листать все страницы — сразу открываете нужную. Без индекса СУБД перебирает каждую строку таблицы, что при миллионах записей критически сказывается на скорости. Индексы в MySQL ускоряют SELECT-запросы, но за это платят замедлением операций записи и дополнительным местом на диске. В статье разберём виды индексов, механизм B-дерева, синтаксис CREATE/DROP INDEX, покрывающий индекс и диагностику через EXPLAIN.
Что такое индекс в базе данных
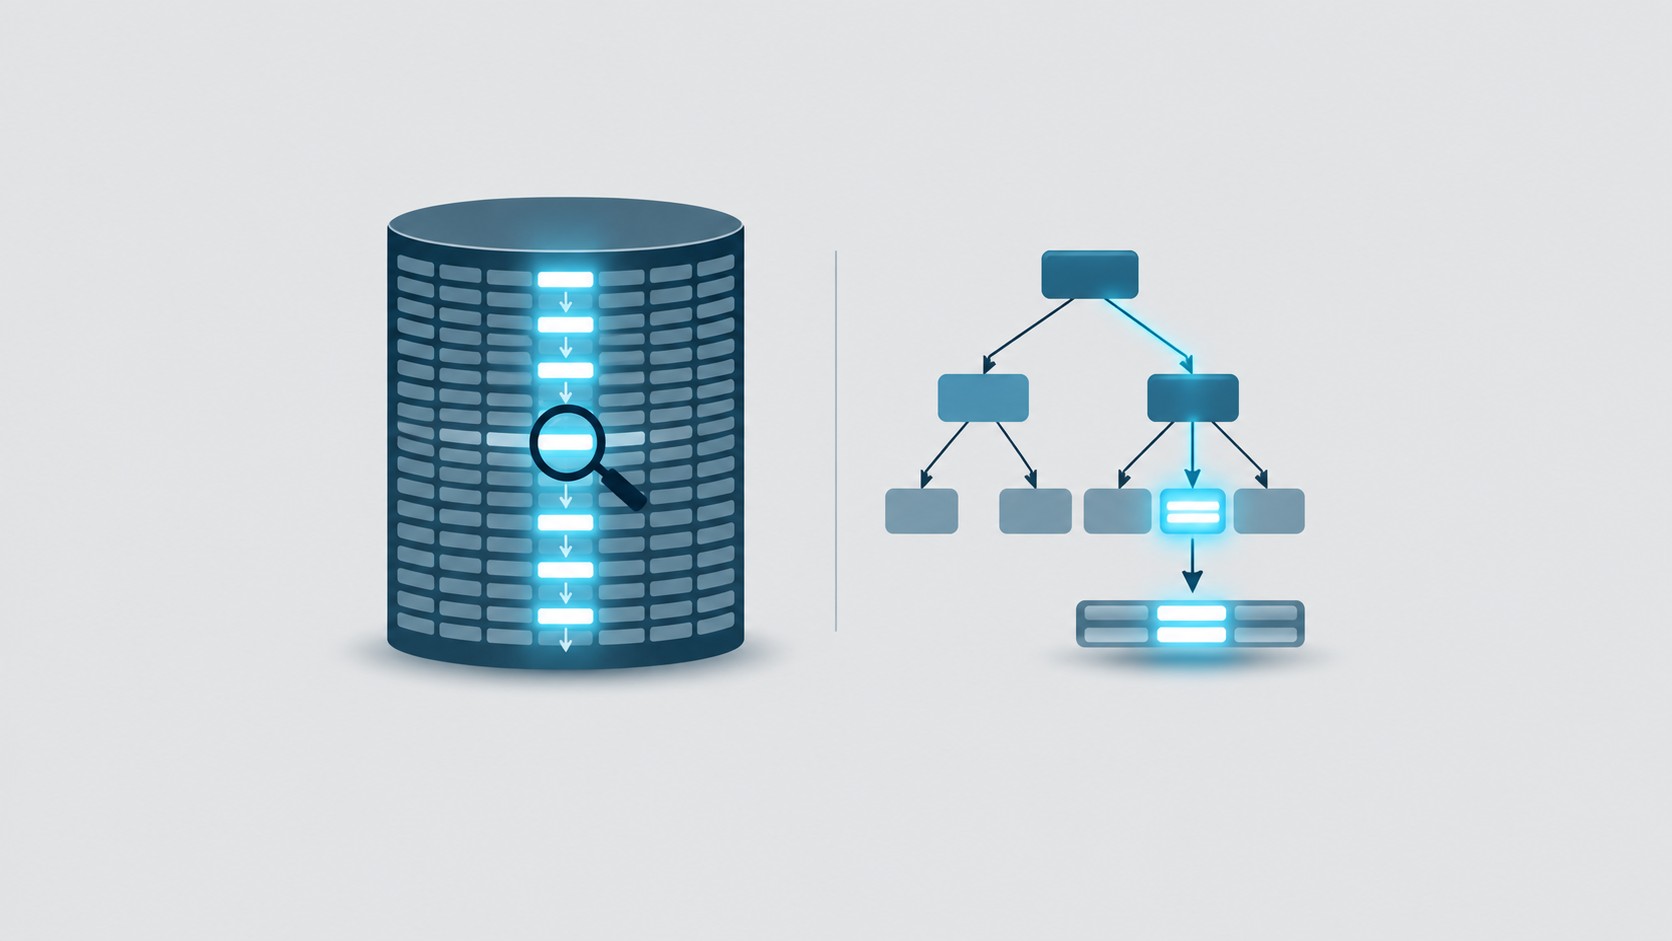
Индексирование баз данных решает одну задачу: как находить нужные строки быстро, не перебирая всё подряд. Индекс в базе данных — специальная структура данных, которую СУБД создаёт и поддерживает рядом с таблицей. Она хранит отсортированные копии значений одного или нескольких столбцов и указатели на физическое расположение соответствующих строк.
Учитесь бесплатно за счёт государства
Экономия до 100 000 ₽ на любой программе
Когда запрос выполняется без индекса, система проводит полное сканирование таблицы (Full Table Scan): проверяет каждую строку от первой до последней и отбирает подходящие. На таблице с тысячей строк — незаметно. На таблице с десятью миллионами — уже ощутимо, а на сотнях миллионов — блокировка или timeout.
Индекс в SQL устраняет эту проблему: оптимизатор обращается к отсортированной структуре, находит нужные строки за O(log n) и уже не перебирает таблицу строка за строкой.
Важно понять, чего индекс не делает: он не меняет данные в таблице, не копирует строки целиком. Это отдельная структура, которая ссылается на оригинальные строки. Поэтому индекс занимает дополнительное дисковое пространство и требует обновления при каждой операции записи.
Хорошая аналогия — алфавитный указатель в адресной книге. Вместо того чтобы листать все страницы в поисках «Смирнова», вы открываете раздел «С» и сразу попадаете на нужную строку. Индекс в таблице базы данных работает так же: хранит упорядоченные ключи и ссылки на строки.
Как работает индекс — механизм B-дерева
Большинство индексов в MySQL построены на основе B-дерева (сбалансированного дерева поиска; англ. B-Tree). Это значение по умолчанию — если при создании не указан другой тип, СУБД создаёт именно его. Разберём внутреннее устройство и принцип работы оптимизатора.
Структура B-дерева и механизм Row ID
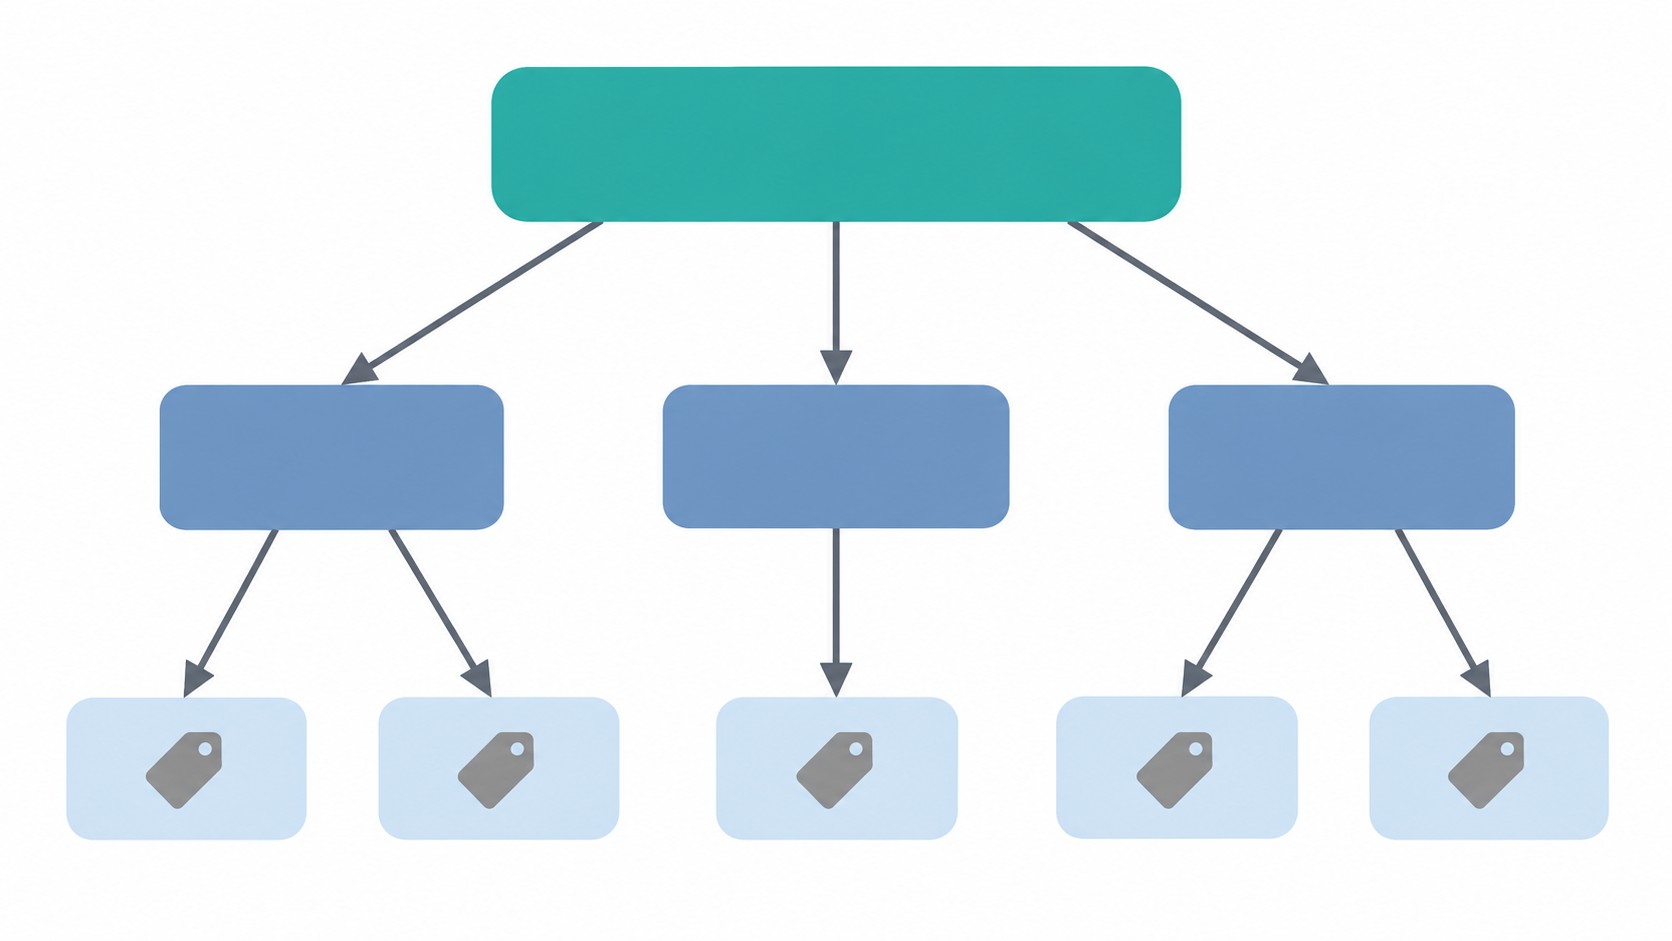
B-дерево состоит из трёх уровней узлов:
- Корень — точка входа; хранит диапазоны значений для перехода на следующий уровень.
- Промежуточные узлы — уточняют диапазон и направляют поиск глубже.
- Листовые узлы — хранят фактические значения индексируемого столбца и Row ID (указатель на физическое расположение строки в таблице).
MySQL использует B+-дерево: листовые узлы связаны в двусвязный список, что позволяет эффективно выполнять диапазонные запросы (BETWEEN, >, <) и сортировку ORDER BY — движение по дереву всегда идёт слева направо.
Поиск занимает O(log n) операций — логарифмическое время от числа записей. Если в таблице миллион строк, для поиска нужно порядка 20 сравнений, а не миллион. Именно это даёт индексу колоссальный выигрыш на больших таблицах.
Как оптимизатор запросов выбирает индекс
Перед выполнением каждого запроса оптимизатор запросов строит план: запрашивает у хранилища статистику — число строк, кардинальность столбцов — перебирает доступные индексы и оценивает cost (условную стоимость каждого варианта).
Важно понимать: план запроса — предположение, а не гарантия. Cost-метрика условна и не учитывает ни кэш буферного пула, ни особенности конкретного железа. Реальное время выполнения может отличаться от прогноза.
При низкой кардинальности — например, столбец «статус» с тремя значениями — оптимизатор нередко предпочитает полное сканирование таблицы. Причина: если индекс всё равно приводит к обходу половины строк, Full Table Scan окажется быстрее. Кардинальность и селективность — ключевые параметры при решении, нужен ли индекс конкретному столбцу.
Типы индексов в MySQL
Индексирование в MySQL реализовано на уровне движков хранилищ, а не стандарта SQL. Доступные типы зависят от конкретного движка — InnoDB, MyISAM и другие поддерживают разные наборы. PostgreSQL предлагает ещё более широкий набор специализированных структур.
Если хотите освоить SQL и работу с базами данных на практике — обучение в рамках нацпроекта «Кадры» даёт такую возможность бесплатно. Смотрите каталог программ обучения.
Индексы MySQL — B-Tree, Hash, Full-text, Spatial
В MySQL доступны четыре основных типа:
| Тип |
Назначение |
Когда использовать |
|---|---|---|
| B-Tree | Сравнения (<, >, BETWEEN), диапазоны, сортировка | Большинство случаев; тип по умолчанию в InnoDB и MyISAM |
| Hash | Только точное равенство (=) | Таблицы MEMORY; в InnoDB создаётся адаптивно, явно не задать |
| Full-text | Поиск слов в текстовых столбцах | Запросы MATCH … AGAINST по VARCHAR/TEXT |
| Spatial | Геоданные: точки, полигоны, линии | ГИС-задачи в MyISAM и InnoDB |
Таблица 1 (часть 1). Типы индексов MySQL. Источник: документация MySQL 8.0.
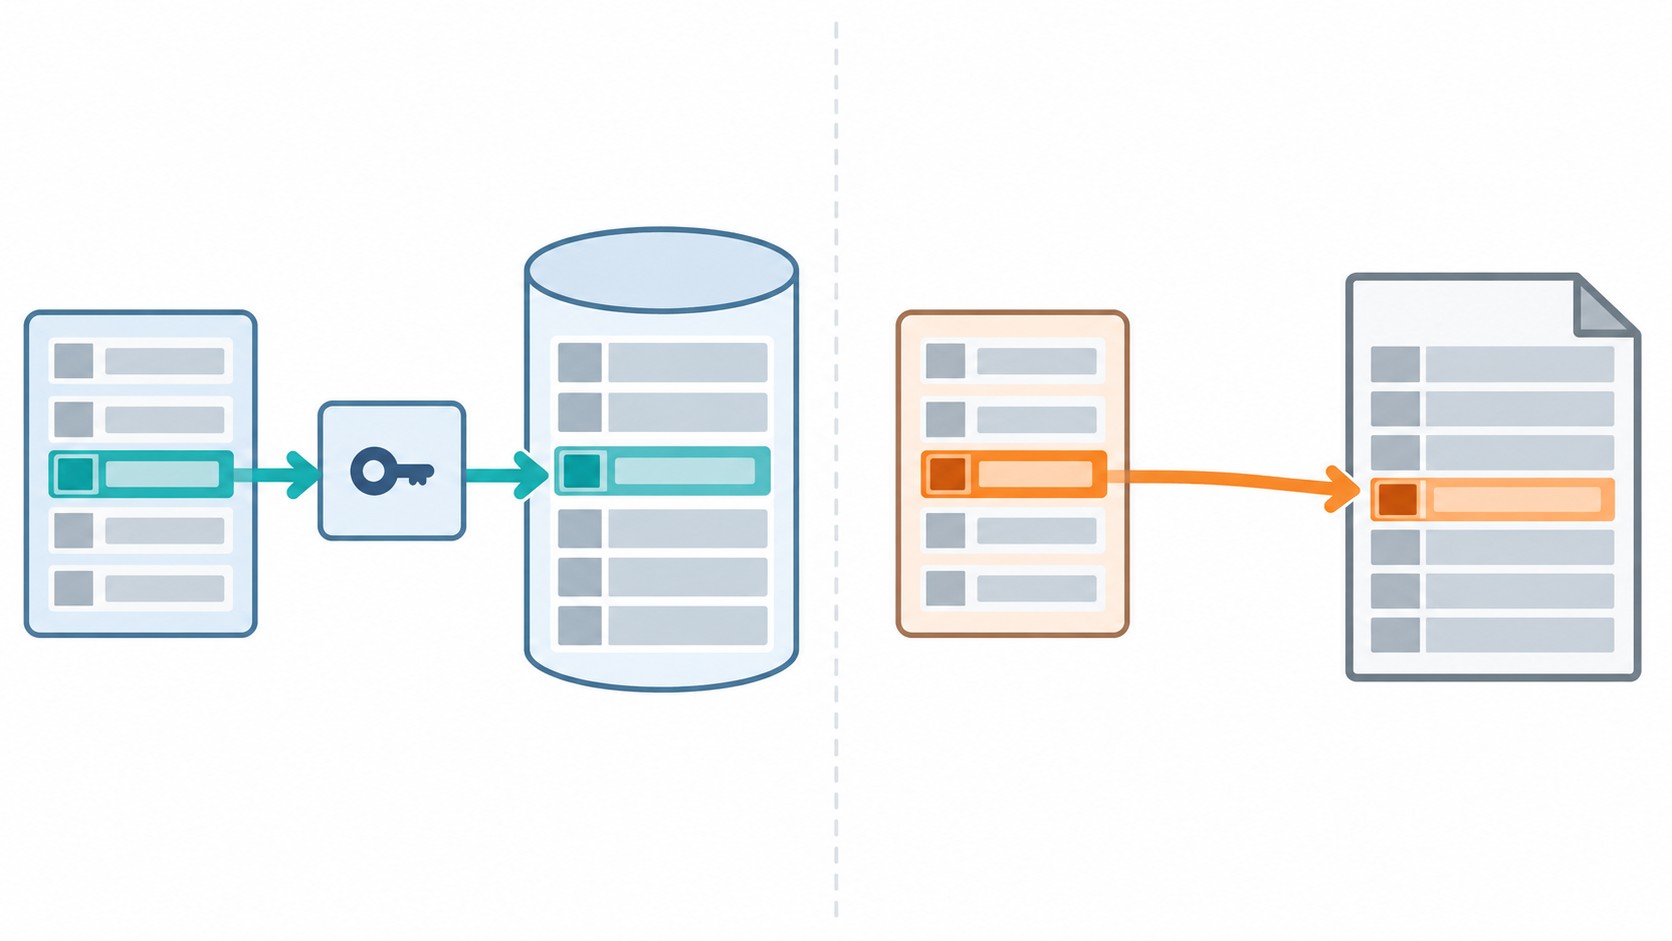
Разница между InnoDB и MyISAM по структуре вторичного индекса существенна. В InnoDB вторичный индекс хранит значение индексируемого столбца плюс указатель на первичный ключ. Чтобы получить строку, СУБД делает два прохода: сначала находит значение во вторичном индексе, затем идёт по первичному индексу к данным. В MyISAM вторичный индекс хранит прямой указатель на физическое расположение строки — один проход. Это влияет на производительность и на стратегию покрывающих индексов, которую разберём ниже.
Типы индексов PostgreSQL — GIN, GiST, BRIN, Hash
PostgreSQL предлагает пять типов, включая специализированные:
| Тип |
Назначение |
Когда использовать |
|---|---|---|
| B-Tree | Стандартные сравнения и сортировка | Дефолт, подходит для большинства запросов |
| GIN | Составные значения: JSONB, массивы, полнотекстовый поиск | Поиск по элементам массива, JSONB-документы |
| GiST | Геоданные, полнотекстовый поиск, диапазонные типы | PostGIS, сложные пользовательские типы |
| BRIN | Большие таблицы с физически упорядоченными данными | Таблицы событий и логов с монотонным ID |
| Hash | Только точное равенство | Специфические сценарии без диапазонов |
Таблица 1 (часть 2). Типы индексов PostgreSQL. Источник: документация PostgreSQL 16.
Отдельное преимущество PostgreSQL — команда EXPLAIN ANALYZE, которая запускает запрос и показывает реальную статистику выполнения, а не только план. Для просмотра всех индексов используется системное представление pg_indexes.
Синтаксис: создание, просмотр и удаление индексов
Работа с индексами сводится к трём операциям: создать, просмотреть существующие и удалить ненужные. Синтаксис незначительно различается между MySQL и PostgreSQL — рассмотрим оба варианта с примерами.
CREATE INDEX и CREATE UNIQUE INDEX
Базовый синтаксис для MySQL:
— Обычный индекс
CREATE INDEX idx_email ON users (email);
— Уникальный индекс
CREATE UNIQUE INDEX idx_email_unique ON users (email);
Синтаксис PostgreSQL идентичен. При создании таблицы PRIMARY KEY генерирует индекс типа PRIMARY автоматически:
CREATE TABLE orders (
id INT PRIMARY KEY, — автоматически создаёт PRIMARY-индекс
user_id INT,
created_at DATETIME
);
Уникальный индекс выполняет двойную функцию: ускоряет поиск и запрещает дублирование значений. При нарушении уникальности СУБД вернёт ошибку Duplicate entry. Создавать отдельный уникальный индекс на первичный ключ — избыточно: PRIMARY KEY уже уникален по определению.
В InnoDB первичный ключ физически кластеризует строки — порядок данных в таблице совпадает с порядком в кластеризованном индексе. Поэтому выбор первичного ключа в InnoDB влияет не только на поиск, но и на физическую организацию хранилища данных.
Составной индекс и правило левого префикса
Составной индекс охватывает два и более столбца:
CREATE INDEX idx_user_date ON orders (user_id, created_at, status);
MySQL строит B-дерево над конкатенацией значений столбцов слева направо. Здесь работает правило левого префикса: оптимизатор движется строго слева и обрывается на первом условии с неравенством.
Как это выглядит для индекса (A, B, C):
| Условие WHERE |
Индекс используется |
Задействованные столбцы |
|---|---|---|
| A = 1 | Да | A |
| A = 1 AND B = 2 | Да | A, B |
| A = 1 AND B = 2 AND C = 3 | Да | A, B, C |
| A = 1 AND B > 5 | Да | A, B (диапазон на B останавливает) |
| A = 1 AND B > 5 AND C = 3 | Частично | A, B (C через индекс не фильтруется) |
| B = 2 | Нет | — |
| B = 2 AND C = 3 | Нет | — |
| A IN (1, 2) AND B = 3 | Да | A, B (IN = множественное равенство) |
IN(список) MySQL расценивает как множественное равенство — индекс продолжает работать за таким условием. BETWEEN — диапазон, и следующий столбец через индекс уже не фильтруется.
Правило порядка столбцов: сначала условия равенства, затем диапазонные. Важен и вопрос дублированных индексов: если уже есть index(A, B), отдельный index(A) избыточен и только нагружает операции записи.
Просмотр и удаление индексов: SHOW INDEX и DROP INDEX
Просмотр всех индексов таблицы в MySQL:
SHOW INDEX FROM orders;
Вывод включает имя индекса, тип, столбцы и кардинальность. В PostgreSQL аналог — системное представление:
SELECT * FROM pg_indexes WHERE tablename = ‘orders’;
Удаление:
— MySQL
DROP INDEX idx_email ON users;
— PostgreSQL (без ON table)
DROP INDEX idx_email;
— Первичный ключ в MySQL
ALTER TABLE users DROP PRIMARY KEY;
Удалять стоит дублирующие, временно созданные и неиспользуемые индексы — они нагружают каждую операцию записи без пользы для чтения.
Покрывающий индекс — запрос целиком из индекса
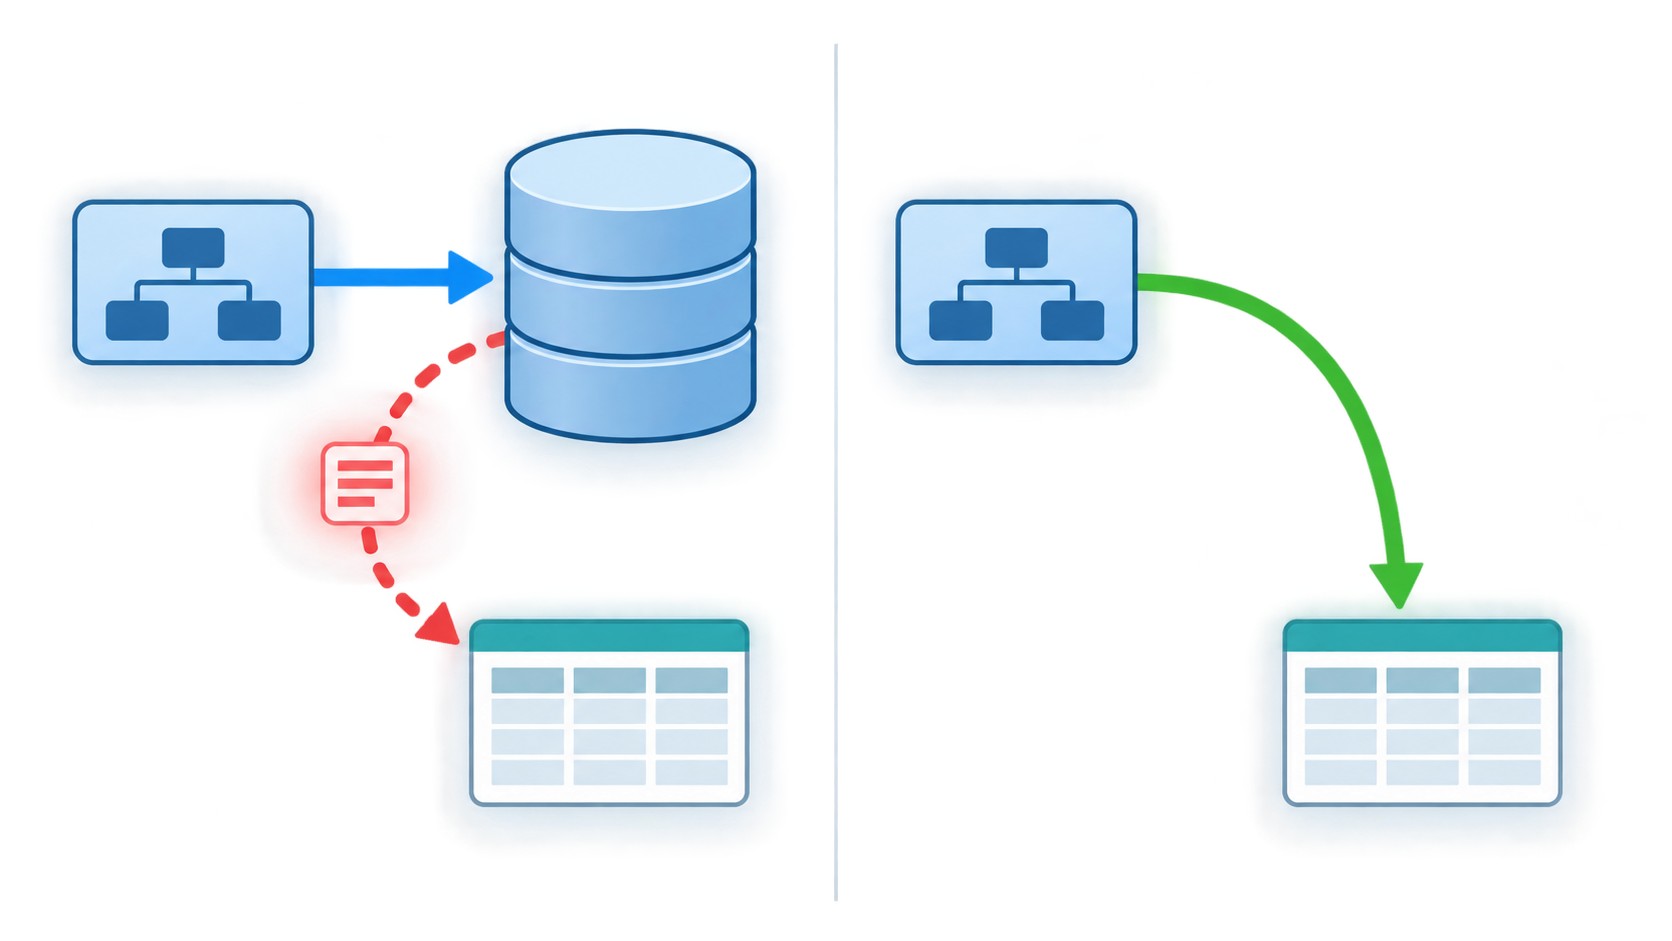
Покрывающий индекс — сценарий, при котором все столбцы из SELECT и WHERE уже содержатся в самом индексе. СУБД получает полный результат без обращения к таблице с данными.
Хотите сменить профессию или повысить квалификацию?
Федеральный проект «Активные меры содействия занятости» даёт возможность пройти обучение бесплатно за счёт государства
- Программы от ведущих вузов России — от 2 месяцев
- Удостоверение или диплом установленного образца
- Центр карьеры: 7 500+ вакансий, помощь с трудоустройством
Почему это быстрее? Индекс компактнее таблицы, чаще помещается в буферный кэш и содержит только нужные значения. Два прохода — вторичный индекс → первичный ключ → таблица — заменяются одним.
Пример:
— Таблица: users(id, email, name, bio, created_at, …)
— Запрос: выбрать email и name по user_id
SELECT email, name FROM users WHERE user_id = 42;
— Если есть индекс (user_id, email, name) — запрос покрывающий:
— СУБД получает ответ целиком из индекса, не обращаясь к строкам таблицы
Диагностика: в выводе EXPLAIN поле Extra содержит Using index без пометки о доступе к таблице — значит, весь запрос прошёл через индекс.
InnoDB-нюанс: вторичные индексы неявно включают значение первичного ключа. Если PK входит в нужный набор столбцов, покрывающий индекс в InnoDB получается компактнее — это стоит учитывать при проектировании.
Команда EXPLAIN — диагностика использования индексов
EXPLAIN показывает план выполнения запроса без его запуска — предположение оптимизатора на основе статистики. В MySQL 8.0+ и PostgreSQL доступна команда EXPLAIN ANALYZE, которая запускает запрос и возвращает реальную статистику: сколько строк прочитано, сколько времени заняли отдельные шаги. В MariaDB аналог появился начиная с версии 10.1.
Добавить EXPLAIN перед любым SELECT — первый шаг при анализе медленных запросов и проверке работы индексов.
Ключевые поля вывода EXPLAIN
Самое важное поле — type. Оно показывает метод доступа к данным от лучшего к худшему:
| Значение type |
Что означает |
|---|---|
| const | Одна строка по уникальному или первичному ключу — оптимально |
| eq_ref | JOIN по уникальному индексу: ровно одна строка с правой таблицы |
| ref | Поиск по неуникальному индексу: несколько строк |
| range | Диапазонный поиск по индексу (BETWEEN, >, <) |
| index | Сканирование всего индекса (покрывающий, но не точечный) |
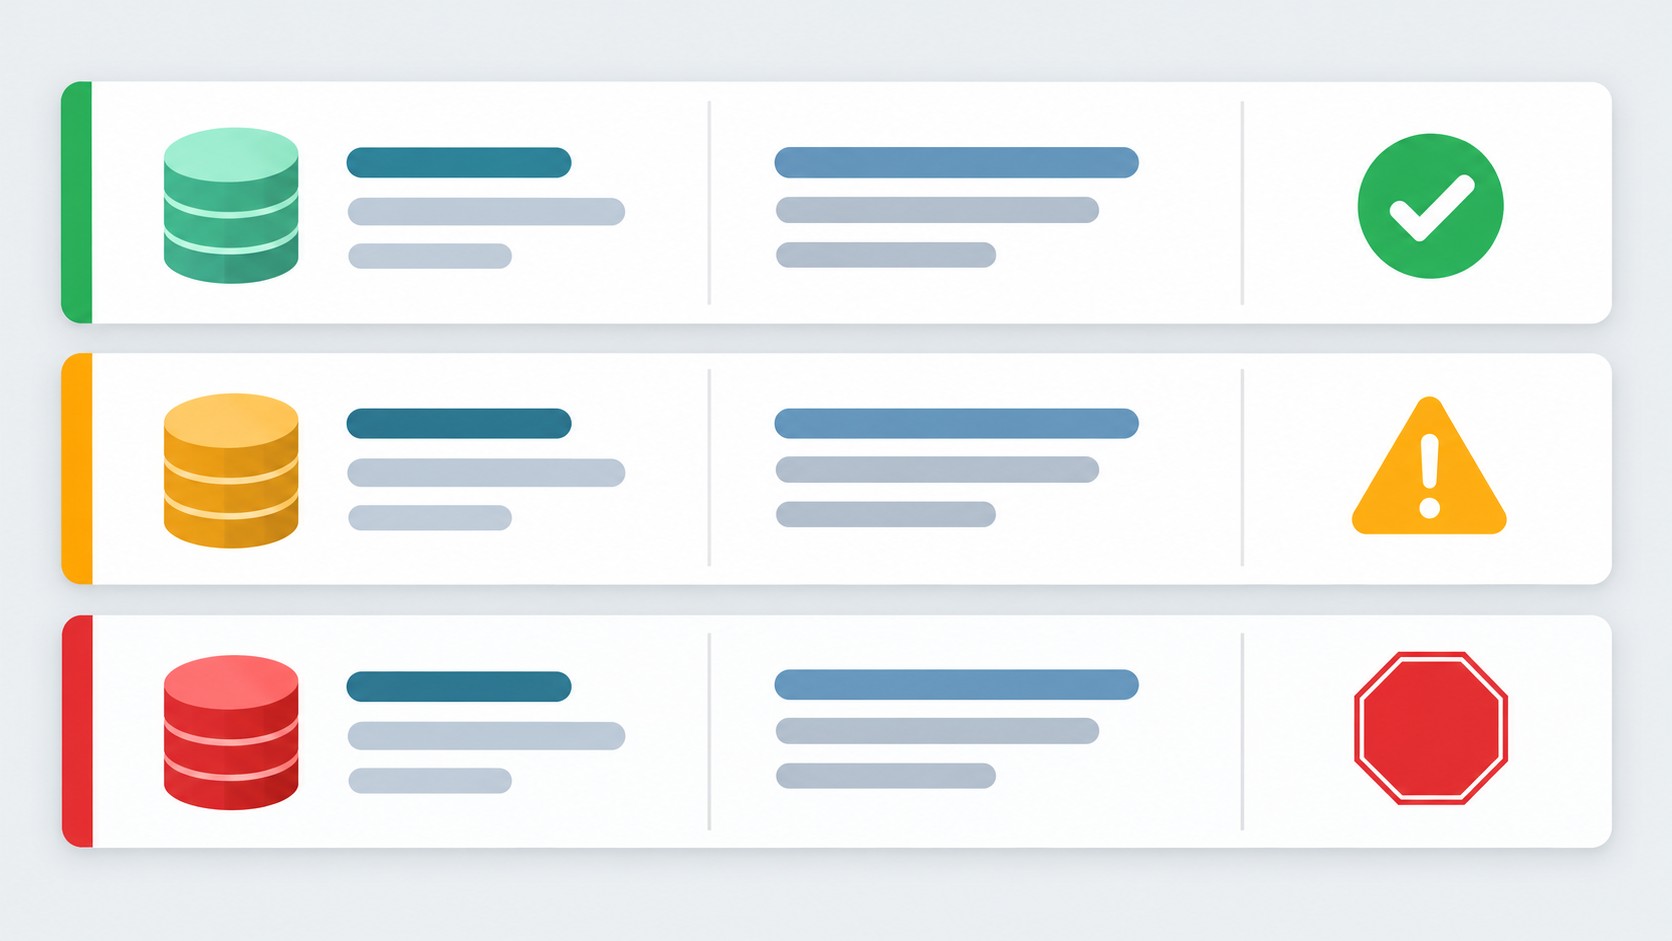
| ALL | Полное сканирование таблицы — сигнал проблемы |
Остальные значимые поля:
- possible_keys — индексы, которые рассмотрел оптимизатор при построении плана запроса.
- key — выбранный индекс; NULL означает, что индекс не используется.
- key_len — сколько байт индекса задействовано: позволяет понять, сколько столбцов составного индекса реально работает.
- rows — оценочное число строк для чтения (прогноз, не точное значение).
- Extra — дополнительные сигналы: Using index (покрывающий индекс — хорошо), Using filesort (файловая сортировка — стоит исправить), Using temporary (временная таблица — запрос стоит оптимизировать).
Когда оптимизатор игнорирует индекс
Есть несколько типичных ситуаций, когда индекс остаётся в стороне.
Выражение в условии. WHERE id + 1 = 3 — оптимизатор вычисляет выражение для каждой строки, индекс не применяется. Правильно: WHERE id = 2.
Пропуск первого столбца составного индекса. WHERE B = 3 при индексе (A, B) — не работает. Первый столбец обязателен по правилу левого префикса.
Несоответствие типов или кодировок. Столбец INT, условие WHERE id = ’42’ — неявное преобразование типа отключает индекс.
Поиск по суффиксу. LIKE ‘%слово’ — полное сканирование таблицы. LIKE ‘слово%’ — индекс работает.
Низкая кардинальность. Столбец «пол» с двумя значениями — оптимизатор сочтёт полный скан выгоднее.
Антипаттерн ORDER BY rand(). MySQL копирует все данные и выполняет дополнительную сортировку — сканирование индекса не спасает, медленные запросы гарантированы при любом объёме таблицы.
Обратная сторона индексов — когда они вредят
При каждом INSERT, UPDATE или DELETE СУБД обновляет все индексы таблицы. Пять индексов — минимум шесть операций записи вместо одной. Замедление операций записи растёт пропорционально числу индексов, и на write-heavy таблицах это становится узким местом.
Дисковый overhead: индекс — отдельная структура данных, она занимает место. Дублированные индексы MySQL не выявляет автоматически — нужно проверять через SHOW INDEX и искать пересекающиеся наборы столбцов.
Фрагментация индекса и обслуживание
Частые операции INSERT, UPDATE и DELETE приводят к фрагментации B-дерева: в структуре появляются незаполненные блоки, дерево перестаёт быть оптимально сбалансированным, скорость поиска постепенно снижается.
Решение — перестроение индекса:
— InnoDB: перестройка через OPTIMIZE TABLE
OPTIMIZE TABLE orders;
— Альтернатива (эквивалент REBUILD)
ALTER TABLE orders ENGINE=InnoDB;
После значительных изменений данных — массовых загрузок или удалений — стоит обновить статистику для оптимизатора:
ANALYZE TABLE orders;
Устаревшая статистика приводит к неоптимальным планам запросов: оптимизатор может выбрать индекс там, где выгоднее полное сканирование, и наоборот. Регулярный просмотр лога медленных запросов (slow query log) помогает заметить деградацию производительности до того, как она станет критической.
Практические рекомендации — когда и как создавать индексы
Хороший индекс — баланс между скоростью чтения и стоимостью записи. Несколько проверенных ориентиров для индексирования баз данных:
- Индексировать столбцы из WHERE, JOIN, ORDER BY и GROUP BY. Это основные точки нагрузки при поиске и сортировке данных.
- Проверять кардинальность. Высокая (ID, email, UUID) → индекс эффективен. Низкая (пол, boolean, статус с тремя значениями) → оптимизатор, скорее всего, выберет полное сканирование.
- В составном индексе: сначала равенства, затем диапазоны. Неравенство останавливает использование индекса для следующих столбцов — учитывайте это при проектировании.
- Индексировать внешние ключи. JOIN по FK без индекса — гарантированное полное сканирование правой таблицы.
- Не создавать лишних индексов. Каждый дополнительный замедляет INSERT/UPDATE/DELETE. Избыточное индексирование — распространённая причина деградации производительности на write-heavy таблицах.
- Проверять дублирование. index(A) лишний при наличии index(A, B) — первый можно удалить без потери для запросов.
- Анализировать через EXPLAIN до попадания на продакшн. Смотрите на type, key, rows и Extra — план запроса до внедрения позволяет избежать сюрпризов в бою.
- Тестировать на данных, близких к реальным. Оптимизатор строит план по статистике: на тестовой таблице с десятью строками он всегда предпочтёт Full Table Scan, даже если на реальной таблице нужен индекс.
Оптимизация индексов в MySQL — не разовая задача, а непрерывный процесс. Паттерны нагрузки меняются, данные растут, планы запросов устаревают. Регулярный просмотр медленных запросов и анализ через EXPLAIN — часть нормального цикла обслуживания базы данных.
Часто задаваемые вопросы
Что такое индекс в MySQL и зачем он нужен?
Индекс в MySQL — структура данных (обычно B-дерево), которая хранит отсортированные копии значений столбцов и указатели на строки таблицы. Без индекса СУБД перебирает каждую строку (полное сканирование таблицы). С индексом оптимизатор находит нужные данные за O(log n) — это критично на таблицах с миллионами записей.
Как создать индекс в MySQL?
Базовая команда: CREATE INDEX имя ON таблица (столбец). Для уникального: CREATE UNIQUE INDEX. Для составного: CREATE INDEX idx ON orders (user_id, created_at). При создании таблицы PRIMARY KEY автоматически создаёт индекс типа PRIMARY — дублировать его вручную не нужно.
Что такое правило левого префикса в составном индексе?
MySQL использует составной индекс строго слева направо. Индекс на (A, B, C) работает для WHERE A=… и WHERE A=… AND B=…, но не для WHERE B=… без A. Индекс прекращает работу на первом условии с неравенством — следующие столбцы через индекс не фильтруются.
Как проверить, что запрос использует индекс?
Добавьте EXPLAIN перед SELECT. Поле key — выбранный индекс (NULL = не используется). Поле type: ALL — полный скан (плохо), const/eq_ref — оптимально. Extra: Using index означает покрывающий индекс — лучший сценарий: данные получены без обращения к таблице.
В чём разница между B-Tree и Hash-индексом?
B-дерево поддерживает сравнения (<, >, BETWEEN), диапазоны и ORDER BY — универсальный тип по умолчанию. Hash-индекс работает только для точного равенства и не поддерживает диапазоны и сортировку. В InnoDB Hash-индекс адаптивный — создаётся автоматически, задать явно нельзя.
Почему индексы замедляют INSERT и UPDATE?
При изменении строки СУБД обновляет все индексы таблицы. Пять индексов — минимум шесть операций записи вместо одной. На таблицах с интенсивной записью избыточное индексирование создаёт серьёзные накладные расходы и заметно снижает общую производительность.
Когда оптимизатор игнорирует индекс?
Индекс не используется в случаях: условие — выражение (WHERE id+1=3); пропущен первый столбец составного индекса; несоответствие типов или кодировок; поиск по суффиксу (LIKE ‘%слово’); низкая кардинальность столбца — оптимизатор предпочтёт полное сканирование. Проверяйте через EXPLAIN.
Что означает Using filesort в EXPLAIN?
Using filesort в поле Extra — MySQL не смог упорядочить результат через индекс и выполняет дополнительный проход сортировки в памяти или на диске. Сигнал проблемы при ORDER BY на больших таблицах. Решение: добавить индекс на столбцы ORDER BY, совместимый с условиями WHERE.
Как удалить индекс в MySQL и PostgreSQL?
MySQL: DROP INDEX имя ON таблица;. PostgreSQL: DROP INDEX имя; (без указания таблицы). Первичный ключ в MySQL удаляется через ALTER TABLE … DROP PRIMARY KEY. Удаляйте дублирующие и неиспользуемые индексы — они нагружают операции записи без пользы для чтения.
Что такое фрагментация индекса и как с ней бороться?
Частые INSERT/UPDATE/DELETE создают разрывы в структуре B-дерева — индекс фрагментируется и теряет эффективность. Решение: OPTIMIZE TABLE (InnoDB) или ALTER TABLE … ENGINE=InnoDB для перестроения индекса. После значимых изменений данных запускайте ANALYZE TABLE — чтобы обновить статистику для оптимизатора запросов.
Подайте заявку —
забронируйте место в группе
45 000 мест на 2026 год. Бесплатное обучение по федеральному проекту «Активные меры содействия занятости»
- Онлайн
- От 2 месяцев
- Бесплатно
- Диплом