Статистика для аналитика данных: что нужно знать и уметь
Статистика для аналитика данных — не высшая математика и не теория вероятностей в полном объёме. Это конкретный набор инструментов: описательная статистика, разведочный анализ данных и проверка статистических гипотез. Освоив эти три блока, вы сможете обосновывать бизнес-решения, запускать A/B-тесты и работать с реальными данными. Дата-сайентисту нужен матанализ — аналитику данных нет. Статья разбирает каждый блок по существу: методы, инструменты, типичные ошибки и план изучения.
Что такое статистика и зачем она аналитику данных
Статистика — набор методов для ответа на вопросы о данных: есть ли разница между группами, насколько она значима, что изменится, если скорректировать продукт. Без статистики анализ превращается в интерпретацию таблиц «на глаз».
Учитесь бесплатно за счёт государства
Экономия до 100 000 ₽ на любой программе
Практические задачи, где статистический анализ данных критичен:
- A/B-тесты продуктовых гипотез;
- поиск аномалий в ключевых метриках;
- прогнозирование спроса;
- сегментация пользователей.
Статистика и аналитика связаны напрямую: инструменты дисциплины используются ежедневно при работе с любым датасетом. Весь анализ делится на два больших раздела.
Описательная и выводящая статистика — два раздела одной дисциплины
Описательный анализ данных резюмирует то, что уже есть в выборке: среднее, медиана, стандартное отклонение превращают тысячи строк в несколько понятных чисел.
Выводящая (инференциальная) статистика идёт дальше — распространяет выводы с выборки на всю генеральную совокупность. Здесь появляются гипотезы, p-value и доверительные интервалы.
Пример. Среднее время доставки по 10 000 заказам — 47 минут. Это описательная статистика: факт о данных. Вывод о том, почему клиенты, получившие заказ быстрее 30 минут, чаще возвращаются, — выводящий: требует проверки гипотезы и теста.
Оба раздела дополняют друг друга: описательный этап всегда предшествует выводящему.
Разведочный анализ данных (EDA): первый этап любого анализа
Разведочный анализ данных (EDA, Exploratory Data Analysis) — начальный этап работы с данными до построения гипотез и моделей. EDA отвечает на вопрос: «Что вообще здесь происходит?»
Три цели EDA:
- понять структуру и типы данных;
- найти пропуски, дубли и выбросы;
- сформулировать гипотезы для дальнейшей проверки.
EDA предшествует выбору метода анализа. Пропустить его — значит строить выводы на грязных или неправильно понятых данных.
Инструменты EDA: визуализации и анализ распределений
Гистограмма показывает форму распределения и разброс значений. Если гистограмма времени доставки имеет длинный правый хвост — часть заказов опаздывает заметно больше нормы. Это сигнал к поиску причины.
Диаграмма рассеяния (scatter plot) визуализирует связь между двумя числовыми переменными. По ней видно: линейная связь, кластеры, выбросы.
Box plot отображает медиану, квартили и выбросы одновременно. Удобен для сравнения нескольких групп — например, времени загрузки страницы на iOS против Android.
Тепловая карта (heatmap) показывает попарные корреляции между переменными — незаменима при первичном отборе признаков.
Q-Q plot (quantile-quantile plot) проверяет нормальность: если точки лежат вдоль диагонали — распределение близко к нормальному. Это важно перед применением параметрических тестов.
Нормализация и стандартизация данных нужны, когда переменные имеют разные масштабы, — особенно при подготовке признаков для алгоритмов машинного обучения.
Описательные статистики: от тысяч строк к понятным числам
Основы статистического анализа начинаются именно здесь. Описательная статистика сводит массив наблюдений к нескольким ключевым показателям — это первое, что смотрит аналитик данных, открывая новый датасет.
Показатели делятся на два блока:
- меры центральной тенденции — где сосредоточены значения;
- меры разброса — насколько значения отличаются друг от друга.
Среднее, медиана, мода — меры центральной тенденции
Среднее (mean) — сумма всех значений, делённая на количество. Чувствительно к выбросам: один нетипично крупный чек «перекашивает» результат вверх.
Медиана — значение в середине отсортированного ряда. Устойчива к выбросам и лучше отражает «типичного» пользователя при скошенных распределениях.
Мода — наиболее часто встречающееся значение. Полезна для категориальных данных: самый популярный регион, наиболее частая категория покупки.
Кейс: средний чек интернет-магазина — 2 500 ₽, а медиана — 800 ₽. Распределение скошено вправо несколькими крупными покупками. Что такое мода и медиана в статистике применительно к этому случаю? Медиана точнее описывает поведение большинства покупателей — и именно её стоит использовать в отчёте.
Меры разброса: дисперсия, стандартное отклонение, IQR и перцентили
Дисперсия — средний квадрат отклонения значений от среднего. Высокая дисперсия означает большой разброс данных.
Стандартное отклонение (std) — квадратный корень из дисперсии, выражается в единицах исходных данных и интерпретируется нагляднее.
IQR (межквартильный размах) = Q3 − Q1. Устойчив к выбросам, поскольку охватывает средние 50% данных. Медиана и квартили в статистике — рабочий инструмент при анализе любых скошенных выборок.
Перцентили P90, P95, P99 критичны для анализа времени отклика систем и чеков: «99% заказов обрабатывается менее чем за 3 секунды».
Правило выбора: данные с выбросами — медиана и IQR; нормально распределённые данные — среднее и std.
Статистические распределения и центральная предельная теорема
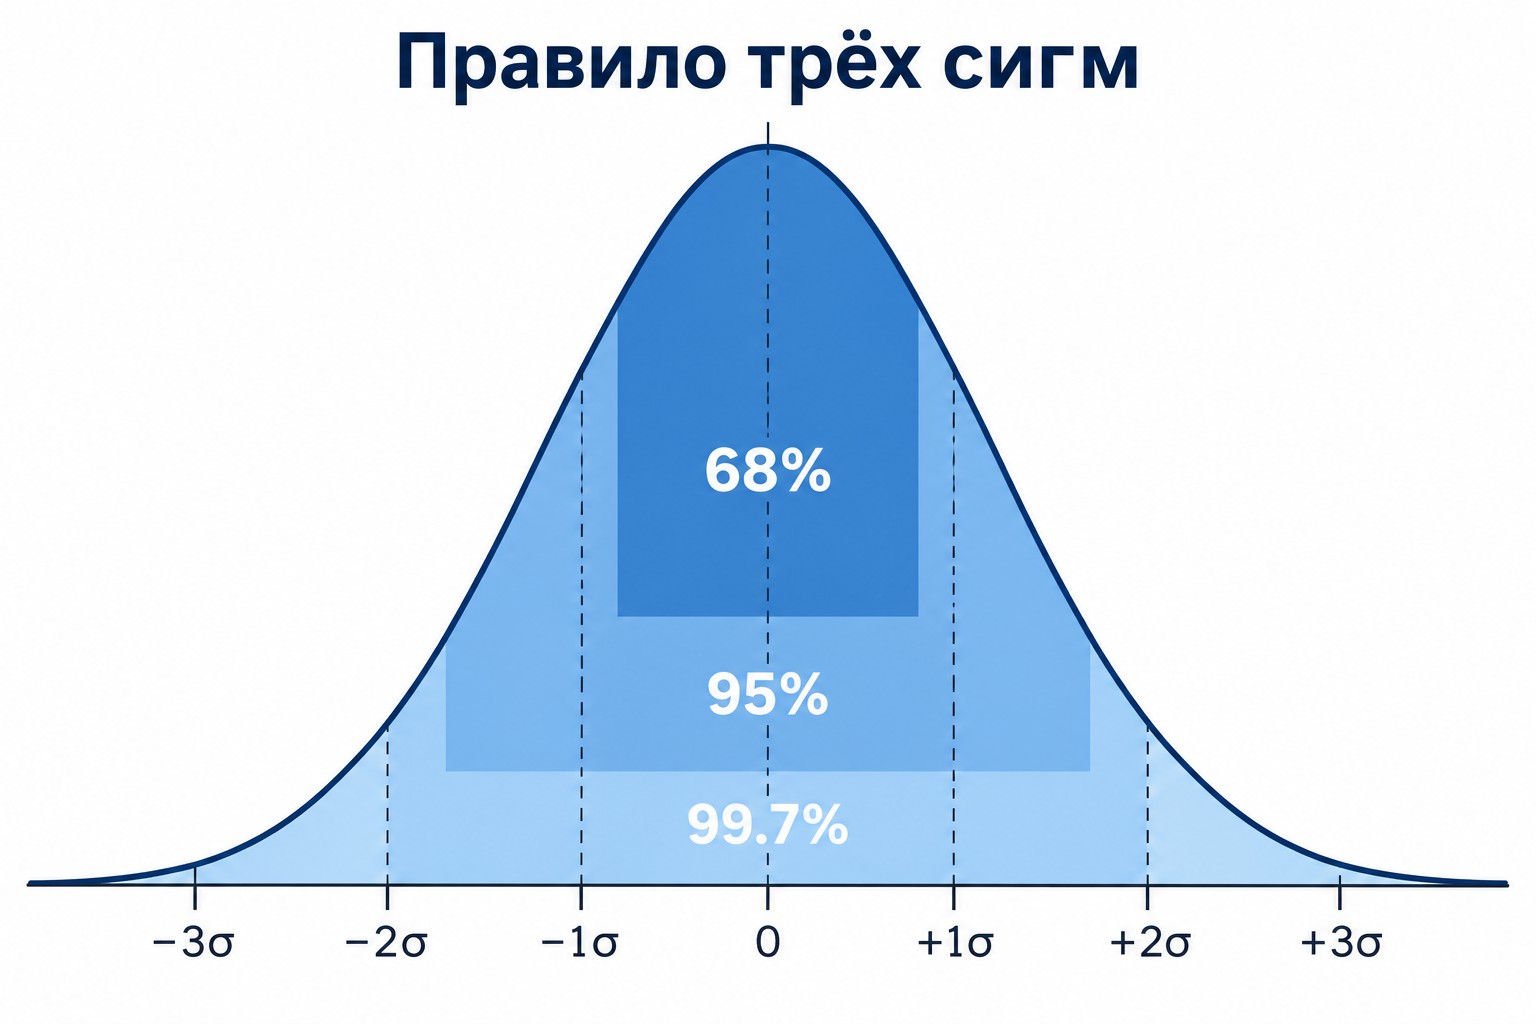
Понимание распределений — основа статистики для data science. Нормальное распределение (колокол) описывается двумя параметрами: μ (математическое ожидание) и σ (стандартное отклонение). Правило трёх сигм: 68% значений попадают в диапазон μ ± σ, 95% — в μ ± 2σ, 99,7% — в μ ± 3σ. Большинство параметрических тестов предполагают нормальность данных.
Биномиальное распределение описывает число успехов в n независимых испытаниях. Пример: из 1 000 посетителей 32 совершили покупку — конверсия p = 0,032 следует биномиальному закону.
Распределение Пуассона моделирует число событий за фиксированный период: заказы за час, ошибки сервиса в сутки.
Центральная предельная теорема (ЦПТ): при достаточно большой выборке (n > 30) выборочное среднее стремится к нормальному распределению — независимо от формы исходного. Это делает z-тест и t-тест применимыми к данным любой природы.
Если тема аналитики данных интересует вас как направление для развития, в рамках нацпроекта «Кадры» можно пройти программу «Специалист по аналитике и базам данных в информационных системах» — 72 часа, с нуля, бесплатно за счёт государства.
Проверка статистических гипотез: алгоритм и ключевые понятия
Проверка гипотез — формальный способ понять, случайна ли наблюдаемая разница или за ней стоит реальный эффект.
Любой тест строится на двух гипотезах:
- H0 (нулевая) — нет эффекта, разница случайна;
- H1 (альтернативная) — эффект есть.
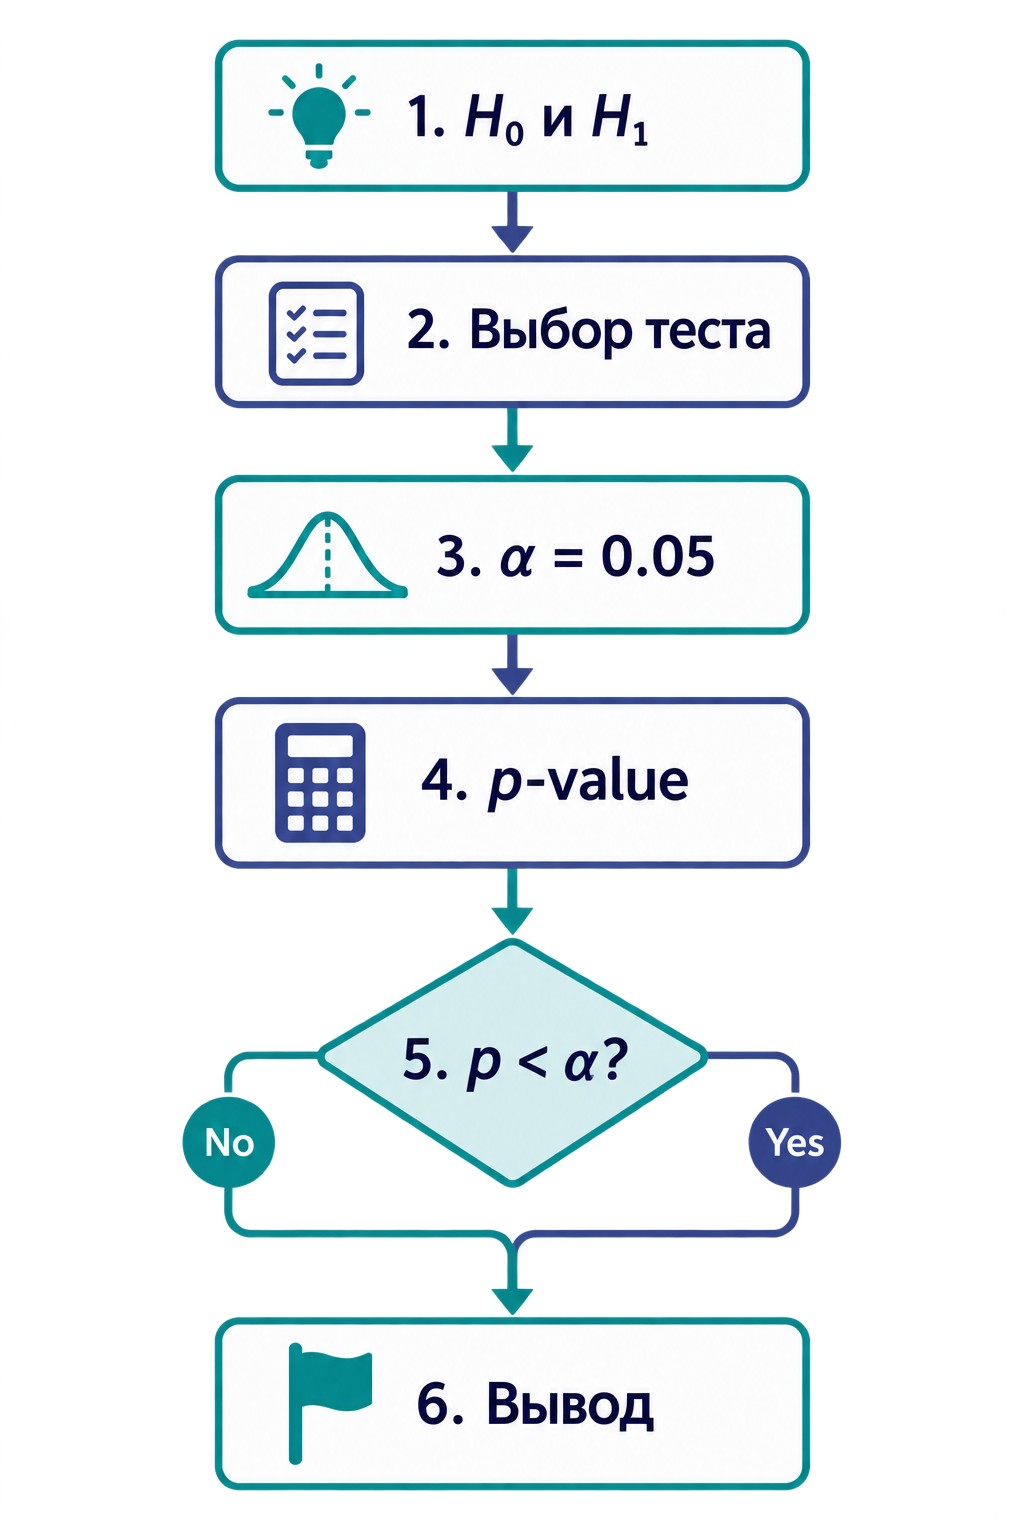
Уровень значимости α = 0,05 — порог, при котором мы готовы ошибиться в 5% случаев.
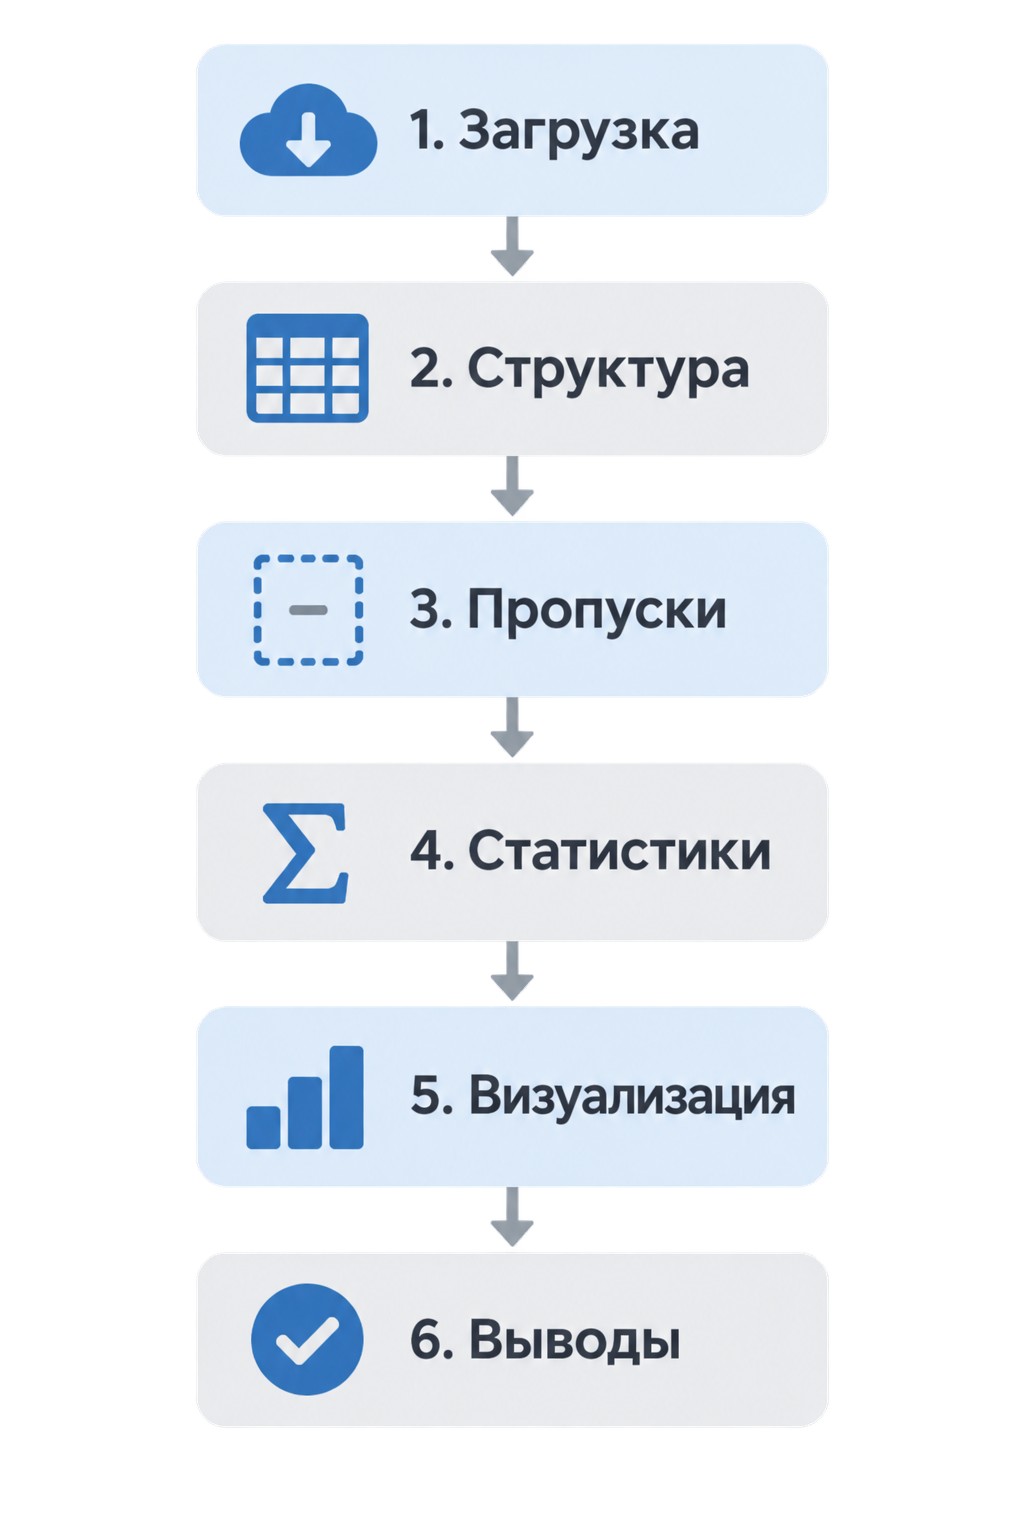
Алгоритм из шести шагов: сформулировать H0 и H1 → выбрать тест → задать α → рассчитать p-value → сравнить с α → оценить размер эффекта.
P-value и доверительный интервал: что на самом деле показывают
P-value — вероятность получить наблюдаемую разницу (или более экстремальную), если нулевая гипотеза верна. Это не вероятность того, что H0 верна, — распространённое заблуждение.
Частая ошибка: p < 0,05 автоматически означает «важный для бизнеса эффект». Статистическая значимость и практическая значимость — разные вещи. При очень большой выборке даже ничтожное различие даст p < 0,05.
Доверительный интервал (CI 95%) показывает диапазон, в котором с вероятностью 95% находится истинное значение параметра. Например: конверсия лендинга 3,5%, CI = [3,1%; 3,9%]. Это информативнее, чем одна точечная оценка.
Рабочая связка аналитика: p-value + доверительный интервал + размер эффекта. Только вместе они дают полную картину результата.
Ошибки I и II рода и мощность теста
Хотите сменить профессию или повысить квалификацию?
Федеральный проект «Активные меры содействия занятости» даёт возможность пройти обучение бесплатно за счёт государства
- Программы от ведущих вузов России — от 2 месяцев
- Удостоверение или диплом установленного образца
- Центр карьеры: 7 500+ вакансий, помощь с трудоустройством
При проверке гипотезы возможны два типа ошибок.
Ошибка I рода (α) — отвергли H0, хотя она верна: «обнаружили» эффект, которого нет. Вероятность этой ошибки и есть уровень значимости α = 0,05.
Ошибка II рода (β) — не отвергли H0, хотя она ложна: «не заметили» реальный эффект. Это ложноотрицательный результат.
Мощность теста = 1 − β — вероятность обнаружить реальный эффект, если он существует. Стандарт: мощность ≥ 80% при α = 0,05.
Взаимозависимость: снижение α уменьшает риск ошибки I рода, но повышает риск ошибки II рода. Единственный способ снизить оба риска одновременно — увеличить размер выборки. Это фундаментальное ограничение, которое нельзя обойти.
Навигатор по статистическим тестам: как выбрать метод
Выбор теста зависит от типа данных, числа групп и выполнения условий нормальности. Это один из ключевых навыков — виды статистических методов нужно уметь сопоставлять с конкретной задачей.
Параметрические тесты работают при нормальном распределении и отсутствии выбросов. Непараметрические методы — когда эти условия не выполняются: данные сильно скошены, выборка мала или содержит влиятельные выбросы.
Логика выбора: тип данных → число сравниваемых групп → есть ли выбросы или нарушение нормальности?
| Задача |
Параметрический метод |
Непараметрический аналог |
|---|---|---|
| Сравнение двух числовых групп | t-тест | критерий Манна-Уитни |
| Сравнение трёх и более групп | ANOVA | критерий Краскела-Уоллиса |
| Сравнение пропорций (конверсий) | Z-тест | — |
| Связь категориальных переменных | — | критерий хи-квадрат |
Практическое правило: если в данных есть выбросы или нормальность нарушена — используйте непараметрические статистические методы исследования данных. При n > 30 и симметричном распределении параметрические тесты дают более точные результаты.
A/B-тестирование: от гипотезы до бизнес-решения
A/B-тестирование — рандомизированный эксперимент, в котором пользователи случайно делятся на контрольную и экспериментальную группы. Разница показателей проверяется статистическим тестом.
Этапы дизайна:
- Сформулировать H0 и H1.
- Рассчитать необходимый размер выборки — обязательно до запуска.
- Рандомизировать пользователей по группам.
- Собрать данные за заданный период.
- Провести тест: z-тест для конверсий, t-тест для средних (чек, время сессии).
- Оценить результат и метрики-ограничители (guardrail-метрики).
Guardrail-метрики — показатели, которые не должны ухудшиться при росте целевой метрики: рост конверсии не должен снижать средний чек или ухудшать удержание (retention) пользователей.
Пример кейса: конверсия выросла с 2,0% до 2,1%, p = 0,03. Результат статистически значим. Но прирост составляет 0,1 п.п. — 5% в относительных единицах. Следующий вопрос: окупятся ли затраты на внедрение? Смотрим guardrail-метрики — NPS, средний чек, отток — и только потом принимаем решение.
Статистика для аналитика данных в A/B-тесте — это не просто p-value, а связка: размер эффекта + доверительный интервал + guardrail-метрики.
Корреляция и причинно-следственная связь: ключевое различие
Корреляция измеряет статистическую связь между двумя переменными.
Корреляция Пирсона — линейная связь, принимает значения от −1 до +1. Применима при нормальном распределении и отсутствии сильных выбросов.
Корреляция Спирмена — ранговая, устойчива к выбросам и нелинейным зависимостям. Используется, когда данные не удовлетворяют условиям Пирсона.
Корреляция не подразумевает причинности — одно из ключевых правил в работе со статистикой.
Бизнес-пример: пользователи, которые видели блок с рекомендациями, в среднем делают более дорогие заказы. Но это не значит, что блок увеличивает чек. Возможно, активные пользователи и так больше тратят — и чаще прокручивают страницу до рекомендаций. Чтобы установить причинно-следственную связь, нужен A/B-тест с рандомизацией показа блока.
Корреляционный анализ — хороший инструмент для генерации гипотез. Для проверки причинности одной корреляции недостаточно.
Типичные ошибки аналитика при работе со статистикой
Шесть ошибок, которые встречаются даже у опытных специалистов:
- Пропустить EDA и сразу перейти к тестам — пропуски и выбросы исказят любой результат.
- Опираться только на среднее, игнорируя медиану и IQR — при скошенных распределениях среднее вводит в заблуждение.
- Удалять все выбросы без анализа их природы — часть выбросов несёт важную информацию о реальных событиях.
- Принимать корреляцию за причинность — без рандомизации вывод о причинности не обоснован.
- Смотреть только на p-value без оценки размера эффекта — статистически значимый результат может быть практически незначимым.
- Обобщать выводы за пределы изученной выборки — результаты релевантны только для той аудитории, которая участвовала в анализе.
Как освоить статистику: план на 4 недели
Для чего нужны статистические методы — понятно. Вопрос в том, как их освоить без перегрузки. Эффективнее работает нисходящий подход: от реальной задачи — к методу — к формуле, а не наоборот.
- Неделя 1: описательная статистика, типы распределений.
- Неделя 2: проверка гипотез, ошибки I и II рода, p-value.
- Неделя 3: доверительные интервалы, расчёт размера выборки, дизайн A/B-теста.
- Неделя 4: множественные сравнения, корреляция против причинности, введение в байесовский подход.
Параллельно — практика на реальных датасетах. Концепции важнее синтаксиса на собеседовании.
Минимум по уровням и Python-инструменты
Junior: среднее, медиана, стандартное отклонение, нормальное распределение — достаточно для первичного анализа данных.
Middle: + проверка гипотез, A/B-тесты, доверительные интервалы — уровень продуктового аналитика.
Senior: + байесовский подход, регрессионный анализ, причинность (causal inference) — уровень старшего аналитика.
Инструменты Python для статистики:
- scipy.stats.ttest_ind — t-тест для сравнения двух групп;
- scipy.stats.norm — работа с нормальным распределением;
- statsmodels.formula.api — регрессионные модели и ANOVA.
Excel тоже применим: функции T.TEST и NORM.DIST закрывают базовые задачи. Какая математика нужна аналитику данных — вопрос уровня и специализации, но понимание методов всегда важнее знания синтаксиса.
Часто задаваемые вопросы
Аналитика данных и статистика — в чём разница?
Статистика — математическая дисциплина, набор методов. Аналитика данных — прикладная деятельность: аналитик использует статистику вместе с SQL, Python и инструментами визуализации для обоснования бизнес-решений. Статистика предоставляет инструменты — аналитик применяет их к конкретным задачам.
Что такое мода и медиана в статистике, чем они отличаются?
Медиана делит упорядоченный ряд пополам — устойчива к выбросам и лучше отражает «типичного» пользователя. Мода — наиболее часто встречающееся значение; полезна для категориальных данных. При скошенных распределениях — доходах, чеках — медиана информативнее среднего.
Когда p-value недостаточно для вывода?
Когда эффект статистически значим, но мал по размеру. Конверсия выросла с 2,0% до 2,1% при p = 0,03: результат реален, но прирост — 0,1 п.п. Всегда оценивайте доверительный интервал, размер эффекта и guardrail-метрики: окупятся ли затраты на внедрение?
Что такое мощность теста?
Мощность = 1 − β — вероятность обнаружить реальный эффект, если он существует. Стандарт: ≥ 80% при α = 0,05. Чем больше выборка, тем выше мощность. Размер выборки рассчитывается до запуска A/B-теста — иначе рискуете не заметить реальный эффект (ошибка II рода).
Как проверить, нормально ли распределены данные?
Три способа. Визуальный: гистограмма — симметричный колокол? Графический: Q-Q plot — точки вдоль диагонали? Статистический: тест Шапиро-Уилка. При большой выборке (n > 200) статистические тесты часто отвергают нормальность при незначительных отклонениях — ориентируйтесь на Q-Q plot.
Нужна ли аналитику данных высшая математика?
Нет. Для работы и собеседований достаточно базовой статистики: меры тенденции, распределения, проверка гипотез, доверительные интервалы. Линейная алгебра и матанализ — область дата-сайентиста и инженера по машинному обучению. Главное — понимать, когда и какой метод применять.
Что такое смещение выборки и почему это проблема?
Смещение выборки — систематическое отклонение выборки от генеральной совокупности. Пример: анализ только активных пользователей приложения исказит выводы, если нужно описывать всю аудиторию. Смещённая выборка ведёт к неправильным обобщениям. Репрезентативность обеспечивает случайный отбор.
Как статистика связана с машинным обучением?
Статистика — основа алгоритмов классификации и регрессии в машинном обучении. Аналитику данных знать алгоритмы необязательно: достаточно понимать метрики оценки моделей, переобучение и проверку гипотез для A/B-тестов новых функций продукта.
Подайте заявку —
забронируйте место в группе
45 000 мест на 2026 год. Бесплатное обучение по федеральному проекту «Активные меры содействия занятости»
- Онлайн
- От 2 месяцев
- Бесплатно
- Диплом